问题
从一篇 300 词的文章中提取 Apple Inc. 的每一处提及。文章写「Apple」时很容易。写「the company」「they」「Cupertino's technology giant」或「Jobs's firm」时就难了。如果不把这些提及归到同一个实体,你的 NER pipeline 会漏掉 60-80% 的提及。
共指消解把指向同一现实实体的所有表达式链接成一个簇。它是表层 NLP(NER、句法分析)与下游语义(IE、QA、摘要、KG)之间的胶水。
为什么它在 2026 年重要:
- 摘要:「CEO 宣布……」与「Tim Cook 宣布……」—— 摘要应该点名 CEO。
- 问答:「她给谁打了电话?」需要消解「她」。
- 信息抽取:知识图谱里把「PER1 创立了 Apple」和「Jobs 创立了 Apple」当作两条独立条目,是错的。
- 多文档 IE:跨越多篇文章合并同一事件的提及,就是跨文档共指。
概念
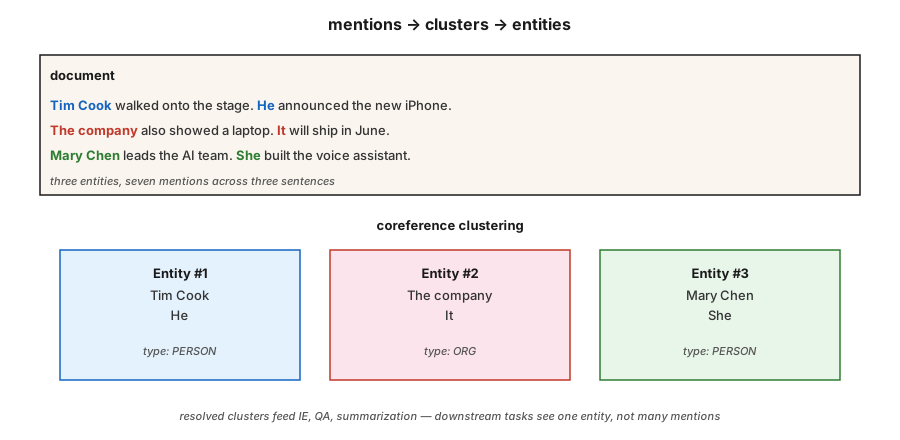
任务。 输入:一篇文档。输出:对提及(span)的聚类,每个簇指向一个实体。
提及类型。
- 命名实体。「Tim Cook」
- 名词性指称。「the CEO」「the company」
- 代词性指称。「he」「she」「they」「it」
- 同位语。「Tim Cook, Apple's CEO,」
架构。
- 基于规则(Hobbs, 1978)。 使用语法规则,基于句法树做代词消解。不错的基线。在代词上出奇地难以击败。
- 提及对分类器。 对每一对提及 (m_i, m_j),预测它们是否共指。按传递闭包聚类。2016 年以前的标准做法。
- 提及排序。 对每个提及,给候选先行语(包括「无先行语」)排序。取最高者。
- 基于 span 的端到端(Lee et al., 2017)。 Transformer 编码器。枚举长度上限内的所有候选 span。预测提及得分。为每个 span 预测先行语概率。贪心聚类。现代默认做法。
- 生成式(2024+)。 提示 LLM:「列出文中每个代词及其先行语。」在简单案例上效果不错,在长文档和罕见指称对象上吃力。
评估指标。 有五种标准指标(MUC、B³、CEAF、BLANC、LEA),因为没有单一指标能完整刻画聚类质量。报告前三个的平均值作为 CoNLL F1。2026 年在 CoNLL-2012 上的最优结果约为 83 F1。
公认的难题。
- 指称前几页才引入的实体的定指描述。
- 桥接指代(「the wheels」→ 前面提到的一辆车)。
- 汉语、日语等语言中的零形指代。
- 后指(代词在指称对象之前):「When she walked in, Mary smiled.」
构建它
第 1 步:预训练神经共指模型(AllenNLP / spaCy-experimental)
pythonimport spacy
nlp = spacy.load("en_coreference_web_trf") # experimental model
doc = nlp("Apple announced new products. The company said they would ship soon.")
for cluster in doc._.coref_clusters:
print(cluster, "->", [m.text for m in cluster])在更长的文档上,你会得到类似这样的结果:
- 簇 1:[Apple, The company, they]
- 簇 2:[new products]
第 2 步:基于规则的代词消解器(教学用)
见 code/main.py 中仅用标准库的实现:
- 提取提及:命名实体(首字母大写的 span)、代词(查字典)、定指描述(「the X」)。
- 对每个代词,查看前面 K 个提及,并按以下标准打分:
- 性/数一致(启发式)
- 就近程度(越近越优先)
- 句法角色(优先主语)
- 链接得分最高的先行语。
它无法与神经模型竞争。但它展示了搜索空间,以及端到端模型必须做出的决策。
第 3 步:用 LLM 做共指消解
pythonprompt = f"""Text: {text}
List every pronoun and noun phrase that refers to a person or company.
Cluster them by what they refer to. Output JSON:
[{{"entity": "Apple", "mentions": ["Apple", "the company", "it"]}}, ...]
"""要留意两种失败模式。第一,LLM 会过度合并(「him」和「her」指向两个不同的人)。第二,LLM 在长文档中会静默漏掉提及。始终用 span 偏移校验来核实。
第 4 步:评估
标准的 conll-2012 脚本会计算 MUC、B³、CEAF-φ4 并报告平均值。做内部评估时,先在标注测试集上从 span 级精确率和召回率开始,再加上提及链接 F1。
陷阱
- 单例爆炸。 有些系统把每个提及都报成单独的簇。B³ 对此很宽容。MUC 会惩罚这种做法。始终检查全部三个指标。
- 长上下文中的代词。 在超过 2,000 token 的文档上,性能下降约 15 F1。要小心分块。
- 性别假设。 硬编码的性别规则在非二元指称对象、组织、动物上会失效。使用学到的模型或中性打分。
- LLM 在长文档上的漂移。 单次 API 调用无法可靠地在 50 多个段落间聚类提及。使用滑动窗口加合并。
使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| 英语、单文档 | en_coreference_web_trf(spaCy-experimental)或 AllenNLP neural coref |
| 多语言 | 在 OntoNotes 或 Multilingual CoNLL 上训练的 SpanBERT / XLM-R |
| 跨文档事件共指 | 专用端到端模型(2025-26 年 SOTA) |
| 快速 LLM 基线 | GPT-4o / Claude 配合结构化输出的共指 prompt |
| 生产对话系统 | 规则兜底 + 神经主模型 + 关键槽位人工复核 |
2026 年落地的集成模式:先跑 NER,再跑共指,然后把共指簇合并进 NER 实体。下游任务看到的是每个簇一个实体,而不是每处提及一个实体。
交付它
保存为 outputs/skill-coref-picker.md:
markdown---
name: coref-picker
description: Pick a coreference approach, evaluation plan, and integration strategy.
version: 1.0.0
phase: 5
lesson: 24
tags: [nlp, coref, information-extraction]
---
Given a use case (single-doc / multi-doc, domain, language), output:
1. Approach. Rule-based / neural span-based / LLM-prompted / hybrid. One-sentence reason.
2. Model. Named checkpoint if neural.
3. Integration. Order of operations: tokenize → NER → coref → downstream task.
4. Evaluation. CoNLL F1 (MUC + B³ + CEAF-φ4 average) on held-out set + manual cluster review on 20 documents.
Refuse LLM-only coref for documents over 2,000 tokens without sliding-window merge. Refuse any pipeline that runs coref without a mention-level precision-recall report. Flag gender-heuristic systems deployed in demographically diverse text.练习
- 简单。 在 5 个手工构造的段落上运行
code/main.py中的规则消解器。对照真值测量提及链接准确率。 - 中等。 在一篇新闻文章上使用预训练神经共指模型。把你自己的手工标注与聚类结果对比。它在哪里失败了?
- 困难。 构建一个共指增强的 NER pipeline:先 NER,再通过共指簇合并。在 100 篇文章上测量相对纯 NER 的实体覆盖率提升。
关键术语
| 术语 | 大家常说的 | 实际含义 |
|---|---|---|
| 提及 | 一处指称 | 指向实体的文本 span(名称、代词、名词短语)。 |
| 先行语 | 「it」指的是什么 | 后面的提及所共指的先前提及。 |
| 簇 | 实体的各处理及 | 指向同一现实实体的提及集合。 |
| 回指 | 向后指称 | 后面的提及指向前面的提及(「he」→「John」)。 |
| 后指 | 向前指称 | 前面的提及指向后面的(「When he arrived, John...」)。 |
| 桥接指代 | 隐式指代 | 「I bought a car. The wheels were bad.」(那辆车的轮子。) |
| CoNLL F1 | 排行榜上的那个数字 | MUC、B³、CEAF-φ4 三项 F1 的平均值。 |
延伸阅读
- Jurafsky & Martin, SLP3 Ch. 26 — Coreference Resolution and Entity Linking —— 权威教材章节。
- Lee et al. (2017). End-to-end Neural Coreference Resolution —— 基于 span 的端到端方法。
- Joshi et al. (2020). SpanBERT —— 能改进共指的预训练方法。
- Pradhan et al. (2012). CoNLL-2012 Shared Task —— 该基准。
- Hobbs (1978). Resolving Pronoun References —— 基于规则的经典之作。
示意图共 1 张