问题
用户输入 "what happens if someone lies to get money",期望找到真正覆盖该行为的法律条文:"Section 420 IPC"(印度刑法第 420 条)。关键词搜索完全找不到它(没有共享词汇)。如果 embedding 没有在法律文本上训练过,语义搜索也找不到。真正的搜索必须同时处理两者。
IR(信息检索)是每个 RAG 系统、每个搜索框、每个文档站模糊查找底下的 pipeline。2026 年在生产环境奏效的架构不是单一方法,而是一条互补方法的链条,每一环接住前一环的失败。
本课逐件构建每一环,并说明每一环接住哪种失败。
概念
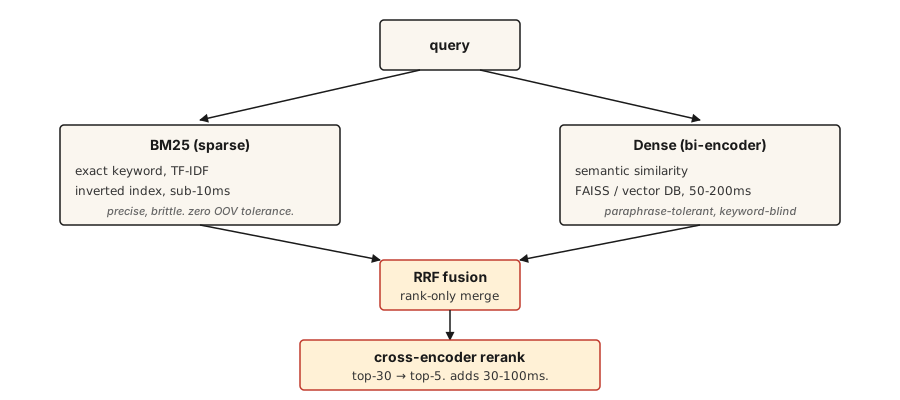
四层。按需取用。
- 稀疏检索(BM25)。 快,对精确匹配准确,对语义一塌糊涂。在倒排索引上运行。在数百万文档上每查询不到 10ms。让法律条文引用、产品代码、错误消息、命名实体都能正确命中。
- 稠密检索。 把查询和文档编码成向量,做最近邻搜索。能捕捉同义改写和语义相似度。但会漏掉仅差一个字符的精确关键词匹配。使用 FAISS 或向量数据库时每查询 50-200ms。
- 融合。 合并稀疏和稠密的排序列表。倒数排名融合(Reciprocal Rank Fusion,RRF)是简单的默认选择,因为它忽略原始分数(两者量纲不同),只使用排名位置。当你知道某个信号在你的领域占主导时,可以选择加权融合。
- Cross-encoder 重排序。 取融合后的 top-30。运行 cross-encoder(查询 + 文档一起输入,为每一对打分)。保留 top-5。cross-encoder 每对的速度比 bi-encoder 慢,但准确得多。只对 top-30 运行,成本就被摊薄了。
三路检索(BM25 + 稠密 + 学习型稀疏如 SPLADE)在 2026 年的基准上优于两路,但需要为学习型稀疏索引准备基础设施。对大多数团队来说,两路加 cross-encoder 重排序是最优区间。
构建它
第 1 步:从零实现 BM25
pythonimport math
import re
from collections import Counter
TOKEN_RE = re.compile(r"[a-z0-9]+")
def tokenize(text):
return TOKEN_RE.findall(text.lower())
class BM25:
def __init__(self, corpus, k1=1.5, b=0.75):
if not corpus:
raise ValueError("corpus must not be empty")
self.corpus = [tokenize(d) for d in corpus]
self.k1 = k1
self.b = b
self.n_docs = len(self.corpus)
self.avg_dl = sum(len(d) for d in self.corpus) / self.n_docs
self.df = Counter()
for doc in self.corpus:
for term in set(doc):
self.df[term] += 1
def idf(self, term):
n = self.df.get(term, 0)
return math.log(1 + (self.n_docs - n + 0.5) / (n + 0.5))
def score(self, query, doc_idx):
q_tokens = tokenize(query)
doc = self.corpus[doc_idx]
dl = len(doc)
freq = Counter(doc)
score = 0.0
for term in q_tokens:
f = freq.get(term, 0)
if f == 0:
continue
numerator = f * (self.k1 + 1)
denominator = f + self.k1 * (1 - self.b + self.b * dl / self.avg_dl)
score += self.idf(term) * numerator / denominator
return score
def rank(self, query, top_k=10):
scored = [(self.score(query, i), i) for i in range(self.n_docs)]
scored.sort(reverse=True)
return scored[:top_k]两个值得了解的参数。k1=1.5 控制词频饱和;越高意味着词重复的权重越大。b=0.75 控制长度归一化;0 忽略文档长度,1 完全归一化。这些默认值来自 Robertson 在原始论文中的建议,很少需要调整。
第 2 步:使用 bi-encoder 的稠密检索
pythonfrom sentence_transformers import SentenceTransformer
import numpy as np
def build_dense_index(corpus, model_id="sentence-transformers/all-MiniLM-L6-v2"):
encoder = SentenceTransformer(model_id)
embeddings = encoder.encode(corpus, normalize_embeddings=True)
return encoder, embeddings
def dense_search(encoder, embeddings, query, top_k=10):
q_emb = encoder.encode([query], normalize_embeddings=True)
sims = (embeddings @ q_emb.T).flatten()
order = np.argsort(-sims)[:top_k]
return [(float(sims[i]), int(i)) for i in order]对 embedding 做 L2 归一化,使点积等于余弦相似度。all-MiniLM-L6-v2 是 384 维,速度快,对大多数英文检索足够强。多语言任务用 paraphrase-multilingual-MiniLM-L12-v2。追求最高准确率用 bge-large-en-v1.5 或 e5-large-v2。
第 3 步:倒数排名融合
pythondef reciprocal_rank_fusion(rankings, k=60):
scores = {}
for ranking in rankings:
for rank, (_, doc_idx) in enumerate(ranking):
scores[doc_idx] = scores.get(doc_idx, 0.0) + 1.0 / (k + rank + 1)
fused = sorted(scores.items(), key=lambda x: x[1], reverse=True)
return [(score, doc_idx) for doc_idx, score in fused]k=60 常数来自 RRF 原始论文。k 越大,排名差异的贡献越平缓;k 越小,靠前的排名越占主导。60 是论文发表的默认值,很少需要调整。
第 4 步:混合搜索 + 重排序
pythonfrom sentence_transformers import CrossEncoder
reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")
def hybrid_search(query, bm25, encoder, dense_embeddings, corpus, top_k=5, pool_size=30, reranker=reranker):
sparse_ranking = bm25.rank(query, top_k=pool_size)
dense_ranking = dense_search(encoder, dense_embeddings, query, top_k=pool_size)
fused = reciprocal_rank_fusion([sparse_ranking, dense_ranking])[:pool_size]
pairs = [(query, corpus[doc_idx]) for _, doc_idx in fused]
scores = reranker.predict(pairs)
reranked = sorted(zip(scores, [doc_idx for _, doc_idx in fused]), reverse=True)
return reranked[:top_k]三个阶段组合。BM25 找到词汇匹配。稠密检索找到语义匹配。RRF 合并两个排序,无需分数校准。Cross-encoder 把查询和文档成对输入,对 top-30 重新打分,捕捉 bi-encoder 漏掉的细粒度相关性。保留 top-5。
第 5 步:评估
| 指标 | 含义 |
|---|---|
| Recall@k | 在存在正确文档的查询中,它出现在 top-k 的比例是多少? |
| MRR(Mean Reciprocal Rank) | 第一个相关文档排名的倒数的平均值。 |
| nDCG@k | 考虑相关性的分级,而不只是二元的相关/不相关。 |
对 RAG 而言,检索器的 Recall@k 是最重要的数字。如果正确的段落不在检索集合里,阅读器就无从作答。
调试技巧:对失败的查询,把稀疏和稠密的排序做 diff。如果一方找到了正确文档而另一方没找到,你要么有词汇不匹配问题(修复:补上缺失的那一半),要么有语义歧义(修复:更好的 embedding 或重排序器)。
使用它
2026 年的技术栈:
| 规模 | 技术栈 |
|---|---|
| 1k-100k 文档 | 内存 BM25 + all-MiniLM-L6-v2 embedding + RRF。不需要单独的数据库。 |
| 100k-10M 文档 | FAISS 或 pgvector 做稠密 + Elasticsearch / OpenSearch 做 BM25。并行运行。 |
| 10M+ 文档 | Qdrant / Weaviate / Vespa / Milvus,支持混合检索。在 top-30 上做 cross-encoder 重排序。 |
| 最佳质量前沿 | 三路(BM25 + 稠密 + SPLADE)+ ColBERT 延迟交互重排序 |
无论选什么,都要为评估预留预算。在基准测试端到端 RAG 准确率之前,先基准测试检索召回率。阅读器无法修复检索器漏掉的东西。
2026 年生产级 RAG 的实战教训
- 80% 的 RAG 失败可以追溯到数据摄取和分块,而不是模型。 团队花数周更换 LLM、调 prompt,而检索每三次查询就有一次悄悄返回错误的上下文。先修分块。
- 分块策略比 chunk 大小更重要。 固定大小切分会切断表格、代码和嵌套标题。句子感知是默认做法;对技术文档和产品手册,语义分块或基于 LLM 的分块更值得。
- 父文档模式(parent-doc pattern)。 检索小的「子」chunk 以保证精度。当同一父章节的多个子 chunk 出现时,换入父块以保留上下文。这能稳定提升答案质量,无需重新训练。
- k_rerank=3 通常是较优选择。 再多加一个 chunk 都会增加 token 成本和生成延迟,却不提升答案质量。如果 k=8 仍然比 k=3 好,说明重排序器表现不佳。
- HyDE / 查询扩展。 从查询生成一个假设性答案,对它做 embedding,再去检索。桥接短问题与长文档之间的措辞差距。无需训练即可免费提升精度。
- 上下文预算低于 8K token。 持续在该上限附近命中,意味着重排序器的阈值太松。
- 为一切做版本管理。 prompt、分块规则、embedding 模型、重排序器。任何漂移都会悄悄破坏答案质量。在 CI 中对忠实度、上下文精确率和未回答问题率设门禁,在用户看到之前拦截回归。
- 三路检索(BM25 + 稠密 + 学习型稀疏如 SPLADE)优于两路,在 2026 年基准上尤其如此,尤其对混用专有名词与语义的查询。基础设施支持 SPLADE 索引时就上线它。
根据 2026 年的行业测量,恰当的检索设计能把幻觉减少 70-90%。RAG 的大部分性能提升来自更好的检索,而不是模型微调。
交付它
保存为 outputs/skill-retrieval-picker.md:
markdown---
name: retrieval-picker
description: Pick a retrieval stack for a given corpus and query pattern.
version: 1.0.0
phase: 5
lesson: 14
tags: [nlp, retrieval, rag, search]
---
Given requirements (corpus size, query pattern, latency budget, quality bar, infra constraints), output:
1. Stack. BM25 only, dense only, hybrid (BM25 + dense + RRF), hybrid + cross-encoder rerank, or three-way (BM25 + dense + learned-sparse).
2. Dense encoder. Name the specific model. Match to language(s), domain, and context length.
3. Reranker. Name the specific cross-encoder model if used. Flag that rerank adds 30-100ms latency on top-30.
4. Evaluation plan. Recall@10 is the primary retriever metric. MRR for multi-answer. Baseline first, incremental improvements measured against it.
Refuse to recommend dense-only for corpora with named entities, error codes, or product SKUs unless the user has evidence dense handles exact matches. Refuse to skip reranking for high-stakes retrieval (legal, medical) where the final top-5 decides the user's answer.练习
- 简单。 在一个 500 文档的语料库上实现上面的
hybrid_search。测试 20 个查询。比较仅 BM25、仅稠密和混合在 recall@5 上的差异。 - 中等。 加入 MRR 计算。对每个已知正确文档的测试查询,找出正确文档在 BM25、稠密、混合排序中的排名。报告各自的 MRR。
- 困难。 使用 MultipleNegativesRankingLoss(Sentence Transformers)在你的领域上微调一个稠密编码器。用 500 个查询-文档对构建训练集。比较微调前后的召回率。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| BM25 | 关键词搜索 | Okapi BM25。按词频、IDF 和文档长度给文档打分。 |
| Dense retrieval | 向量搜索 | 把查询 + 文档编码成向量,找最近邻。 |
| Bi-encoder | Embedding 模型 | 独立编码查询和文档。查询时速度快。 |
| Cross-encoder | 重排序模型 | 把查询 + 文档一起编码。慢但准确。 |
| RRF | 排名融合 | 通过累加 1/(k + rank) 合并两个排序。 |
| Recall@k | 检索指标 | 相关文档出现在 top-k 中的查询比例。 |
延伸阅读
- Robertson and Zaragoza (2009). The Probabilistic Relevance Framework: BM25 and Beyond —— 关于 BM25 的权威论述。
- Karpukhin et al. (2020). Dense Passage Retrieval for Open-Domain QA —— DPR,标准的 bi-encoder。
- Formal et al. (2021). SPLADE: Sparse Lexical and Expansion Model —— 缩小与稠密检索差距的学习型稀疏检索器。
- Cormack, Clarke, Büttcher (2009). Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods —— RRF 论文。
- Khattab and Zaharia (2020). ColBERT: Efficient and Effective Passage Search —— 延迟交互检索。
示意图共 1 张
