问题
你做了一个摘要器。它产出了一段摘要。你怎么知道摘要里没有幻觉?
你做了一个聊天机器人。它回答了「是」。你怎么知道这个答案得到了检索段落的支持?
你需要按主题给 10,000 篇新闻分类。你没有任何训练标签。能复用一个现成的模型吗?
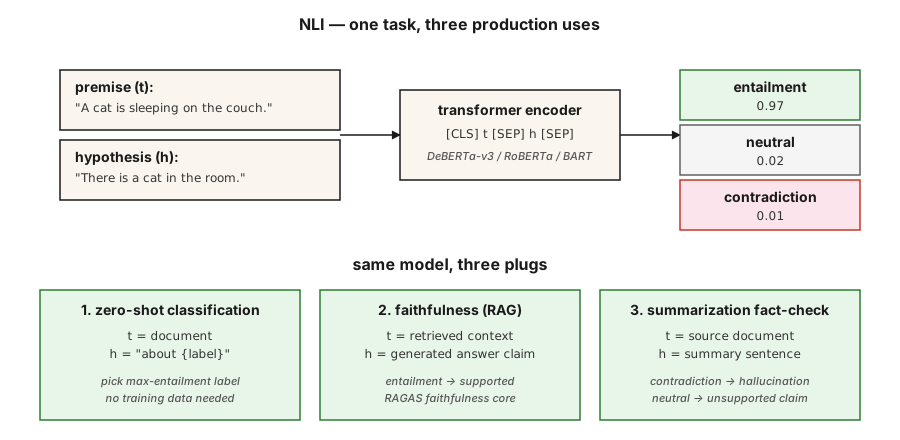
这三个问题都归约为自然语言推理(Natural Language Inference,NLI)。NLI 问的是:给定前提 t 和假设 h,h 是被 t 蕴含、与 t 矛盾,还是中立(无关)?
- 幻觉检查:
t= 源文档,h= 摘要中的断言。不蕴含 = 幻觉。 - 有据问答:
t= 检索到的段落,h= 生成的答案。不蕴含 = 捏造。 - 零样本分类:
t= 文档,h= 用自然语言表述的标签(「这是关于体育的」)。蕴含 = 预测标签。
一个任务,三种生产用途。这就是每个 RAG 评估框架底层都会带一个 NLI 模型的原因。
概念
三个标签。
- 蕴含。
t→h。「猫在垫子上」蕴含「有一只猫」。 - 矛盾。
t→ ¬h。「猫在垫子上」与「没有猫」矛盾。 - 中立。 两个方向都推不出。「猫在垫子上」对「猫饿了」保持中立。
不是逻辑蕴含。 NLI 是自然语言推理 —— 一个典型人类读者会推断出的内容,而不是严格逻辑。「John 遛了他的狗」在 NLI 中蕴含「John 有一条狗」,但严格的一阶逻辑只有在你把「拥有」公理化之后才承认这一点。
数据集。
- SNLI(2015)。57 万个人工标注对,以图像说明文字作为前提。领域较窄。
- MultiNLI(2017)。43.3 万个对,覆盖 10 种文体。2026 年的标准训练语料。
- ANLI(2019)。对抗式 NLI。人类专门编写用来击破现有模型的例子。更难。
- DocNLI、ConTRoL(2020–21)。文档长度的前提。测试多跳和长距离推理。
架构。 Transformer 编码器(BERT、RoBERTa、DeBERTa)读取 [CLS] premise [SEP] hypothesis [SEP]。[CLS] 的表示送入三分类 softmax。在 MNLI 上训练,在留出基准上评估,分布内样本能达到 90% 以上的准确率。
借助 NLI 做零样本分类。 给定文档和候选标签,把每个标签变成一句假设(「这段文本是关于体育的」)。计算每个标签的蕴含概率。取最大者。这就是 Hugging Face zero-shot-classification pipeline 背后的机制。
构建它
第 1 步:运行预训练的 NLI 模型
pythonfrom transformers import pipeline
nli = pipeline("text-classification",
model="facebook/bart-large-mnli",
top_k=None) # return all labels; replaces deprecated return_all_scores=True
premise = "The cat is sleeping on the couch."
hypothesis = "There is a cat in the room."
result = nli({"text": premise, "text_pair": hypothesis})[0]
print(result)
# [{'label': 'entailment', 'score': 0.97},
# {'label': 'neutral', 'score': 0.02},
# {'label': 'contradiction', 'score': 0.01}]生产环境中的 NLI,默认开源选择是 facebook/bart-large-mnli 和 MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli。DeBERTa-v3 在排行榜上排名第一。
第 2 步:零样本分类
pythonzs = pipeline("zero-shot-classification", model="facebook/bart-large-mnli")
text = "The stock market rallied after the central bank cut interest rates."
labels = ["finance", "sports", "politics", "technology"]
result = zs(text, candidate_labels=labels)
print(result)
# {'labels': ['finance', 'politics', 'technology', 'sports'],
# 'scores': [0.92, 0.05, 0.02, 0.01]}默认模板是「This example is about {label}.」。可用 hypothesis_template 自定义。不需要训练数据。不需要微调。开箱即用。
第 3 步:RAG 的忠实度检查
pythondef is_faithful(answer, context, threshold=0.5):
result = nli({"text": context, "text_pair": answer})[0]
entail = next(s for s in result if s["label"] == "entailment")
return entail["score"] > threshold这就是 RAGAS 忠实度(faithfulness)的核心。把生成的答案拆成原子断言。逐条对照检索到的上下文检查。报告其中被蕴含的比例。
第 4 步:手写的 NLI 分类器(概念演示)
见 code/main.py 中仅用标准库的玩具实现:通过词汇重叠加否定检测来比较前提和假设。它无法与 Transformer 模型竞争 —— 但它展示了任务的形状:输入两段文本,输出三分类标签,损失为 {entail, contradict, neutral} 上的交叉熵。
陷阱
- 只看假设的捷径。 在 SNLI 上,仅凭假设就能以约 60% 的准确率预测标签,因为「not」「nobody」「never」与矛盾相关。这是检测标签泄漏的强基线。
- 词汇重叠启发式。 子序列启发式(「每个子序列都被蕴含」)能通过 SNLI,但在 HANS/ANLI 上失败。使用对抗基准。
- 文档长度导致的退化。 单句 NLI 模型在文档长度前提上会掉 20 以上的 F1。长上下文请使用 DocNLI 训练的模型。
- 零样本模板敏感。 「This example is about {label}」与「{label}」与「The topic is {label}」之间,准确率可能摆动 10 个点以上。要调模板。
- 领域不匹配。 MNLI 在通用英语上训练。法律、医学和科学文本需要领域专用 NLI 模型(如 SciNLI、MedNLI)。
使用它
2026 年的技术栈:
| 用例 | 模型 |
|---|---|
| 通用 NLI | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli |
| 快速 / 边缘 | cross-encoder/nli-deberta-v3-base |
| 零样本分类(轻量) | facebook/bart-large-mnli |
| 文档级 NLI | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli |
| 多语言 | MoritzLaurer/multilingual-MiniLMv2-L6-mnli-xnli |
| RAG 中的幻觉检测 | RAGAS / DeepEval 内部的 NLI 层 |
2026 年的元模式:NLI 是文本理解的胶带。每当需要判断「A 是否支持 B?」或「A 是否与 B 矛盾?」,先想到 NLI,再考虑另一次 LLM 调用。
交付它
保存为 outputs/skill-nli-picker.md:
markdown---
name: nli-picker
description: Pick an NLI model, label template, and evaluation setup for a classification / faithfulness / zero-shot task.
version: 1.0.0
phase: 5
lesson: 21
tags: [nlp, nli, zero-shot]
---
Given a use case (faithfulness check, zero-shot classification, document-level inference), output:
1. Model. Named NLI checkpoint. Reason tied to domain, length, language.
2. Template (if zero-shot). Verbalization pattern. Example.
3. Threshold. Entailment cutoff for the decision rule. Reason based on calibration.
4. Evaluation. Accuracy on held-out labeled set, hypothesis-only baseline, adversarial subset.
Refuse to ship zero-shot classification without a 100-example labeled sanity check. Refuse to use a sentence-level NLI model on document-length premises. Flag any claim that NLI solves hallucination — it reduces it; it does not eliminate it.练习
- 简单。 在 20 个手工构造的(前提,假设,标签)三元组上运行
facebook/bart-large-mnli,覆盖全部三个类别。测量准确率。加入对抗性的「子序列启发式」陷阱(「I did not eat the cake」对「I ate the cake」),看它是否会失效。 - 中等。 在 100 条 AG News 标题上,比较零样本模板
"This text is about {label}"与"The topic is {label}"、"{label}"。报告准确率的摆动幅度。 - 困难。 构建一个 RAG 忠实度检查器:原子断言分解 + 逐条 NLI。在 50 个带金标准上下文的 RAG 生成答案上评估。对照人工标签测量假阳性和假阴性率。
关键术语
| 术语 | 大家常说的 | 实际含义 |
|---|---|---|
| NLI | Natural Language Inference | 前提-假设关系的三分类。 |
| RTE | Recognizing Textual Entailment | NLI 的旧名称;同一任务。 |
| 蕴含 | 「t 推出 h」 | 给定 t,典型读者会断定 h 为真。 |
| 矛盾 | 「t 排除 h」 | 给定 t,典型读者会断定 h 为假。 |
| 中立 | 「未定」 | 从 t 到 h 两个方向都推不出。 |
| 零样本分类 | 把 NLI 当分类器 | 把标签表述为假设,取蕴含概率最大者。 |
| 忠实度 | 答案有据可依吗? | 在(检索上下文,生成答案)上做 NLI。 |
延伸阅读
- Bowman et al. (2015). A large annotated corpus for learning natural language inference —— SNLI。
- Williams, Nangia, Bowman (2017). A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference —— MultiNLI。
- Nie et al. (2019). Adversarial NLI —— ANLI 基准。
- Yin, Hay, Roth (2019). Benchmarking Zero-shot Text Classification —— 把 NLI 当分类器。
- He et al. (2021). DeBERTa: Decoding-enhanced BERT with Disentangled Attention —— 2026 年 NLI 的主力模型。
示意图共 1 张