问题
你的 RAG 系统有 40% 的时间检索到错误段落。罪魁祸首很少是向量数据库或 prompt,而是 embedding 模型。
2026 年选择 embedding,意味着要跨五个维度做决定:
- 稠密 vs 稀疏 vs 多向量。 每个段落一个向量,或每个 token 一个向量,或一个稀疏的加权词袋。
- 语言覆盖。 纯英语任务上,单语英语模型仍然占优。语料混合时,多语言模型胜出。
- 上下文长度。 512 个 token 对 8,192 对 32,768 —— 而真实有效容量往往只有标称上限的 60-70%。
- 维度预算。 全精度下 3,072 个浮点数 = 每个向量 12 KB。一亿个向量时,存储费用是每月 1,300 美元。Matryoshka 截断能把它降到 1/4。
- 开源 vs 托管。 开放权重意味着你掌控技术栈和数据。托管意味着用控制权换取始终最新。
本节课把这些权衡讲清楚,让你依据证据来选择,而不是跟着上一个季度的流行走。
概念
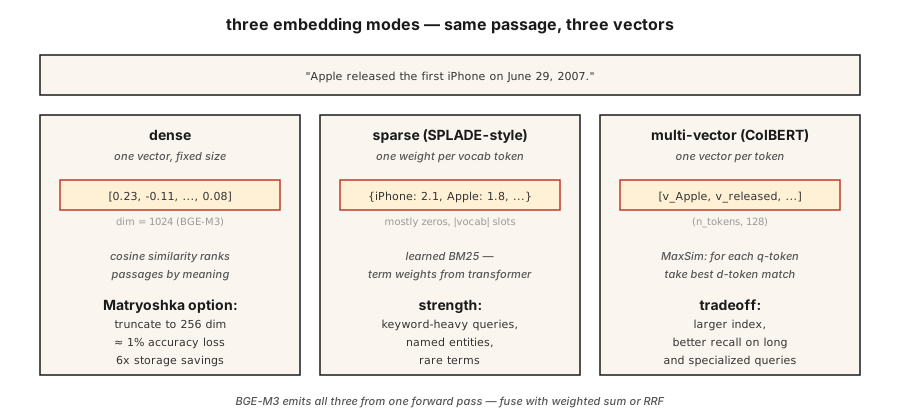
稠密 embedding。 每个段落一个向量(通常 384-3,072 维)。用余弦相似度按语义接近程度排序。OpenAI text-embedding-3-large、BGE-M3 的稠密模式、Voyage-3。默认选择。
稀疏 embedding。 SPLADE 风格。Transformer 为每个词表 token 预测一个权重,然后把大部分置零。结果是一个大小为 |vocab| 的稀疏向量。它能捕获词汇匹配(类似 BM25),但用的是学到的词项权重。在关键词密集的查询上很强。
多向量(晚期交互)。 ColBERTv2、Jina-ColBERT。每个 token 一个向量。用 MaxSim 打分:对每个查询 token,找到最相似的文档 token,再把分数求和。存储和打分都更贵,但在长查询和领域专用语料上胜出。
BGE-M3:三者合一。 单个模型同时输出稠密、稀疏和多向量表示。每种都可以独立查询;分数通过加权求和融合。想要一个 checkpoint 提供多种灵活性时,这是 2026 年的默认选择。
Matryoshka 表示学习。 训练方式保证了向量的前 N 维本身就是一个可用的独立 embedding。把 1,536 维向量截到 256 维,准确率约损失 1%,换来 6 倍的存储节省。OpenAI text-3、Cohere v4、Voyage-4、Jina v5、Gemini Embedding 2、Nomic v1.5+ 都支持。
MTEB 排行榜只讲了部分故事
Massive Text Embedding Benchmark —— 2022 年发布时有 8 类任务、共 56 个任务,MTEB v2 扩展到 100 多个任务。2026 年初,Gemini Embedding 2 在检索上排名第一(MTEB-R 67.71)。Cohere embed-v4 在通用任务上领先(MTEB 65.2)。BGE-M3 在开源多语言上领先(63.0)。排行榜是必要条件而非充分条件 —— 始终要在你的领域上做基准测试。
三层模式
| 用例 | 模式 |
|---|---|
| 快速初筛 | 稠密双编码器(BGE-M3、text-3-small) |
| 提升召回 | 稀疏(SPLADE、BGE-M3 sparse)+ RRF 融合 |
| top-50 上的精确度 | 多向量(ColBERTv2)或 cross-encoder 重排器 |
大多数生产栈三种都用。
构建它
第 1 步:基线 —— 用 Sentence-BERT 生成稠密 embedding
pythonfrom sentence_transformers import SentenceTransformer
import numpy as np
encoder = SentenceTransformer("BAAI/bge-small-en-v1.5")
corpus = [
"The first iPhone launched in 2007.",
"Apple released the iPod in 2001.",
"Android is an operating system from Google.",
]
emb = encoder.encode(corpus, normalize_embeddings=True)
query = "When was the iPhone released?"
q_emb = encoder.encode([query], normalize_embeddings=True)[0]
scores = emb @ q_emb
print(sorted(enumerate(scores), key=lambda x: -x[1]))normalize_embeddings=True 会让点积等于余弦相似度。始终设置它。
第 2 步:Matryoshka 截断
pythondef truncate(vectors, dim):
out = vectors[:, :dim]
return out / np.linalg.norm(out, axis=1, keepdims=True)
emb_256 = truncate(emb, 256)
emb_128 = truncate(emb, 128)截断后要重新归一化。Nomic v1.5、OpenAI text-3 和 Voyage-4 的训练方式使前几级截断几乎无损。非 Matryoshka 模型(原始 Sentence-BERT)截断后性能会急剧下降。
第 3 步:BGE-M3 的多功能输出
pythonfrom FlagEmbedding import BGEM3FlagModel
model = BGEM3FlagModel("BAAI/bge-m3", use_fp16=True)
output = model.encode(
corpus,
return_dense=True,
return_sparse=True,
return_colbert_vecs=True,
)
# output["dense_vecs"]: (n_docs, 1024)
# output["lexical_weights"]: list of dict {token_id: weight}
# output["colbert_vecs"]: list of (n_tokens, 1024) arrays三个索引,一次推理调用。分数融合:
pythondense_score = ... # cosine over dense_vecs
sparse_score = model.compute_lexical_matching_score(q_lex, d_lex)
colbert_score = model.colbert_score(q_col, d_col)
final = 0.4 * dense_score + 0.2 * sparse_score + 0.4 * colbert_score在你的领域上调整权重。
第 4 步:在自定义任务上做 MTEB 评估
pythonfrom mteb import MTEB
tasks = ["ArguAna", "SciFact", "NFCorpus"]
evaluation = MTEB(tasks=tasks)
results = evaluation.run(encoder, output_folder="./mteb-results")在一个有代表性的子集上运行候选模型。不要只信排行榜名次 —— 你的领域很重要。
第 5 步:从零手写余弦相似度
见 code/main.py。基于 Hashing Trick 平均的 embedding(仅用标准库)。它无法与 Transformer embedding 竞争,但展示了形状:分词 → 向量 → 归一化 → 点积。
陷阱
- 查询和文档用同一个模型。 有些模型(Voyage、Jina-ColBERT)使用非对称编码 —— 查询和文档走不同路径。始终查看模型卡。
- 缺少前缀。
bge-*模型需要在查询前加上"Represent this sentence for searching relevant passages: "。忘了会带来 3-5 个点的召回差距。 - Matryoshka 截得太狠。 1,536 → 256 通常安全。1,536 → 64 不安全。在你的评估集上验证。
- 上下文截断。 大多数模型会静默截断超过最大长度的输入。长文档需要分块(见第 23 课)。
- 忽视延迟长尾。 MTEB 分数掩盖了 p99 延迟。600M 模型可能比 335M 模型高 2 个点,但每次查询贵 3 倍。
使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| 纯英语、快速、走 API | text-embedding-3-large 或 voyage-3-large |
| 开放权重、英语 | BAAI/bge-large-en-v1.5 |
| 开放权重、多语言 | BAAI/bge-m3 或 Qwen3-Embedding-8B |
| 长上下文(32k+) | Voyage-3-large、Cohere embed-v4、Qwen3-Embedding-8B |
| 仅 CPU 部署 | Nomic Embed v2(137M 参数,MoE) |
| 存储受限 | Matryoshka 截断 + int8 量化 |
| 关键词密集查询 | 加上 SPLADE 稀疏,与稠密做 RRF 融合 |
2026 年的模式:从 BGE-M3 或 text-3-large 开始,用 MTEB 在你的领域上评估,如果领域专用模型领先超过 3 个点就换掉。
交付它
保存为 outputs/skill-embedding-picker.md:
markdown---
name: embedding-picker
description: Pick embedding model, dimension, and retrieval mode for a given corpus and deployment.
version: 1.0.0
phase: 5
lesson: 22
tags: [nlp, embeddings, retrieval]
---
Given a corpus (size, languages, domain, avg length), deployment target (cloud / edge / on-prem), latency budget, and storage budget, output:
1. Model. Named checkpoint or API. One-sentence reason.
2. Dimension. Full / Matryoshka-truncated / int8-quantized. Reason tied to storage budget.
3. Mode. Dense / sparse / multi-vector / hybrid. Reason.
4. Query prefix / template if required by the model card.
5. Evaluation plan. MTEB tasks relevant to domain + held-out domain eval with nDCG@10.
Refuse recommendations that truncate Matryoshka to <64 dims without domain validation. Refuse ColBERTv2 for corpora under 10k passages (overhead not justified). Flag long-document corpora (>8k tokens) routed to models with 512-token windows.练习
- 简单。 用
bge-small-en-v1.5在完整维度(384)下编码 100 个句子,再用 Matryoshka 128 编码。测量 10 个查询上的 MRR 下降。 - 中等。 在来自你所在领域的 500 个段落上比较 BGE-M3 的稠密、稀疏和 colbert 输出。recall@10 上谁胜出?RRF 融合是否优于最好的单一模式?
- 困难。 在你领域最重要的两个任务上,对三个候选模型运行 MTEB。报告 MTEB 分数、100 查询 batch 的 p99 延迟,以及每百万次查询的成本。选出帕累托最优的那个。
关键术语
| 术语 | 大家常说的 | 实际含义 |
|---|---|---|
| 稠密 embedding | 那个向量 | 每段文本一个固定大小的向量。用余弦相似度排序。 |
| 稀疏 embedding | 学出来的 BM25 | 每个词表 token 一个权重;大部分为零;端到端训练。 |
| 多向量 | ColBERT 风格 | 每个 token 一个向量;MaxSim 打分;索引更大,召回更好。 |
| Matryoshka | 俄罗斯套娃技巧 | 前 N 维本身就是一个可用的较小 embedding。 |
| MTEB | 那个基准 | Massive Text Embedding Benchmark —— 发布时 56 个任务,v2 有 100 多个。 |
| BEIR | 检索基准 | 18 个零样本检索任务;常被引用来衡量跨域鲁棒性。 |
| 非对称编码 | 查询 ≠ 文档路径 | 模型对查询和文档使用不同的投影。 |
延伸阅读
- Reimers, Gurevych (2019). Sentence-BERT —— 双编码器论文。
- Muennighoff et al. (2022). MTEB: Massive Text Embedding Benchmark —— 排行榜论文。
- Chen et al. (2024). BGE-M3: Multi-lingual, Multi-functionality, Multi-granularity —— 统一三模式模型。
- Kusupati et al. (2022). Matryoshka Representation Learning —— 维度阶梯式训练目标。
- Santhanam et al. (2022). ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction —— 生产中的晚期交互。
- MTEB leaderboard on Hugging Face —— 实时排名。
示意图共 1 张