问题
你的词表有 50,000 个词。用户输入了「untokenizable」。你的分词器返回 [UNK]。模型对这个词完全没有任何信号。更糟的是:语料库中处于 90 分位的文档包含 40 个罕见词,这意味着每篇文档丢掉了 40 比特的信息。
子词分词解决了这个问题。常见词保持为单个 token。罕见词被拆成有意义的片段:untokenizable → un、token、izable。训练数据能覆盖一切,因为任何字符串最终都是字节序列。
2026 年的每个前沿 LLM 都基于三种算法之一(BPE、Unigram、WordPiece),并封装在三种库之一中(tiktoken、SentencePiece、HF Tokenizers)。发布语言模型时,你不可能不选其中一种。
概念
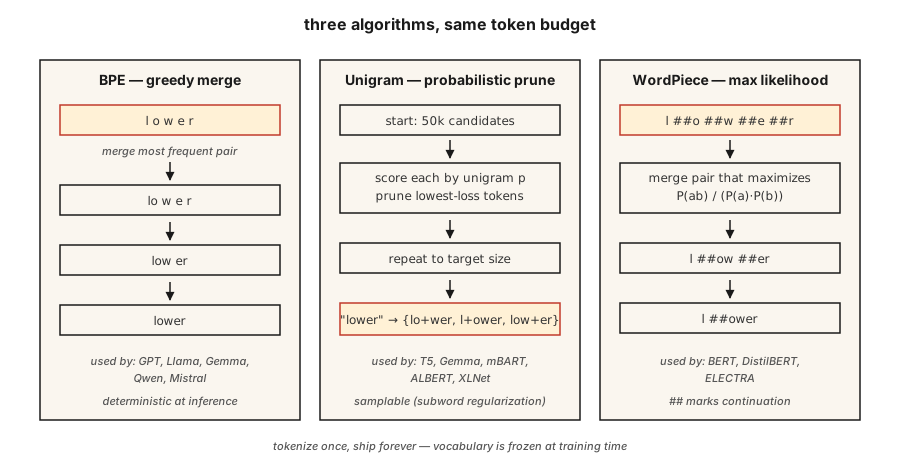
BPE(Byte-Pair Encoding,字节对编码)。 从字符级词表开始。统计每一对相邻符号。把出现最频繁的一对合并成新 token。重复,直到达到目标词表大小。这是占主导地位的算法:GPT-2/3/4、Llama、Gemma、Qwen2、Mistral。
字节级 BPE。 同一算法,但作用在原始字节上(256 个基础 token),而不是 Unicode 字符。它保证不会出现 [UNK] token —— 任何字节序列都能编码。GPT-2 使用 50,257 个 token(256 个字节 + 50,000 次合并 + 1 个特殊 token)。
Unigram。 从一个巨大的词表开始。给每个 token 分配一个 unigram 概率。迭代地剪掉那些删除后对语料对数似然影响最小的 token。推理时是概率性的:可以采样出多种分词方式(借助子词正则化做数据增强时很有用)。T5、mBART、ALBERT、XLNet、Gemma 使用它。
WordPiece。 合并那些能让训练语料似然最大化(而不是原始频次最高)的符号对。BERT、DistilBERT、ELECTRA 使用它。
SentencePiece 与 tiktoken。 SentencePiece 是直接在原始 Unicode 文本上训练词表的库(BPE 或 Unigram),把空白编码为 ▁。tiktoken 是 OpenAI 针对预构建词表的快速编码器;它不负责训练。
经验法则:
- 训练新词表: SentencePiece(多语言,无需预分词)或 HF Tokenizers。
- 对 GPT 词表做快速推理: tiktoken(cl100k_base、o200k_base)。
- 两者都要: HF Tokenizers —— 一个库,训练 + 服务。
构建它
第 1 步:从零实现 BPE
见 code/main.py。核心循环:
pythondef train_bpe(corpus, num_merges):
vocab = {tuple(word) + ("</w>",): count for word, count in corpus.items()}
merges = []
for _ in range(num_merges):
pairs = Counter()
for symbols, freq in vocab.items():
for a, b in zip(symbols, symbols[1:]):
pairs[(a, b)] += freq
if not pairs:
break
best = pairs.most_common(1)[0][0]
merges.append(best)
vocab = apply_merge(vocab, best)
return merges这个算法编码了三个事实。</w> 标记词尾,从而让「low」(作为后缀)与「lower」(作为前缀)保持区分。频次加权让高频符号对在早期胜出。合并列表是有序的 —— 推理时按训练顺序应用合并。
第 2 步:用学到的合并规则编码
pythondef encode_bpe(word, merges):
symbols = list(word) + ["</w>"]
for a, b in merges:
i = 0
while i < len(symbols) - 1:
if symbols[i] == a and symbols[i + 1] == b:
symbols = symbols[:i] + [a + b] + symbols[i + 2:]
else:
i += 1
return symbols朴素实现是 O(n \cdot \lvert \text{merges} \rvert)。生产级实现(tiktoken、HF Tokenizers)使用合并排名查找加优先队列,运行时间接近线性。
第 3 步:实践中的 SentencePiece
pythonimport sentencepiece as spm
spm.SentencePieceTrainer.train(
input="corpus.txt",
model_prefix="my_tokenizer",
vocab_size=8000,
model_type="bpe", # or "unigram"
character_coverage=0.9995, # lower for CJK (e.g. 0.9995 for English, 0.995 for Japanese)
normalization_rule_name="nmt_nfkc",
)
sp = spm.SentencePieceProcessor(model_file="my_tokenizer.model")
print(sp.encode("untokenizable", out_type=str))
# ['▁un', 'token', 'izable']注意:不需要预分词;空格被编码为 ▁;character_coverage 控制罕见字符被保留(而不是映射为 <unk>)的积极程度。
第 4 步:面向 OpenAI 兼容词表使用 tiktoken
pythonimport tiktoken
enc = tiktoken.get_encoding("o200k_base")
print(enc.encode("untokenizable")) # [127340, 101028]
print(len(enc.encode("Hello, world!"))) # 4只做编码。速度快(Rust 后端)。与 GPT-4/5 的分词完全一致,适合统计字节数、估算成本、规划上下文窗口。
2026 年仍在出货的陷阱
- 分词器漂移。 用词表 A 训练,却对着词表 B 部署。token ID 不一致;模型输出乱码。在 CI 中校验
tokenizer.json的哈希。 - 空白歧义。 BPE 下的「hello」与「 hello」会产生不同的 token。始终显式指定
add_special_tokens和add_prefix_space。 - 多语言训练不足。 以英语为主的语料产生的词表,会把非拉丁文字切成多 5-10 倍的 token。在 GPT-3.5 上,同一个 prompt 用日语或阿拉伯语要贵 5-10 倍。o200k_base 部分修复了这个问题。
- Emoji 被切碎。 单个 emoji 可能占用 5 个 token。做上下文预算时检查 emoji 的处理方式。
使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| 从零训练单语言模型 | HF Tokenizers(BPE) |
| 训练多语言模型 | SentencePiece(Unigram,character_coverage=0.9995) |
| 提供 OpenAI 兼容 API | tiktoken(GPT-4+ 用 o200k_base) |
| 领域专用词表(代码、数学、蛋白质) | 在领域语料上训练自定义 BPE,再与基础词表合并 |
| 边缘推理、小模型 | Unigram(更小的词表效果更好) |
词表大小是一个规模决策,而不是一个常数。粗略经验规则:<1B 参数用 32k,1-10B 用 50-100k,多语言或前沿模型用 200k+。
交付它
保存为 outputs/skill-bpe-vs-wordpiece.md:
markdown---
name: tokenizer-picker
description: Pick tokenizer algorithm, vocab size, library for a given corpus and deployment target.
version: 1.0.0
phase: 5
lesson: 19
tags: [nlp, tokenization]
---
Given a corpus (size, languages, domain) and deployment target (training from scratch / fine-tuning / API-compatible inference), output:
1. Algorithm. BPE, Unigram, or WordPiece. One-sentence reason.
2. Library. SentencePiece, HF Tokenizers, or tiktoken. Reason.
3. Vocab size. Rounded to nearest 1k. Reason tied to model size and language coverage.
4. Coverage settings. `character_coverage`, `byte_fallback`, special-token list.
5. Validation plan. Average tokens-per-word on held-out set, OOV rate, compression ratio, round-trip decode equality.
Refuse to train a character-coverage <0.995 tokenizer on corpora with rare-script content. Refuse to ship a vocab without a frozen `tokenizer.json` hash check in CI. Flag any monolingual tokenizer under 16k vocab as likely under-spec.练习
- 简单。 在
code/main.py的小语料上训练一个 500 次合并的 BPE。编码三个留出词。有多少恰好产出 1 个 token,有多少产出多于 1 个? - 中等。 在 100 个英文维基百科句子上,比较
cl100k_base、o200k_base以及你自己用 vocab=32k 训练的 SentencePiece BPE 的 token 数。报告各自的压缩比。 - 困难。 用 BPE、Unigram、WordPiece 分别训练同一份语料。在小型情感分类器上分别使用,测量下游准确率。这个选择带来的 F1 变化是否超过 1 个点?
关键术语
| 术语 | 大家常说的 | 实际含义 |
|---|---|---|
| BPE | Byte-Pair Encoding | 贪心地合并最频繁的字符对,直到达到目标词表大小。 |
| 字节级 BPE | 永不出现未知 token | 在原始 256 个字节上做 BPE;GPT-2 / Llama 采用这种方式。 |
| Unigram | 概率分词器 | 用对数似然从一个大型候选集中裁剪;T5、Gemma 使用。 |
| SentencePiece | 处理空白的那一个 | 直接在原始文本上训练 BPE/Unigram 的库;空格编码为 ▁。 |
| tiktoken | 快的那一个 | OpenAI 用 Rust 实现的 BPE 编码器,面向预构建词表。不负责训练。 |
| 合并列表 | 神秘的编号 | (a, b) → ab 合并的有序列表;推理时按顺序应用。 |
| 字符覆盖率 | 多罕见才算太罕见? | 分词器必须覆盖训练语料中字符的比例;通常约为 0.9995。 |
延伸阅读
- Sennrich, Haddow, Birch (2015). Neural Machine Translation of Rare Words with Subword Units —— BPE 原论文。
- Kudo (2018). Subword Regularization with Unigram Language Model —— Unigram 原论文。
- Kudo, Richardson (2018). SentencePiece: A simple and language independent subword tokenizer —— 该库。
- Hugging Face — Summary of the tokenizers —— 简明参考。
- OpenAI tiktoken repo —— 使用手册 + 编码列表。
示意图共 1 张