问题
用户输入 "When did the first iPhone launch?",期望得到 "June 29, 2007"。不是 "Apple's history is long and varied.",也不是孤零零、没有句子的 "2007"。要的是一个直接、有依据、正确的答案。
过去十年里有三种架构主导了问答系统。
- 抽取式问答(Extractive QA)。 给定一个问题和一个已知包含答案的段落,找出答案片段在段落中的起始和结束索引。SQuAD 是标准基准。
- 开放域问答(Open-domain QA)。 不提供段落。先检索相关段落,再抽取或生成答案。这是当今每一个 RAG pipeline 的基石。
- 生成式 / 闭卷问答(Generative / Closed-book QA)。 大语言模型从参数化记忆中作答,不做检索。推理速度最快,事实可靠性最低。
2026 年的趋势是混合式:先检索出最相关的几个段落,再提示生成式模型基于这些段落作答。这就是 RAG,第 14 课会深入讲解检索那一半,本课构建问答那一半。
概念
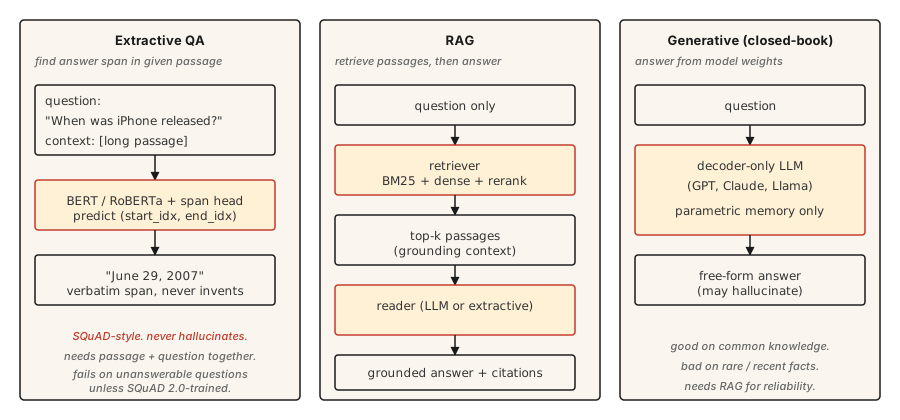
抽取式。 用 Transformer(BERT 家族)把问题和段落一起编码。训练两个头,分别预测答案的起始和结束 token 索引。损失是在有效位置上的交叉熵。输出是段落中的一个片段。按构造它永远不会产生幻觉,也按构造永远无法处理段落无法回答的问题。
检索增强(RAG)。 两个阶段。首先,检索器从语料库中找出 top-k 个段落。其次,阅读器(抽取式或生成式)基于这些段落产出答案。检索器与阅读器分离,让两者可以各自训练和评估。现代 RAG 常常在两者之间再加一个重排序器(reranker)。
生成式。 仅解码器 LLM(GPT、Claude、Llama)从学到的权重作答,没有检索步骤。对常识性知识表现出色,对稀有或近期事实一塌糊涂。幻觉率与事实在预训练数据中出现的频率呈负相关。
构建它
第 1 步:使用预训练模型的抽取式问答
pythonfrom transformers import pipeline
qa = pipeline("question-answering", model="deepset/roberta-base-squad2")
passage = (
"Apple Inc. released the first iPhone on June 29, 2007. "
"The device was announced by Steve Jobs at Macworld in January 2007."
)
question = "When was the first iPhone released?"
answer = qa(question=question, context=passage)
print(answer)python{'score': 0.98, 'start': 57, 'end': 70, 'answer': 'June 29, 2007'}deepset/roberta-base-squad2 在 SQuAD 2.0 上训练,该数据集包含无法回答的问题。默认情况下,question-answering pipeline 即使在模型的空答案得分更高时,也会返回得分最高的片段——它不会自动返回空答案。要获得显式的「无答案」行为,请在 pipeline 调用中传入 handle_impossible_answer=True:此时只有当空答案得分超过所有片段得分时,pipeline 才返回空答案。无论哪种方式,都务必检查 score 字段。
第 2 步:检索增强 pipeline(草图)
pythonfrom sentence_transformers import SentenceTransformer
import numpy as np
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
corpus = [
"Apple Inc. released the first iPhone on June 29, 2007.",
"Macworld 2007 featured the iPhone announcement by Steve Jobs.",
"Android launched in 2008 as Google's mobile operating system.",
"The first iPod was released in 2001.",
]
corpus_embeddings = encoder.encode(corpus, normalize_embeddings=True)
def retrieve(question, top_k=2):
q_emb = encoder.encode([question], normalize_embeddings=True)
sims = (corpus_embeddings @ q_emb.T).squeeze()
order = np.argsort(-sims)[:top_k]
return [corpus[i] for i in order]
def answer(question):
passages = retrieve(question, top_k=2)
combined = " ".join(passages)
return qa(question=question, context=combined)
print(answer("When was the first iPhone released?"))两阶段 pipeline。稠密检索器(Sentence-BERT)按语义相似度找到相关段落。抽取式阅读器(RoBERTa-SQuAD)从合并后的 top 段落中抽出答案片段。适用于小型语料库。对于百万文档级别的语料库,请使用 FAISS 或向量数据库。
第 3 步:带 RAG 的生成式
pythondef rag_generate(question, llm):
passages = retrieve(question, top_k=3)
prompt = f"""Context:
{chr(10).join('- ' + p for p in passages)}
Question: {question}
Answer using only the context above. If the context does not contain the answer, say "I don't know."
"""
return llm(prompt)prompt 模式很重要。明确告诉模型要基于上下文作答、上下文不足时回答 "I don't know",相比朴素提示可以把幻觉率降低 40-60%。更精细的模式还会加入引用、置信度分数和结构化抽取。
第 4 步:反映真实世界的评估
SQuAD 使用 Exact Match (EM) 和 token 级 F1。EM 是归一化(转小写、去标点、去冠词)后的严格匹配——预测要么完全一致,要么得 0 分。F1 基于预测与参考答案之间的 token 重叠计算,给出部分得分。两者都会低估同义改写:"June 29, 2007" 与 "June 29th, 2007" 通常 EM 为 0(序数词破坏了归一化),但重叠的 token 仍能带来可观的 F1。
对于生产环境的问答:
- 答案准确率(由 LLM 或人工评判,因为这些指标无法捕捉语义等价)。
- 引用准确率。 被引用的段落是否真的支持答案?用生成引用与检索段落之间的字符串匹配即可自动检查,非常简单。
- 拒答校准。 当答案不在检索到的段落中时,系统是否正确地回答 "I don't know"?衡量错误置信率。
- 检索召回率。 在评估阅读器之前,先衡量检索器是否把正确的段落放进了 top-
k。阅读器无法弥补缺失的段落。
RAGAS:2026 年的生产评估框架
RAGAS 专为 RAG 系统打造,是 2026 年的默认上线选择。它不需要黄金参考答案,就能从四个维度打分:
- 忠实度(Faithfulness)。 答案中的每个论断是否都来自检索到的上下文?用基于 NLI 的蕴含判断来衡量。这是你的首要幻觉指标。
- 答案相关性(Answer relevance)。 答案是否回应了问题?做法是从答案反推假设性问题,再与真实问题比较。
- 上下文精确率(Context precision)。 检索到的 chunks 中,实际相关的比例是多少?精确率低 = prompt 中有噪声。
- 上下文召回率(Context recall)。 检索到的集合是否包含了所有需要的信息?召回率低 = 阅读器无法成功。
无参考答案评分让你可以在线上生产流量上评估,而不必维护人工标注的黄金答案。对于精确匹配指标毫无用处的开放式问题,再叠加 LLM-as-judge。
pip install ragas。接入你的检索器 + 阅读器。每个查询得到四个标量。对回归设置告警。
使用它
2026 年的技术栈。
| 使用场景 | 推荐方案 |
|---|---|
| 给定段落,找答案片段 | deepset/roberta-base-squad2 |
| 固定语料库,闭卷不可接受 | RAG:稠密检索器 + LLM 阅读器 |
| 文档库上的实时查询 | RAG + 混合(BM25 + 稠密)检索器 + 重排序器(第 14 课) |
| 对话式问答(追问) | LLM + 对话历史 + 每轮 RAG |
| 高度事实性、受监管领域 | 在权威语料库上做抽取式;绝不单独使用生成式 |
抽取式问答在 2026 年已经不时兴了,因为 LLM + RAG 能覆盖更多场景。但在要求逐字引用的场合它仍在出货:法律研究、合规审查、审计工具。
交付它
保存为 outputs/skill-qa-architect.md:
markdown---
name: qa-architect
description: Choose QA architecture, retrieval strategy, and evaluation plan.
version: 1.0.0
phase: 5
lesson: 13
tags: [nlp, qa, rag]
---
Given requirements (corpus size, question type, factuality constraint, latency budget), output:
1. Architecture. Extractive, RAG with extractive reader, RAG with generative reader, or closed-book LLM. One-sentence reason.
2. Retriever. None, BM25, dense (name the encoder), or hybrid.
3. Reader. SQuAD-tuned model, LLM by name, or "domain-fine-tuned DistilBERT."
4. Evaluation. EM + F1 for extractive benchmarks; answer accuracy + citation accuracy + refusal calibration for production. Name what you are measuring and how you are measuring it.
Refuse closed-book LLM answers for regulatory or compliance-sensitive questions. Refuse any QA system without a retrieval-recall baseline (you cannot evaluate the reader without knowing the retriever surfaced the right passage). Flag questions that require multi-hop reasoning as needing specialized multi-hop retrievers like HotpotQA-trained systems.练习
- 简单。 在上面的 SQuAD 抽取式 pipeline 上准备 10 段 Wikipedia 文本。手工构造 10 个问题。测量答案正确的频率。如果段落和问题都干净,你应该看到 7-9 个正确。
- 中等。 增加一个拒答分类器。当最高检索分数低于阈值(比如余弦相似度 0.3)时,返回 "I don't know" 而不调用阅读器。在留出集上调阈值。
- 困难。 在你自选的一个 10,000 文档语料库上构建 RAG pipeline。实现带 RRF 融合的混合检索(BM25 + 稠密)(见第 14 课)。测量有无混合步骤时的答案准确率。记录哪些问题类型受益最大。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| Extractive QA | 找答案片段 | 在给定段落内预测答案的起始和结束索引。 |
| Open-domain QA | 语料库上的问答 | 不提供段落;必须先检索再回答。 |
| RAG | 先检索再生成 | Retrieval-augmented generation。检索器 + 阅读器 pipeline。 |
| SQuAD | 标准基准 | Stanford Question Answering Dataset。EM + F1 指标。 |
| Hallucination | 编造答案 | 阅读器的输出没有检索到的上下文支持。 |
| Refusal calibration | 知道何时闭嘴 | 无法回答时,系统正确地回答 "I don't know"。 |
延伸阅读
- Rajpurkar et al. (2016). SQuAD: 100,000+ Questions for Machine Comprehension of Text —— 基准论文。
- Karpukhin et al. (2020). Dense Passage Retrieval for Open-Domain QA —— DPR,问答领域标准的稠密检索器。
- Lewis et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks —— 命名 RAG 的论文。
- Gao et al. (2023). Retrieval-Augmented Generation for Large Language Models: A Survey —— 全面的 RAG 综述。
示意图共 1 张