问题
你有 10,000 张客服工单、50,000 篇新闻或 200,000 条推文。你需要在阅读之前就知道这批内容是关于什么的。你没有带标签的类别,甚至不知道有多少类别。
主题建模在无监督的情况下回答这个问题。给它一个语料库,返回一小组连贯的主题,以及每个文档在这些主题上的分布。
两大类算法占据主导。LDA(2003)把每个文档视为潜在主题的混合、每个主题视为词上的分布。推断是贝叶斯的。在你需要混合隶属(mixed-membership)主题分配和可解释的词级概率分布的生产场景中,它仍在出货。
BERTopic(2020)用 BERT 编码文档,用 UMAP 降维,用 HDBSCAN 聚类,再通过基于类别的 TF-IDF 提取主题词。它在短文本、社交媒体以及语义相似度比词重叠更重要的场景中胜出。一个文档只得到一个主题,这对长文本内容是个局限。
本课为两者建立直觉,并说明给定语料库时该选哪个。
概念
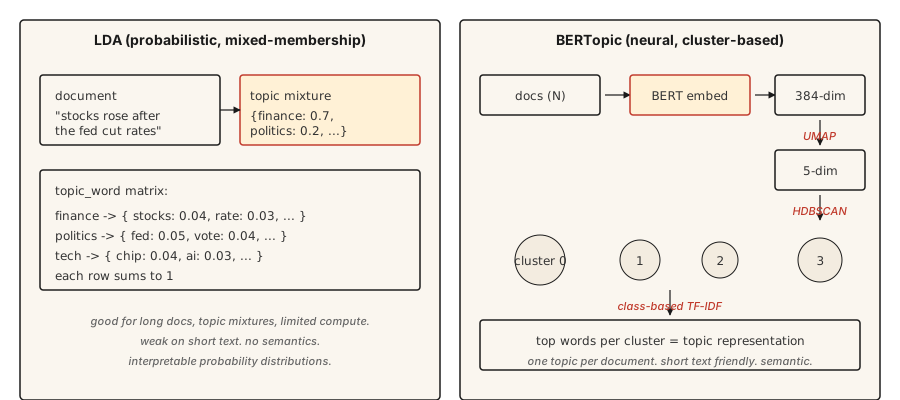
LDA 的生成故事。 每个主题是词上的一个分布。每个文档是主题的混合。要生成文档中的一个词,先从文档的主题混合中采样一个主题,再从该主题的分布中采样一个词。推断把这个过程反过来:给定观测到的词,推断每个文档的主题分布和每个主题的词分布。坍缩 Gibbs 采样或变分贝叶斯完成计算。
LDA 的关键输出:
doc_topic:矩阵(n_docs, n_topics),每行之和为 1(文档的主题混合)。topic_word:矩阵(n_topics, vocab_size),每行之和为 1(主题的词分布)。
BERTopic pipeline。
- 用句向量模型(例如
all-MiniLM-L6-v2)编码每个文档。384 维向量。 - 用 UMAP 降到约 5 维。BERT embedding 对聚类来说维度过高。
- 用 HDBSCAN 聚类。基于密度,产生大小不一的簇和一个「离群点」标签。
- 对每个簇,在该簇文档上计算基于类别的 TF-IDF,提取 top 词。
输出是每个文档一个主题(外加 -1 离群标签)。可选地,通过 HDBSCAN 的概率向量提供软隶属关系。
构建它
第 1 步:用 scikit-learn 做 LDA
pythonfrom sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation
import numpy as np
def fit_lda(documents, n_topics=5, max_features=1000):
cv = CountVectorizer(
max_features=max_features,
stop_words="english",
min_df=2,
max_df=0.9,
)
X = cv.fit_transform(documents)
lda = LatentDirichletAllocation(
n_components=n_topics,
random_state=42,
max_iter=50,
learning_method="online",
)
doc_topic = lda.fit_transform(X)
feature_names = cv.get_feature_names_out()
return lda, cv, doc_topic, feature_names
def print_top_words(lda, feature_names, n_top=10):
for idx, topic in enumerate(lda.components_):
top_idx = np.argsort(-topic)[:n_top]
words = [feature_names[i] for i in top_idx]
print(f"topic {idx}: {' '.join(words)}")注意:移除停用词,min_df 和 max_df 过滤稀有词和满街都是的词,使用 CountVectorizer(不是 TfidfVectorizer),因为 LDA 需要原始计数。
第 2 步:BERTopic(生产)
pythonfrom bertopic import BERTopic
topic_model = BERTopic(
embedding_model="sentence-transformers/all-MiniLM-L6-v2",
min_topic_size=15,
verbose=True,
)
topics, probs = topic_model.fit_transform(documents)
info = topic_model.get_topic_info()
print(info.head(20))
valid_topics = info[info["Topic"] != -1]["Topic"].tolist()
for topic_id in valid_topics[:5]:
print(f"topic {topic_id}: {topic_model.get_topic(topic_id)[:10]}")对 Topic != -1 的过滤会丢弃 BERTopic 的离群桶(HDBSCAN 无法聚类的文档)。min_topic_size 控制 HDBSCAN 的最小簇大小;BERTopic 库的默认值是 10。本例显式设为 15 以适配本课的规模。对于超过 10,000 文档的语料库,提高到 50 或 100。
第 3 步:评估
两种方法都输出主题词。问题在于这些词是否连贯。
- 主题一致性(c_v)。 在滑动窗口上下文中组合 top 词对的 NPMI(归一化逐点互信息),把分数聚合成主题向量,再用余弦相似度比较这些向量。越高越好。使用
gensim.models.CoherenceModel,设置coherence="c_v"。 - 主题多样性。 所有主题 top 词中唯一词的比例。越高越好(主题之间不重叠)。
- 定性检查。 阅读每个主题的 top 词。它们是否指向真实存在的事物?人的判断仍是最后一道防线。
何时选哪个
| 场景 | 选择 |
|---|---|
| 短文本(推文、评论、标题) | BERTopic |
| 主题混合的长文档 | LDA |
| 无 GPU / 算力有限 | LDA 或 NMF |
| 需要文档级多主题分布 | LDA |
| 集成 LLM 做主题标注 | BERTopic(直接支持) |
| 资源受限的边缘部署 | LDA |
| 最大化语义连贯性 | BERTopic |
最大的实际考量是文档长度。BERT embedding 会截断;LDA 的计数适用于任意长度。对于超过 embedding 模型上下文的文档,要么分块 + 聚合,要么用 LDA。
使用它
2026 年的技术栈:
- BERTopic。 短文本以及语义重要的场景的默认选择。
gensim.models.LdaModel。 经典生产级 LDA,成熟、久经考验。sklearn.decomposition.LatentDirichletAllocation。 用于实验的简易 LDA。- NMF。 非负矩阵分解。LDA 的快速替代品,在短文本上质量相当。
- Top2Vec。 设计与 BERTopic 类似。社区较小,但在某些基准上表现良好。
- FASTopic。 更新,在超大语料库上比 BERTopic 更快。
- 基于 LLM 的标注。 先跑任意聚类,再提示模型为每个簇命名。
交付它
保存为 outputs/skill-topic-picker.md:
markdown---
name: topic-picker
description: Pick LDA or BERTopic for a corpus. Specify library, knobs, evaluation.
version: 1.0.0
phase: 5
lesson: 15
tags: [nlp, topic-modeling]
---
Given a corpus description (document count, avg length, domain, language, compute budget), output:
1. Algorithm. LDA / NMF / BERTopic / Top2Vec / FASTopic. One-sentence reason.
2. Configuration. Number of topics: `recommended = max(5, round(sqrt(n_docs)))`, clamped to 200 for corpora under 40,000 docs; permit >200 only when the corpus is genuinely large (>40k) and note the increased compute cost. `min_df` / `max_df` filters and embedding model for neural approaches also belong here.
3. Evaluation. Topic coherence (c_v) via `gensim.models.CoherenceModel`, topic diversity, and a 20-sample human read.
4. Failure mode to probe. For LDA, "junk topics" absorbing stopwords and frequent terms. For BERTopic, the -1 outlier cluster swallowing ambiguous documents.
Refuse BERTopic on documents longer than the embedding model's context window without a chunking strategy. Refuse LDA on very short text (tweets, reviews under 10 tokens) as coherence collapses. Flag any n_topics choice below 5 as likely wrong; flag >200 on corpora under 40k docs as likely over-splitting.练习
- 简单。 在 20 Newsgroups 数据集上用 5 个主题拟合 LDA。打印每个主题的 top 10 词。手工为每个主题打标签。算法找到真实类别了吗?
- 中等。 在同一 20 Newsgroups 子集上拟合 BERTopic。比较找到的主题数、top 词和定性连贯性。哪个更干净地浮现真实类别?
- 困难。 在你的语料库上计算 LDA 和 BERTopic 的 c_v 一致性。分别用 5、10、20、50 个主题运行。绘制一致性 vs 主题数的曲线。报告哪种方法在不同主题数下更稳定。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| Topic | 语料库谈论的东西 | 词上的概率分布(LDA),或相似文档的簇(BERTopic)。 |
| Mixed membership | 文档属于多个主题 | LDA 为每个文档在所有主题上分配一个分布。 |
| UMAP | 降维 | 保留局部结构的流形学习;用于 BERTopic。 |
| HDBSCAN | 密度聚类 | 找出大小不一的簇;为离群点产生「噪声」标签(-1)。 |
| c_v coherence | 主题质量指标 | top 主题词在滑动窗口内的平均逐点互信息。 |
延伸阅读
- Blei, Ng, Jordan (2003). Latent Dirichlet Allocation —— LDA 论文。
- Grootendorst (2022). BERTopic: Neural topic modeling with a class-based TF-IDF procedure —— BERTopic 论文。
- Röder, Both, Hinneburg (2015). Exploring the Space of Topic Coherence Measures —— 引入 c_v 等指标的论文。
- BERTopic 文档 —— 生产参考。示例非常出色。
示意图共 1 张