问题
第 09 课以一个经过实测的失败收尾。在玩具复制任务上训练的 GRU 编码器-解码器,长度 5 时准确率 89%,长度 80 时掉到接近随机。原因出在结构上,不是训练 bug:编码器收集到的每一点信息都必须塞进一个固定大小的隐藏状态,而解码器再也看不到别的。
Bahdanau、Cho 和 Bengio 在 2014 年给出了一个三行改动。不要只把编码器的最终状态交给解码器,而是保留每一个编码器状态。在每个解码步,计算编码器状态的加权平均,其中权重表示「解码器此刻需要在多大程度上关注编码器位置 i?」这个加权平均就是上下文,而且它在每个解码步都会变化。
整个想法就是这样。Transformer 扩展了它。自注意力把它用在单个序列上。多头注意力让它并行运行。但 2014 年的版本已经打破了瓶颈;一旦掌握了它,转向 Transformer 就只是工程问题,而不是概念问题。
概念
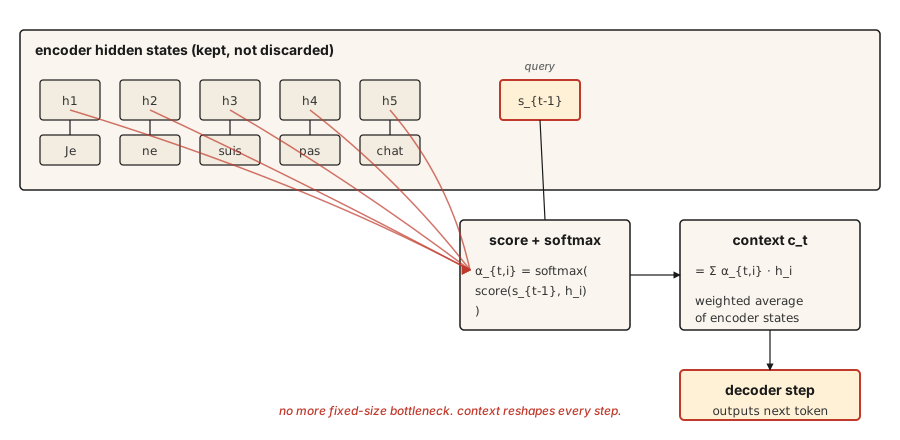
在每个解码步 t:
- 把上一步的解码器隐藏状态
s_{t-1}作为查询(query)。 - 拿它与每个编码器隐藏状态
h_1, ..., h_T打分。每个编码器位置得到一个标量。 - 对分数做 softmax,得到和为 1 的注意力权重
α_{t,1}, ..., α_{t,T}。 - 上下文向量
c_t = Σ α_{t,i} * h_i,即编码器状态的加权平均。 - 解码器接收
c_t和上一步的输出 token,产生下一个 token。
加权平均正是关键所在。解码器需要把「Je」翻成「I」时,就把「Je」对应的编码器状态权重调高,其余调低。需要「not」时,就把「pas」的权重调高。上下文向量在每一步都会重新塑形。
形状(最容易坑人的地方)
每个注意力实现在第一次写的时候都会在这里出错。慢慢读。
| 对象 | 形状 | 说明 |
|---|---|---|
编码器隐藏状态 H | (T_enc, d_h) | 如果是 BiLSTM,d_h = 2 * d_hidden |
解码器隐藏状态 s_{t-1} | (d_s,) | 一个向量 |
注意力分数 e_{t,i} | 标量 | 每个编码器位置一个 |
注意力权重 α_{t,i} | 标量 | 对所有 i 做 softmax 之后 |
上下文向量 c_t | (d_h,) | 与编码器状态形状相同 |
Bahdanau(加性)打分。 e_{t,i} = v_α^T * tanh(W_a * s_{t-1} + U_a * h_i)。
s_{t-1}形状为(d_s,),h_i形状为(d_h,)。W_a形状为(d_attn, d_s)。U_a形状为(d_attn, d_h)。- tanh 内部的求和形状为
(d_attn,)。 v_α形状为(d_attn,)。与v_α的内积会把结果压成一个标量。v_α干的就是这件事。 它并不神秘,就是把注意力维度的向量投影成标量分数的投影。
Luong(乘性)打分。 有三种变体:
dot:e_{t,i} = s_t^T * h_i。要求d_s == d_h。这是硬性约束。编码器双向时直接跳过。general:e_{t,i} = s_t^T * W * h_i,W形状为(d_s, d_h)。去掉了维度相等的约束。concat:本质上就是 Bahdanau 的形式。因为前两种更便宜,很少使用。
一个值得点名的 Bahdanau / Luong 坑。 Bahdanau 用的是 s_{t-1}(生成当前词之前的解码器状态)。Luong 用的是 s_t(之后的状态)。把两者搞混会产生微妙错误的梯度,极难调试。选一篇论文,坚持它的约定。
构建它
步骤 1:加性(Bahdanau)注意力
pythonimport numpy as np
def additive_attention(decoder_state, encoder_states, W_a, U_a, v_a):
projected_dec = W_a @ decoder_state
projected_enc = encoder_states @ U_a.T
combined = np.tanh(projected_enc + projected_dec)
scores = combined @ v_a
weights = softmax(scores)
context = weights @ encoder_states
return context, weights
def softmax(x):
x = x - np.max(x)
e = np.exp(x)
return e / e.sum()对照上面的表格检查形状。encoder_states 形状为 (T_enc, d_h)。projected_enc 形状为 (T_enc, d_attn)。projected_dec 形状为 (d_attn,),会广播。combined 形状为 (T_enc, d_attn)。scores 形状为 (T_enc,)。weights 形状为 (T_enc,)。context 形状为 (d_h,)。搞定。
步骤 2:Luong 的 dot 与 general
pythondef dot_attention(decoder_state, encoder_states):
scores = encoder_states @ decoder_state
weights = softmax(scores)
return weights @ encoder_states, weights
def general_attention(decoder_state, encoder_states, W):
projected = W.T @ decoder_state
scores = encoder_states @ projected
weights = softmax(scores)
return weights @ encoder_states, weights各三行。这就是 Luong 论文能站住脚的原因。大多数任务上精度相同,代码少得多。
步骤 3:一个数值示例
给定三个编码器状态(大致对应「cat」「sat」「mat」)以及一个与第一个最对齐的解码器状态,注意力分布会集中在位置 0。如果解码器状态偏移到与最后一个对齐,注意力就移到位置 2。上下文向量随之移动。
pythonH = np.array([
[1.0, 0.0, 0.2],
[0.5, 0.5, 0.1],
[0.1, 0.9, 0.3],
])
s_close_to_cat = np.array([0.9, 0.1, 0.2])
ctx, w = dot_attention(s_close_to_cat, H)
print("weights:", w.round(3))weights: [0.464 0.305 0.231]第一行胜出。再把解码器状态移近第三个编码器状态,观察权重变化。就是这样。注意力就是显式的对齐。
步骤 4:为什么这是通往 Transformer 的桥梁
把上面的说法翻译成 Q/K/V:
- Query = 解码器状态
s_{t-1} - Key = 编码器状态(被打分的一方)
- Value = 编码器状态(被加权求和的一方)
在经典注意力中,key 和 value 是同一个东西。自注意力把它们分开:你可以用一个序列查询它自己,K 和 V 用不同的可学习投影。多头注意力用不同的可学习投影并行运行。Transformer 把整个阶段堆叠很多次,并去掉 RNN。
数学是一样的,形状也是一样的。从 Bahdanau 注意力到缩放点积注意力,在教学上的跨越主要只是记号变化。
使用它
PyTorch 和 TensorFlow 都直接提供注意力。
pythonimport torch
import torch.nn as nn
mha = nn.MultiheadAttention(embed_dim=128, num_heads=8, batch_first=True)
query = torch.randn(2, 5, 128)
key = torch.randn(2, 10, 128)
value = torch.randn(2, 10, 128)
output, weights = mha(query, key, value)
print(output.shape, weights.shape)torch.Size([2, 5, 128]) torch.Size([2, 5, 10])这就是一个 Transformer 注意力层。query 批量为 5 个位置,key/value 批量为 10 个位置,每维 128,8 个头。output 是增强上下文后的新 query。weights 是 5x10 的对齐矩阵,可以画出来看。
经典注意力仍然重要的场景
- 教学。单头、单层、基于 RNN 的版本让每个概念都清晰可见。
- 设备端序列任务,Transformer 放不下。
- 2014-2017 年的任何论文。不了解 Bahdanau 的约定就会读错。
- 机器翻译中的细粒度对齐分析。即使在 Transformer 模型上,原始注意力权重也是一种可解释性工具;读懂它们需要知道它们究竟是什么。
「注意力权重即解释」的陷阱
注意力权重看起来很好解释。它们是跨位置求和为 1 的权重;你可以画图;权重高就意味着「看了这里」。审稿人很喜欢。
但它们并没有看起来那么好解释。Jain 和 Wallace(2019)证明,在某些任务上,注意力分布可以被置换、被任意替代,而模型预测保持不变。没有消融实验或反事实检验,绝不要把注意力权重当作推理的证据来报告。
交付它
保存为 outputs/prompt-attention-shapes.md:
markdown---
name: attention-shapes
description: Debug shape bugs in attention implementations.
phase: 5
lesson: 10
---
Given a broken attention implementation, you identify the shape mismatch. Output:
1. Which matrix has the wrong shape. Name the tensor.
2. What its shape should be, derived from (d_s, d_h, d_attn, T_enc, T_dec, batch_size).
3. One-line fix. Transpose, reshape, or project.
4. A test to catch regressions. Typically: assert `output.shape == (batch, T_dec, d_h)` and `weights.shape == (batch, T_dec, T_enc)` and `weights.sum(dim=-1) close to 1`.
Refuse to recommend fixes that silently broadcast. Broadcast-hiding bugs surface later as silent accuracy degradation, the worst kind of attention bug.
For Bahdanau confusion, insist the decoder input is `s_{t-1}` (pre-step state). For Luong, `s_t` (post-step state). For dot-product, flag dimension mismatch between query and key as the most common first-time error.练习
- 简单。 实现
softmax掩码,让编码器中的 padding token 注意力权重为零。在变长序列的 batch 上测试。 - 中等。 给 Luong 的
general形式加上多头注意力。把d_h拆成n_heads组,每组单独算注意力,再拼接。验证单头情况与你之前的实现一致。 - 困难。 在第 09 课的玩具复制任务上训练一个带 Bahdanau 注意力的 GRU 编码器-解码器。画出准确率随序列长度的变化。与无注意力基线对比。你应该会看到差距随长度增大而扩大,证实注意力解除了瓶颈。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 注意力 | 看东西 | 对 value 序列做加权平均,权重由 query-key 相似度算出。 |
| Query、Key、Value | QKV | 三种投影:Q 提问,K 是被匹配的对象,V 是返回的内容。 |
| 加性注意力 | Bahdanau | 前馈打分:v^T tanh(W q + U k)。 |
| 乘性注意力 | Luong dot / general | 分数为 q^T k 或 q^T W k。更便宜,大多数任务精度相同。 |
| 对齐矩阵 | 那张漂亮的图 | 把注意力权重看成 (T_dec, T_enc) 网格。读它就能知道模型关注了什么。 |
延伸阅读
- Bahdanau, Cho, Bengio (2014). Neural Machine Translation by Jointly Learning to Align and Translate——原论文。
- Luong, Pham, Manning (2015). Effective Approaches to Attention-based Neural Machine Translation——三种打分变体及其比较。
- Jain and Wallace (2019). Attention is not Explanation——可解释性的注意事项。
- Dive into Deep Learning——Bahdanau 注意力——带 PyTorch 的可运行讲解。
示意图共 1 张