问题
用户说 "I want to change my flight."。系统必须弄清他们要什么、缺什么信息、怎么获取,以及如何完成操作。然后用户说 "wait, what if I cancel instead?",系统必须记住上下文、切换任务并保持状态。
对话对 ML 系统来说很难。输入是开放式的。输出必须在许多轮之后仍保持连贯。系统可能需要对世界采取行动(改签航班、扣款)。每一步错误用户都看得见。
聊天机器人架构经历了四种范式,每一种的出现都是因为上一种失败得太明显。本课按顺序走过它们。2026 年的生产图景是最后两种的混合。
概念
剧本化的半个世纪,1950-2001
第一种范式没有持续五年。它持续了五十年。了解它的历程很重要,因为它里面的每个系统都是同一台机器——匹配输入、发出预设回复、更新一点状态——而五十年往这台机器上加规则,从未产出通用情况。正是这个天花板催生了第二到第四种范式。
1950。 Turing 绕开「机器能思考吗?」,提出一个可操作的替代方案:如果审讯者在电传打字机上无法把机器与人区分开,这个哲学问题就没有意义。对话在领域有名字之前,就成为了该领域的基准。
1956。 名字来了——达特茅斯的一次夏季工作坊创造了 "artificial intelligence",基于一个猜想:智能的每个特征「原则上都可以被如此精确地描述,以至于可以造一台机器来模拟它」。提案为取得实质性进展预留了两个月。
1966。 ELIZA 发布了你在第 1 步中构建的反射技巧:分解规则从输入中提取片段,重组规则把它们作为问题回抛。总共约 200 条模式,零状态,零理解——而用户依然对它倾诉。Weizenbaum 余生都惊叹于它所需的机械装置竟如此之少。
1972。 在 Stanford 为模拟偏执而构建的 PARRY 补上了 ELIZA 缺失的一环:内部状态。恐惧、愤怒、不信任的数值变量每轮更新,并控制下一步触发哪个脚本,因此相同的输入会依据此前对话产生不同的回复。在盲测转录实验中,精神科医生区分 PARRY 和真实病人的表现等同随机。它是人格设定的直系祖先——一个由三个浮点数实现的 system prompt。同年,两个机器人通过 ARPANET 互相对话:一个治疗师脚本采访一个偏执状态机,这是网络上第一次机器人对机器人的对话。
1995。 ALICE 用 AIML 扩展了 ELIZA 配方,AIML 是一种用于模式-模板对的 XML 方言。约 40,000 个手写类别,三次 Loebner 奖。它证明了规则系统的扩展定律:更多规则买到覆盖,永远买不到通用性。每条规则都是某人必须维护的负债。
2001。 SmarterChild 把配方摆到 3000 万即时通讯用户面前,并加入后端查询——天气、股票、电影时刻——拼接进模板。眯眼一看,它就是穿着 2001 年戏服的 tool call:解析意图、调用服务、把结果渲染进回复。
五十年,一个机制,规则数不断上升。这个范式终结不是因为有人证伪了它,而是因为手写状态机的维护成本随覆盖线性增长,而用户期望随他们上周看到的任何东西增长。
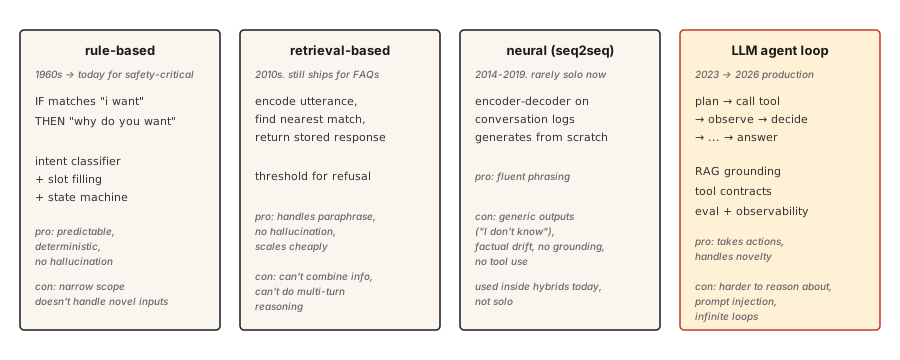
规则式(ELIZA、AIML、DialogFlow)。 手工编写的模式匹配用户输入并产生回复。意图分类器路由到预定义流程。槽位填充状态机收集所需信息。在它被设计好的狭窄范围内表现出色,一超出就立刻失效。在不容忍幻觉的安全关键领域(银行认证、机票预订)仍在出货。
检索式。 FAQ 风格的系统。把每一对(话语、回复)编码。运行时编码用户消息,检索最近的已存回复。想想 Zendesk 经典的「相似文章」功能。比规则更能处理同义改写。不生成,所以无幻觉。
神经式(seq2seq)。 在对话日志上训练的编码器-解码器。从零生成回复。流畅但容易输出泛泛之词("I don't know")和事实漂移。从未可靠地切题。这就是 Google、Facebook 和 Microsoft 在 2016-2019 年都推出过令人失望的聊天机器人的原因。
LLM Agent。 一个语言模型,包裹在能规划、调用工具并验证结果的循环中。不是带长 prompt 的聊天机器人。而是 Agent 循环:规划 → 调用工具 → 观察结果 → 决定下一步。检索优先的锚定(RAG)防止幻觉。Tool call 让它真正做事。这是 2026 年的架构。
四种范式不是顺序替换关系。2026 年的生产聊天机器人会经过全部四种:规则式用于认证和破坏性操作,检索式用于 FAQ,神经生成用于自然措辞,LLM Agent 用于模糊的开放式查询。
构建它
第 1 步:基于规则的模式匹配
pythonimport re
class RulePattern:
def __init__(self, pattern, response_template):
self.regex = re.compile(pattern, re.IGNORECASE)
self.template = response_template
PATTERNS = [
RulePattern(r"my name is (\w+)", "Nice to meet you, {0}."),
RulePattern(r"i (need|want) (.+)", "Why do you {0} {1}?"),
RulePattern(r"i feel (.+)", "Why do you feel {0}?"),
RulePattern(r"(.*)", "Tell me more about that."),
]
def rule_based_respond(user_input):
for pattern in PATTERNS:
m = pattern.regex.match(user_input.strip())
if m:
return pattern.template.format(*m.groups())
return "I don't understand."20 行实现 ELIZA。反射技巧("I feel sad" → "Why do you feel sad")是 Weizenbaum 1966 年的经典心理治疗演示。仍然有教育意义。
第 2 步:基于检索的(FAQ)
这个说明性片段需要 pip install sentence-transformers(会连带安装 torch)。本课可运行的 code/main.py 改用标准库的 Jaccard 相似度,因此无需外部依赖即可运行。
pythonfrom sentence_transformers import SentenceTransformer
import numpy as np
FAQ = [
("how do i reset my password", "Go to Settings > Security > Reset Password."),
("how do i cancel my order", "Go to Orders, find the order, click Cancel."),
("what is your return policy", "30-day returns on unused items, original packaging."),
]
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
faq_questions = [q for q, _ in FAQ]
faq_embeddings = encoder.encode(faq_questions, normalize_embeddings=True)
def faq_respond(user_input, threshold=0.5):
q_emb = encoder.encode([user_input], normalize_embeddings=True)[0]
sims = faq_embeddings @ q_emb
best = int(np.argmax(sims))
if sims[best] < threshold:
return None
return FAQ[best][1]基于阈值的拒答是关键设计选择。如果最佳匹配不够接近,返回 None,让系统升级处理。
第 3 步:神经生成(基线)
使用一个小型指令微调编码器-解码器(FLAN-T5)或一个微调过的对话模型。2026 年单独使用在生产中不可用(矛盾、跑题、事实胡言),但会作为混合系统的一部分用于自然措辞。DialoGPT 风格的仅解码器模型需要显式的轮次分隔符和 EOS 处理才能产生连贯回复;FLAN-T5 的 text2text pipeline 开箱即用,适合教学示例。
pythonfrom transformers import pipeline
chatbot = pipeline("text2text-generation", model="google/flan-t5-small")
response = chatbot("Respond politely to: Hi there!", max_new_tokens=40)
print(response[0]["generated_text"])第 4 步:LLM Agent 循环
2026 年的生产形态:
pythondef agent_loop(user_message, tools, llm, max_steps=5):
history = [{"role": "user", "content": user_message}]
for _ in range(max_steps):
response = llm(history, tools=tools)
tool_call = response.get("tool_call")
if tool_call:
tool_name = tool_call.get("name")
args = tool_call.get("arguments")
if not isinstance(tool_name, str) or tool_name not in tools:
history.append({"role": "assistant", "tool_call": tool_call})
history.append({"role": "tool", "name": str(tool_name), "content": f"error: unknown tool {tool_name!r}"})
continue
if not isinstance(args, dict):
history.append({"role": "assistant", "tool_call": tool_call})
history.append({"role": "tool", "name": tool_name, "content": f"error: arguments must be a dict, got {type(args).__name__}"})
continue
fn = tools[tool_name]
result = fn(**args)
history.append({"role": "assistant", "tool_call": tool_call})
history.append({"role": "tool", "name": tool_name, "content": result})
else:
return response["content"]
return "I could not complete the task in the step budget."有三样东西要命名。工具是 LLM 可以调用的可调用函数。当 LLM 返回最终答案而不是 tool call 时,循环终止。步数预算防止在模糊任务上无限循环。
真实生产还会加入:检索优先的锚定(每次 LLM 调用前注入相关文档)、防护栏(未经确认拒绝破坏性操作)、可观测性(记录每一步)和评估(自动检查 Agent 行为是否保持在规范内)。
第 5 步:混合路由
pythondef hybrid_chat(user_input):
if is_destructive_action(user_input):
return structured_flow(user_input)
faq_answer = faq_respond(user_input, threshold=0.6)
if faq_answer:
return faq_answer
return agent_loop(user_input, tools, llm)
def is_destructive_action(text):
danger_words = ["delete", "cancel", "charge", "refund", "transfer"]
return any(w in text.lower() for w in danger_words)模式:破坏性操作走确定性规则,预置 FAQ 走检索,其他一切走 LLM Agent。这是 2026 年客服系统的出货形态。
使用它
2026 年的技术栈:
| 使用场景 | 架构 |
|---|---|
| 预订、支付、认证 | 规则式状态机 + 槽位填充 |
| 客服 FAQ | 对精选答案的检索 |
| 开放式帮助聊天 | 带 RAG + tool calling 的 LLM Agent |
| 内部工具 / IDE 助手 | 带 tool calls(搜索、读、写)的 LLM Agent |
| 陪伴 / 角色聊天机器人 | 带人格 system prompt 的调优 LLM,对知识做检索 |
生产中始终使用混合路由。没有单一架构能处理好每个请求。路由层本身通常是一个小型意图分类器。
仍在出货的失败模式
- 自信的编造。 LLM Agent 声称完成了它实际没完成的操作。缓解:验证结果,记录 tool call,绝不让 LLM 在工具没有成功返回的情况下声称做过某事。
- 提示注入(Prompt injection)。 用户插入文本覆盖 system prompt。在 OWASP Top 10 for LLM Applications 2025 中排名 LLM01。两种形式:直接注入(粘贴进聊天)和间接注入(隐藏在文档、邮件或 Agent 读取的工具输出中)。
攻击率因场景而异。在通用工具使用和编码基准中,前沿模型测得的成功率范围约为 0.5-8.5%。特定高风险设置(针对 AI 编码 Agent 的自适应攻击、脆弱的编排)曾达到约 84%。生产中的 CVE 包括 EchoLeak(CVE-2025-32711,CVSS 9.3)——Microsoft 365 Copilot 中一个由攻击者控制的邮件触发的零点击数据泄露漏洞。
缓解措施:在整个循环中把用户输入视为不可信;调用工具前做清洗;把工具输出与主 prompt 隔离;采用 Plan-Verify-Execute(PVE)模式,Agent 先规划,然后在执行前对照计划验证每个动作(这能阻止工具结果注入新的计划外动作);破坏性操作要求用户确认;对工具作用域应用最小权限。
任何 prompt 工程都无法完全消除这一风险。需要外部运行时防御层(LLM Guard、allowlist 校验、语义异常检测)。
- 范围蔓延(Scope creep)。 Tool call 返回了带点关系的无关信息,导致 Agent 跑题。缓解:收窄工具契约;保持 system prompt 聚焦;为跑题率增加评估。
- 无限循环。 Agent 不断调用同一个工具。缓解:步数预算、tool call 去重、用 LLM 裁判判断「我们是否在取得进展」。
- 上下文窗口耗尽。 长对话把最早的轮次挤出上下文。缓解:摘要旧轮次、按相似度检索相关过去轮次,或使用长上下文模型。
交付它
保存为 outputs/skill-chatbot-architect.md:
markdown---
name: chatbot-architect
description: Design a chatbot stack for a given use case.
version: 1.0.0
phase: 5
lesson: 17
tags: [nlp, agents, chatbot]
---
Given a product context (user need, compliance constraints, available tools, data volume), output:
1. Architecture. Rule-based, retrieval, neural, LLM agent, or hybrid (specify which paths go where).
2. LLM choice if applicable. Name the model family (Claude, GPT-4, Llama-3.1, Mixtral). Match to tool-use quality and cost.
3. Grounding strategy. RAG sources, retrieval method (see lesson 14), tool contracts.
4. Evaluation plan. Task success rate, tool-call correctness, off-task rate, hallucination rate on held-out dialogs.
Refuse to recommend a pure-LLM agent for any destructive action (payments, account deletion, data modification) without a structured confirmation flow. Refuse to skip the prompt-injection audit if the agent has write access to anything.练习
- 简单。 用上面的规则式回复实现一个咖啡店点单机器人,10 条模式。测试边界情况:重复下单、修改、取消、意图不清。
- 中等。 构建一个混合 FAQ + LLM 兜底。为某个 SaaS 产品准备 50 条预置 FAQ,LLM 兜底在文档站上做检索。在 100 个真实支持问题上测量拒答率和准确率。
- 困难。 用三个工具(search、read-user-data、send-email)实现上面的 Agent 循环。用 50 个测试场景(包括提示注入尝试)运行评估。报告跑题率、任务失败率和任何注入成功。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| Intent | 用户想要什么 | 类别标签(book_flight、reset_password)。路由到处理器。 |
| Slot | 一条信息 | 机器人需要的参数(日期、目的地)。槽位填充就是一连串提问。 |
| RAG | 检索加生成 | 检索相关文档,再让 LLM 的回复有据可依。 |
| Tool call | Function call | LLM 发出带有名称 + 参数的结构化调用。运行时执行并返回结果。 |
| Agent loop | 规划、行动、验证 | 控制器,让 LLM 调用与 tool calls 交错进行,直到任务完成。 |
| Prompt injection | 用户攻击 prompt | 试图覆盖 system prompt 的恶意输入。 |
延伸阅读
- Turing (1950). Computing Machinery and Intelligence —— 让对话成为领域基准的论文。
- Weizenbaum (1966). ELIZA — A Computer Program For the Study of Natural Language Communication —— 原版基于规则的聊天机器人论文。
- Colby, Weber, Hilf (1971). Artificial Paranoia —— PARRY 的情感变量架构,第一个有状态的聊天机器人。
- Thoppilan et al. (2022). LaMDA: Language Models for Dialog Applications —— Google 晚期的神经聊天机器人论文,就在 LLM Agent 接管之前。
- Yao et al. (2022). ReAct: Synergizing Reasoning and Acting in Language Models —— 命名 Agent 循环模式的论文。
- Anthropic 关于构建有效 Agent 的指南 —— 2024 年的生产指导,在 2026 年依然成立。
- Greshake et al. (2023). Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection —— 提示注入论文。
- OWASP Top 10 for LLM Applications 2025 — LLM01 Prompt Injection —— 让提示注入成为头号安全关切的排名。
- AWS — Securing Amazon Bedrock Agents against Indirect Prompt Injections —— 实用的编排层防御,包括 Plan-Verify-Execute 和用户确认流程。
- EchoLeak (CVE-2025-32711) —— 间接提示注入导致的典型零点击数据泄露 CVE。这是写权限 Agent 为何需要运行时防御的参考案例。
示意图共 1 张