问题
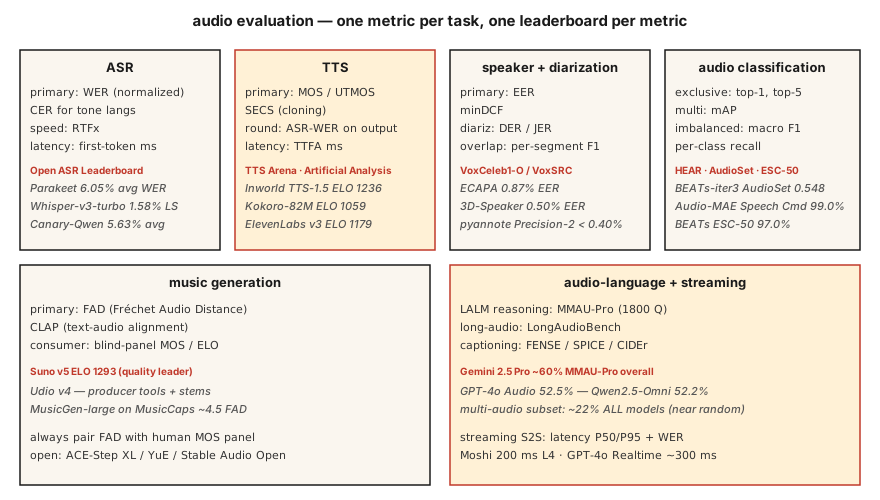
每个音频任务都有多个指标,各自测量不同的维度。用错指标,你就会交付一个在仪表盘上看起来很棒、在生产中却很糟糕的模型。2026 年的权威列表:
| 任务 | 主要 | 次要 |
|---|---|---|
| ASR | WER | CER · RTFx · 首 token 延迟 |
| TTS | MOS / UTMOS | SECS · ASR 往返 WER · CER · TTFA |
| 语音克隆 | SECS(ECAPA 余弦) | MOS · CER |
| 说话人验证 | EER | minDCF · 工作点上的 FAR / FRR |
| 说话人分离 | DER | JER · 说话人混淆 |
| 音频分类 | top-1 · mAP | macro F1 · 每类召回 |
| 音乐生成 | FAD | CLAP · 听测小组 MOS |
| 音频语言模型 | MMAU-Pro | LongAudioBench · AudioCaps FENSE |
| 流式 S2S | 延迟 P50/P95 | WER · MOS |
概念
ASR 指标
WER(词错误率)。 (S + D + I) / N。评分前转小写、去标点、归一化数字。使用 jiwer 或 OpenAI 的 whisper_normalizer。< 5% = 朗读语音达到人类水平。
CER(字符错误率)。 同样的公式,字符级。用于声调语言(普通话、粤语),因为那里的分词有歧义。
RTFx(实时因子倒数)。 每墙钟秒处理的音频秒数。越高越好。Parakeet-TDT 达到 3380×。Whisper-large-v3 约 30×。
首 token 延迟。 从音频输入到第一个转写 token 的墙钟时间。对流式至关重要。Deepgram Nova-3:约 150 ms。
TTS 指标
MOS(平均意见分)。 1-5 分的人工评分。黄金标准但慢。每个样本收集 20+ 名听众,每个模型 100+ 个样本。
UTMOS(2022-2026)。 学习的 MOS 预测器。在标准基准上与人类 MOS 相关性约 0.9。F5-TTS:UTMOS 3.95;真实值:4.08。
SECS(说话人编码器余弦相似度)。 用于语音克隆。参考音频与克隆输出之间的 ECAPA embedding 余弦。> 0.75 = 可识别的克隆。
ASR 往返 WER。 对 TTS 输出跑 Whisper,针对输入文本计算 WER。捕捉可懂度退化。2026 年 SOTA:< 2% CER。
TTFA(首个音频时间)。 墙钟延迟。Kokoro-82M:约 100 ms;F5-TTS:约 1 s。
语音克隆专用
SECS + MOS + CER 三者组合。SECS 高但 MOS 低的克隆意味着音色对了但不自然;反过来则是声音自然但说话人不对。
说话人验证
EER(等错误率)。 假接受率等于假拒绝率时的阈值。VoxCeleb1-O 上的 ECAPA:0.87%。
minDCF(最小检测代价)。 在选定工作点(通常是 FAR=0.01)的加权代价。比 EER 更贴近生产。
说话人分离
DER(说话人分离错误率)。 (FA + Miss + Confusion) / total_speaker_time。漏检语音 + 虚警语音 + 说话人混淆,各自作为比例。AMI 会议:DER 约 10-20% 是现实的。pyannote 3.1 + Precision-2 商业版:在录制良好的音频上 DER <10%。
JER(Jaccard 错误率)。 DER 的替代,对短片段偏差更鲁棒。
音频分类
多标签:所有类别上的 mAP(平均精度均值)。AudioSet:BEATs-iter3 为 0.548 mAP。
多类互斥:top-1、top-5 准确率。Speech Commands v2:99.0% top-1(Audio-MAE)。
不平衡:macro F1 + 每类召回。要报告每类——聚合准确率会掩盖哪些类失败。
音乐生成
FAD(Fréchet 音频距离)。 真实音频与生成音频的 VGGish embedding 分布之间的距离。MusicGen-small 在 MusicCaps 上:4.5。MusicLM:4.0。越低越好。
CLAP 分数。 使用 CLAP embedding 的文本-音频对齐分数。> 0.3 = 合理对齐。
听测小组 MOS。 仍然是消费级音乐的最终裁决。Suno v5 在 TTS Arena 上 ELO 1293(来自配对人类偏好)。
音频语言基准
MMAU(大规模多音频理解)。 1 万个音频问答对。
MMAU-Pro。 1800 个困难条目,四个类别:语音 / 声音 / 音乐 / 多音频。4 选 1 随机概率 25%。Gemini 2.5 Pro 总体约 60%;跨所有模型的多音频约 22%。
LongAudioBench。 数分钟长的片段配语义查询。Audio Flamingo Next 击败 Gemini 2.5 Pro。
AudioCaps / Clotho。 描述生成基准。SPICE、CIDEr、FENSE 指标。
流式语音到语音
延迟 P50 / P95 / P99。 从用户语音结束到第一个可听响应的墙钟时间。Moshi:200 ms;GPT-4o Realtime:300 ms。
输出上的 WER / MOS。
打断响应性。 从用户打断到助手静音的时间。目标 < 150 ms。
2026 年排行榜
| 排行榜 | 赛道 | URL |
|---|---|---|
| Open ASR Leaderboard(HF) | 英语 + 多语言 + 长音频 | huggingface.co/spaces/hf-audio/open_asr_leaderboard |
| TTS Arena(HF) | 英语 TTS | huggingface.co/spaces/TTS-AGI/TTS-Arena |
| Artificial Analysis Speech | TTS + STT,来自配对投票的 ELO | artificialanalysis.ai/speech |
| MMAU-Pro | LALM 推理 | sonalkum.github.io/mmau-pro |
| SpeakerBench / VoxSRC | 说话人识别 | voxsrc.github.io |
| MMAU 音乐子集 | 音乐 LALM | (在 MMAU 内) |
| HEAR benchmark | 自监督音频 | hearbenchmark.com |
构建它
第 1 步:带归一化的 WER
pythonfrom jiwer import wer, Compose, ToLowerCase, RemovePunctuation, Strip
transform = Compose([ToLowerCase(), RemovePunctuation(), Strip()])
score = wer(
truth="Please turn on the lights.",
hypothesis="please turn on the light",
truth_transform=transform,
hypothesis_transform=transform,
)
# ~0.17第 2 步:TTS 往返 WER
pythondef ttr_wer(tts_model, asr_model, texts):
errors = []
for txt in texts:
audio = tts_model.synthesize(txt)
recog = asr_model.transcribe(audio)
errors.append(wer(truth=txt, hypothesis=recog))
return sum(errors) / len(errors)第 3 步:用于语音克隆的 SECS
pythonfrom speechbrain.inference.speaker import EncoderClassifier
sv = EncoderClassifier.from_hparams("speechbrain/spkrec-ecapa-voxceleb")
emb_ref = sv.encode_batch(load_wav("reference.wav"))
emb_clone = sv.encode_batch(load_wav("cloned.wav"))
secs = torch.nn.functional.cosine_similarity(emb_ref, emb_clone, dim=-1).item()第 4 步:用于音乐生成的 FAD
pythonfrom frechet_audio_distance import FrechetAudioDistance
fad = FrechetAudioDistance()
score = fad.get_fad_score("generated_folder/", "reference_folder/")第 5 步:用于说话人验证的 EER(与第 6 课相同的代码)
pythondef eer(same_scores, diff_scores):
thresholds = sorted(set(same_scores + diff_scores))
best = (1.0, 0.0)
for t in thresholds:
far = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
frr = sum(1 for s in same_scores if s < t) / len(same_scores)
if abs(far - frr) < best[0]:
best = (abs(far - frr), (far + frr) / 2)
return best[1]使用它
每次部署都配一个固定的评估工具,在每次模型更新时运行。三条基本规则:
- 评分前先归一化。 转小写、去标点、展开数字。报告归一化规则。
- 报告分布,而不是平均值。 延迟用 P50/P95/P99。分类用每类召回。MMAU 用每类目。
- 跑一个标准的公开基准。 即使你的生产数据不同,在 Open ASR / TTS Arena / MMAU 上报告能让评审者做同类比较。
陷阱
- UTMOS 外推。 在 VCTK 风格的干净语音上训练;对嘈杂/克隆/情感音频评分很差。
- MOS 小组偏差。 20 个 Amazon Mechanical Turk 工人 ≠ 20 个目标用户。高风险时花钱请领域小组。
- FAD 依赖参考集。 跨模型比较时使用相同的参考分布。
- 聚合 WER。 总体 5% 的 WER 可能掩盖带口音语音上 30% 的 WER。按人群切片报告。
- 公开基准饱和。 大多数前沿模型在标准基准上接近天花板。构建一个反映你流量的内部留出集。
交付它
保存为 outputs/skill-audio-evaluator.md。为任何音频模型发布选择指标、基准和报告格式。
练习
- 简单。 运行
code/main.py。在玩具输入上计算 WER / CER / EER / SECS / 类 FAD / 类 MMAU。 - 中等。 构建一个 TTS 往返 WER 工具。把 Kokoro 或 F5-TTS 的输出过一遍 Whisper。对 50 个提示计算 WER。标记 WER > 10% 的提示。
- 困难。 在 MMAU-Pro 的语音 + 多音频子集(各 50 题)上给你的第 10 课 LALM 选择打分。报告每类准确率,并与已发布数字比较。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| WER | ASR 分数 | 归一化后词级的 (S+D+I)/N。 |
| CER | 字符 WER | 用于声调语言或字符级系统。 |
| MOS | 人类意见 | 1-5 评分;20+ 听众 × 100 样本。 |
| UTMOS | ML MOS 预测器 | 学习模型;与人类 MOS 相关性约 0.9。 |
| SECS | 语音克隆相似度 | 参考与克隆之间的 ECAPA 余弦。 |
| EER | 说话人验证分数 | FAR = FRR 处的阈值。 |
| DER | 说话人分离分数 | (FA + Miss + Confusion) / total。 |
| FAD | 音乐生成质量 | VGGish embedding 上的 Fréchet 距离。 |
| RTFx | 吞吐量 | 每墙钟秒的音频秒数。 |
进一步阅读
- jiwer —— 带归一化工具的 WER/CER 库。
- UTMOS (Saeki et al. 2022) —— 学习的 MOS 预测器。
- Fréchet Audio Distance (Kilgour et al. 2019) —— 音乐生成标准。
- Open ASR Leaderboard —— 2026 实时排名。
- TTS Arena —— 人类投票的 TTS 排行榜。
- MMAU-Pro benchmark —— LALM 推理排行榜。
- HEAR benchmark —— 音频 SSL 基准。
示意图共 1 张