问题
你有一个字符串:"Please remind me to water the plants at 6 pm."。你需要一段 3 秒的音频,听起来自然,韵律(停顿、重音)正确,"plants" 的元音发得准,并且能在 CPU 上以不到 300 ms 的时间运行,用于实时语音助手。你还需要更换音色、处理语码转换输入("remind me at 6 pm, daijoubu?"),并且不要在名字上出丑。
现代 TTS pipeline 如下:
- 文本前端。 规范化文本(日期、数字、邮箱),转换为音素或子词 token,预测韵律特征。
- 声学模型。 文本 → mel 频谱。Tacotron 2(2017)、FastSpeech 2(2020)、VITS(2021)、F5-TTS(2024)、Kokoro(2024)。
- 声码器。 mel → 波形。WaveNet(2016)、WaveRNN、HiFi-GAN(2020)、BigVGAN(2022),以及 2024 年以后的神经编解码器声码器。
到 2026 年,声学模型与声码器的分界已被端到端扩散模型和流匹配模型模糊。但调试时,三分法的思维模型依然成立。
概念
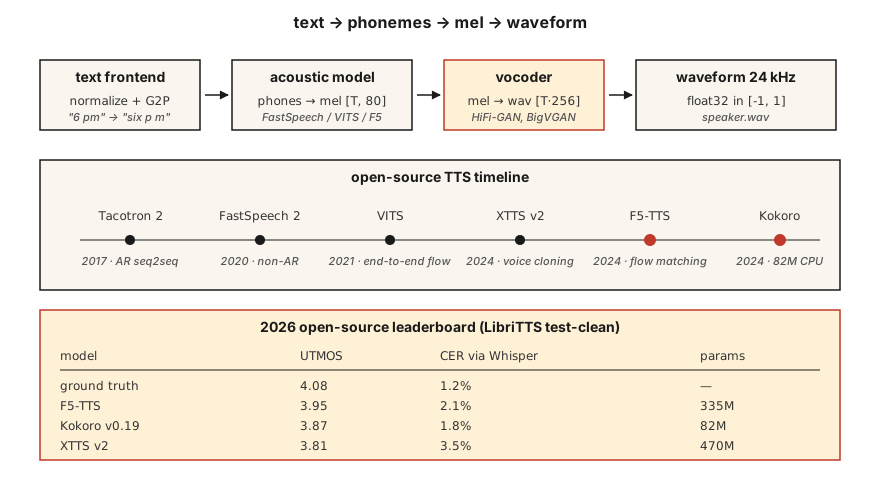
Tacotron 2(2017)。 Seq2seq:字符嵌入 → BiLSTM 编码器 → 位置敏感注意力 → 自回归 LSTM 解码器逐帧输出 mel 帧。速度慢(AR),长文本上不稳定。至今仍被引用为基线。
FastSpeech 2(2020)。 非自回归。时长预测器输出每个音素对应多少个 mel 帧。单次前向,比 Tacotron 快 10 倍。牺牲了一些自然度(单调对齐),但到处都在用。
VITS(2021)。 用变分推断端到端联合训练编码器 + 基于流的时长模型 + HiFi-GAN 声码器。质量高,单一模型。2022–2024 年开源 TTS 的主流。变体:YourTTS(多说话人零样本)、XTTS v2(2024,Coqui)。
F5-TTS(2024)。 在流匹配(flow matching)之上构建的扩散 Transformer。韵律自然,用 5 秒参考音频即可零样本克隆声音。2026 年开源 TTS 排行榜榜首。335M 参数。
Kokoro(2024)。 小巧(82M),可在 CPU 上运行,实时场景下英语 TTS 同类最佳。封闭词表、仅英语,apache-2.0。
OpenAI TTS-1-HD、ElevenLabs v2.5、Google Chirp-3。 商业界的最先进水平。ElevenLabs v2.5 的情感标签("[whispered]"、"[laughing]")和角色音色主导了 2026 年的有声书制作。
声码器的演进
| 时期 | 声码器 | 延迟 | 质量 |
|---|---|---|---|
| 2016 | WaveNet | 仅离线 | 发布时为 SOTA |
| 2018 | WaveRNN | 约实时 | 良好 |
| 2020 | HiFi-GAN | 实时的 100 倍 | 接近真人 |
| 2022 | BigVGAN | 实时的 50 倍 | 可跨说话人/语言泛化 |
| 2024 | SNAC、DAC(神经编解码器) | 与 AR 模型集成 | 离散 token,比特效率高 |
到 2026 年,多数「TTS」模型都是文本到波形的端到端模型;mel 频谱只是一种内部表示。
评估
- MOS(平均意见得分)。 1–5 分制,众包打分。仍是金标准;但慢得令人痛苦。
- CMOS(对比 MOS)。 A 对 B 的偏好。每次标注的置信区间更窄。
- UTMOS、DNSMOS。 无参考的神经 MOS 预测器。用于排行榜。
- CER(字符错误率),经由 ASR 计算。 把 TTS 输出送进 Whisper,针对输入文本计算 CER。作为可懂度的代理指标。
- SECS(说话人嵌入余弦相似度)。 声音克隆质量。
LibriTTS test-clean 上的 2026 年数据:
| 模型 | UTMOS | CER(经 Whisper) | 规模 |
|---|---|---|---|
| 真实音频(Ground truth) | 4.08 | 1.2% | — |
| F5-TTS | 3.95 | 2.1% | 335M |
| XTTS v2 | 3.81 | 3.5% | 470M |
| VITS | 3.62 | 3.1% | 25M |
| Kokoro v0.19 | 3.87 | 1.8% | 82M |
| Parler-TTS Large | 3.76 | 2.8% | 2.3B |
构建它
第 1 步:把输入音素化
pythonfrom phonemizer import phonemize
ph = phonemize("Hello world", language="en-us", backend="espeak")
# 'həloʊ wɜːld'音素是通用的桥梁。低于 VITS 质量水平的模型,不要直接喂原始文本。
第 2 步:运行 Kokoro(2026 年 CPU 默认选择)
pythonfrom kokoro import KPipeline
tts = KPipeline(lang_code="a") # "a" = American English
audio, sr = tts("Please remind me to water the plants at 6 pm.", voice="af_bella")
# audio: float32 tensor, sr=24000离线运行,单文件,82M 参数。
第 3 步:用 F5-TTS 做声音克隆
pythonfrom f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
ref_file="my_voice_5s.wav",
ref_text="The quick brown fox jumps over the lazy dog.",
gen_text="Please remind me to water the plants.",
)传入一段 5 秒参考音频及其转写文本;F5 会克隆韵律和音色。
第 4 步:从零实现 HiFi-GAN 声码器
完整实现太大,放不进教程脚本,但结构是这样的:
pythonclass HiFiGAN(nn.Module):
def __init__(self, mel_channels=80, upsample_rates=[8, 8, 2, 2]):
super().__init__()
# 4 upsample blocks, total 256x to go from mel-rate to audio-rate
...
def forward(self, mel):
return self.blocks(mel) # -> waveform训练:对抗损失(在短窗口上使用判别器)+ mel 频谱重建损失 + 特征匹配损失。这项技术已经商品化——直接使用 hifi-gan 仓库或 nvidia-NeMo 的预训练 checkpoint。
第 5 步:完整 pipeline(伪代码)
pythontext = "Please remind me at 6 pm."
phones = phonemize(text)
mel = acoustic_model(phones, speaker=alice) # [T, 80]
wav = vocoder(mel) # [T * 256]
soundfile.write("out.wav", wav, 24000)使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| 实时英语语音助手 | Kokoro(CPU)或 XTTS v2(GPU) |
| 用 5 秒参考做声音克隆 | F5-TTS |
| 商业角色音色 | ElevenLabs v2.5 |
| 有声书旁白 | ElevenLabs v2.5 或 XTTS v2 + 微调 |
| 低资源语言 | 在 5–20 小时目标语言数据上训练 VITS |
| 富有表现力 / 情感标签 | ElevenLabs v2.5 或微调 StyleTTS 2 |
截至 2026 年的开源领跑者:质量选 F5-TTS,效率选 Kokoro。除非你在做历史研究,否则不要碰 Tacotron。
常见陷阱
- 没有文本规范化器。 "Dr. Smith" 读成 "Doctor" 还是 "Drive"?"2026" 读成 "twenty twenty six" 还是 "two zero two six"?要在音素化之前做规范化。
- 未登录(OOV)专有名词。 "Ghumare" → "ghyu-mair"?为未知 token 提供一个回退的字素到音素(grapheme-to-phoneme)模型。
- 削波。 声码器输出很少削波,但推理时 mel 缩放不匹配可能让幅度超过 ±1.0。始终执行
np.clip(wav, -1, 1)。 - 采样率不匹配。 Kokoro 输出 24 kHz;下游 pipeline 期望 16 kHz → 重采样,否则会产生混叠。
交付它
保存为 outputs/skill-tts-designer.md。为给定的音色、延迟和语言目标设计一条 TTS pipeline。
练习
- 简单。 运行
code/main.py。它会从一个小词表构建音素字典,估计每个音素的时长,并打印一份模拟的「mel」时间表。 - 中等。 安装 Kokoro,用
af_bella和am_adam两个音色合成同一句话。比较音频时长和主观质量。 - 困难。 录一段自己 5 秒的参考音频。用 F5-TTS 克隆它。报告参考音频与克隆输出之间的 SECS。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 音素(Phoneme) | 声音单位 | 抽象的声音类别;英语中有 39 个(ARPABet)。 |
| 时长预测器 | 每个音素持续多久 | 非自回归模型的输出;每个音素的整数帧数。 |
| 声码器(Vocoder) | mel → 波形 | 把 mel 频谱映射为原始采样点的神经网络。 |
| HiFi-GAN | 标准声码器 | 基于 GAN;2020–2024 年的主流。 |
| MOS | 主观质量 | 人类评分者给出的 1–5 分平均意见得分。 |
| SECS | 声音克隆指标 | 目标与输出说话人嵌入之间的余弦相似度。 |
| F5-TTS | 2024 年开源 SOTA | 流匹配扩散;零样本克隆。 |
| Kokoro | CPU 英语领跑者 | 82M 参数模型,Apache 2.0。 |
延伸阅读
- Shen et al. (2017). Tacotron 2 —— seq2seq 基线。
- Kim, Kong, Son (2021). VITS —— 端到端流模型。
- Chen et al. (2024). F5-TTS —— 当前开源 SOTA。
- Kong, Kim, Bae (2020). HiFi-GAN —— 2026 年仍在使用的声码器。
- Kokoro-82M on HuggingFace —— 2024 年 CPU 友好的英语 TTS。
示意图共 1 张