问题
你拿到一段 10 秒的音频,想知道:它是什么?城市声音(警笛、电钻、狗叫)、语音指令(yes/no/stop)、语言识别(en/es/ar)、说话人情绪(愤怒/中性),还是环境声音(室内/室外、人群嘈杂)。这些都是音频分类,而 2026 年的基线架构已经成熟:log-mel → CNN 或 Transformer → softmax。
核心难点不在网络,而在数据。音频数据集有严酷的类别不平衡、强烈的域偏移(干净 vs 嘈杂)以及标签噪声(谁来决定这是「城市嘈杂」还是「餐厅噪声」?)。问题的 80% 是数据整理、数据增强和评估,而不是把 CNN 换成 Transformer。
概念
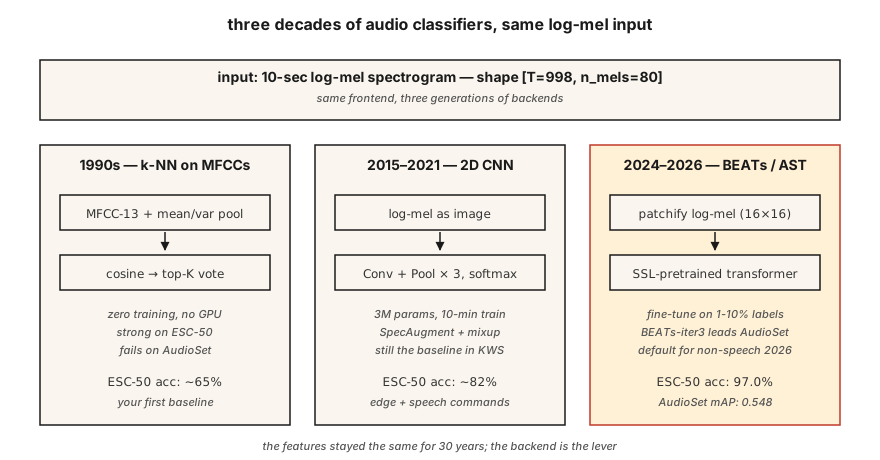
MFCC 上的 k-NN(1990 年代基线)。 把每个音频片段的 MFCC 展平,与带标签的样本库计算余弦相似度,返回 top K 的多数投票。在干净的小数据集(Speech Commands、ESC-50)上出人意料地强。无需 GPU 即可运行。
log-mel 上的 2D CNN(2015–2019)。 把 (T, n_mels) 的 log-mel 当作图像处理。应用 ResNet-18 或 VGG 风格结构。沿时间轴做全局平均池化。在类别上做 softmax。仍是大多数 2026 年 Kaggle 竞赛的基线。
Audio Spectrogram Transformer,AST(2021–2024)。 把 log-mel 切成 patch(例如 16×16),加入位置嵌入,送入 ViT。在 AudioSet 的监督学习上达到 SOTA(mAP 0.485)。
BEATs 与 WavLM-base(2024–2026)。 在数百万小时数据上做自监督预训练。用所需监督数据的 1–10% 在你的任务上微调。2026 年这是非语音音频的默认起点。BEATs-iter3 在 AudioSet 上以 1/4 的计算量比 AST 高出 1–2 mAP。
把 Whisper 编码器用作冻结骨干(2024)。 取 Whisper 的编码器,去掉解码器,接上一个线性分类器。在语言识别和简单事件分类上接近 SOTA,且不需要音频增强。「免费午餐」基线。
类别不平衡才是真正的挑战
ESC-50:50 个类别,每类 40 段——平衡、简单。UrbanSound8K:10 个类别,10:1 不平衡。AudioSet:632 个类别,长尾比例达 100,000:1。有效的技术:
- 训练时做平衡采样(评估时不做)。
- Mixup:线性插值两段音频(及其标签)作为增强。
- SpecAugment:遮住随机的时间与频带。简单而关键。
评估
- 多分类互斥(Speech Commands):top-1 准确率、top-5 准确率。
- 多分类多标签(AudioSet、UrbanSound 风格):平均精度均值(mAP)。
- 严重不平衡:各类别召回率 + macro F1。
2026 年你应该知道的数字:
| 基准 | 基线 | SOTA 2026 | 来源 |
|---|---|---|---|
| ESC-50 | 82%(AST) | 97.0%(BEATs-iter3) | BEATs 论文(2024) |
| AudioSet mAP | 0.485(AST) | 0.548(BEATs-iter3) | HEAR 排行榜 2026 |
| Speech Commands v2 | 98%(CNN) | 99.0%(Audio-MAE) | HEAR v2 结果 |
构建它
第 1 步:提取特征
pythondef featurize_mfcc(signal, sr, n_mfcc=13, n_mels=40, frame_len=400, hop=160):
mag = stft_magnitude(signal, frame_len, hop)
fb = mel_filterbank(n_mels, frame_len, sr)
mels = apply_filterbank(mag, fb)
log = log_transform(mels)
return [dct_ii(frame, n_mfcc) for frame in log]第 2 步:固定长度摘要
pythondef summarize(mfcc_frames):
n = len(mfcc_frames[0])
mean = [sum(f[i] for f in mfcc_frames) / len(mfcc_frames) for i in range(n)]
var = [
sum((f[i] - mean[i]) ** 2 for f in mfcc_frames) / len(mfcc_frames) for i in range(n)
]
return mean + var简单但强大:跨时间的均值 + 方差,为 13 维 MFCC 得到 26 维固定嵌入。运行瞬间完成。直到 2017 年它还在 ESC-50 上击败过 SOTA 神经网络基线。
第 3 步:k-NN
pythondef cosine(a, b):
dot = sum(x * y for x, y in zip(a, b))
na = math.sqrt(sum(x * x for x in a)) or 1e-12
nb = math.sqrt(sum(x * x for x in b)) or 1e-12
return dot / (na * nb)
def knn_classify(q, bank, labels, k=5):
sims = sorted(range(len(bank)), key=lambda i: -cosine(q, bank[i]))[:k]
votes = Counter(labels[i] for i in sims)
return votes.most_common(1)[0][0]第 4 步:升级到 log-mel 上的 CNN
在 PyTorch 中:
pythonimport torch.nn as nn
class AudioCNN(nn.Module):
def __init__(self, n_mels=80, n_classes=50):
super().__init__()
self.body = nn.Sequential(
nn.Conv2d(1, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(),
nn.AdaptiveAvgPool2d(1),
)
self.head = nn.Linear(128, n_classes)
def forward(self, x): # x: (B, 1, T, n_mels)
return self.head(self.body(x).flatten(1))300 万参数。单张 RTX 4090 在 ESC-50 上约 10 分钟训练完成。准确率 80%+。
第 5 步:微调预训练音频 Transformer(以 AST 为例)
pythonfrom transformers import ASTFeatureExtractor, ASTForAudioClassification
ext = ASTFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
model = ASTForAudioClassification.from_pretrained(
"MIT/ast-finetuned-audioset-10-10-0.4593",
num_labels=50,
ignore_mismatched_sizes=True,
)
inputs = ext(audio, sampling_rate=16000, return_tensors="pt")
logits = model(**inputs).logits该示例从 Hub 微调 AST。2026 年的默认选择 BEATs 不在 Hugging Face Hub 上:从 microsoft/unilm 的 BEATs release 下载 checkpoint,用该仓库的 BEATs 与 BEATsConfig 类加载;微调循环保持同样的形式。
使用它
2026 年的技术栈:
| 情形 | 从什么开始 |
|---|---|
| 微型数据集(<1000 段) | MFCC 均值上的 k-NN(你的基线)+ 音频增强 |
| 中型数据集(1K–100K) | 微调 BEATs 或 AST |
| 大型数据集(>100K) | 从零训练,或微调 Whisper 编码器 |
| 实时、边缘 | 40 维 MFCC CNN,量化到 int8(KWS 风格) |
| 多标签(AudioSet) | BEATs-iter3 + BCE 损失 + mixup + SpecAugment |
| 语言识别 | MMS-LID、SpeechBrain VoxLingua107 基线 |
决策规则:从冻结的骨干开始,而不是全新模型。微调一个 BEATs 头,几小时就能拿到 SOTA 的 95%,而不是几周。
交付它
保存为 outputs/skill-classifier-designer.md。为给定的音频分类任务选择架构、增强方式、类别平衡策略与评估指标。
练习
- 简单。 运行
code/main.py。它在一个 4 类合成数据集(不同音高的纯音)上训练 k-NN MFCC 基线。报告混淆矩阵。 - 中等。 把
summarize换成 [mean, var, skew, kurtosis]。在同样的合成数据集上,四阶矩池化能否击败 mean+var? - 困难。 用
torchaudio在 ESC-50 第 1 折上训练一个 2D CNN。报告 5 折交叉验证准确率。加入 SpecAugment(时间掩码 = 20,频率掩码 = 10),报告差值。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| AudioSet | 音频界的 ImageNet | Google 的 200 万段、632 类弱标注 YouTube 数据集。 |
| ESC-50 | 小型分类基准 | 50 个类别 × 40 段环境声音。 |
| AST | Audio Spectrogram Transformer | 在 log-mel patch 上运行的 ViT;2021 年 SOTA。 |
| BEATs | 自监督音频 | 微软模型,截至 2026 年 iter3 在 AudioSet 上领先。 |
| Mixup | 成对增强 | x = λ·x1 + (1-λ)·x2; y = λ·y1 + (1-λ)·y2。 |
| SpecAugment | 基于掩码的增强 | 把频谱图上随机的时间与频带置零。 |
| mAP | 主要多标签指标 | 跨类别与阈值的平均精度均值。 |
延伸阅读
- Gong, Chung, Glass (2021). AST: Audio Spectrogram Transformer —— 2021–2024 年的权威架构。
- Chen et al. (2022, rev. 2024). BEATs: Audio Pre-Training with Acoustic Tokenizers —— 2024 年之后的默认选择。
- Park et al. (2019). SpecAugment —— 占主导的音频增强方法。
- Piczak (2015). ESC-50 dataset —— 至今仍在使用的 50 类基准。
- Gemmeke et al. (2017). AudioSet —— 632 类 YouTube 分类体系;仍是黄金标准。
示意图共 1 张