把第 01-11 课的内容全部缝合起来。构建一个会听、会推理、会回话的语音助手。在 2026 年,这是一个已解决的工程问题,而不是研究问题——但集成细节决定它能否落地。
问题
构建一个端到端助手:
- 采集麦克风输入(16 kHz 单声道)。
- 检测用户语音的起点/终点。
- 流式转写。
- 把转写文本传给可调用工具(定时器、天气、日历)的 LLM。
- 把 LLM 文本流式送入 TTS。
- 向用户播放音频。
- 若用户在回答中途打断则停止。
延迟目标:在笔记本 CPU 上,用户说完话后 800 ms 内输出第一个 TTS 音频字节。质量目标:不漏词,不在静音上产生幻觉字幕,不泄漏声音克隆,不允许提示注入成功。
概念
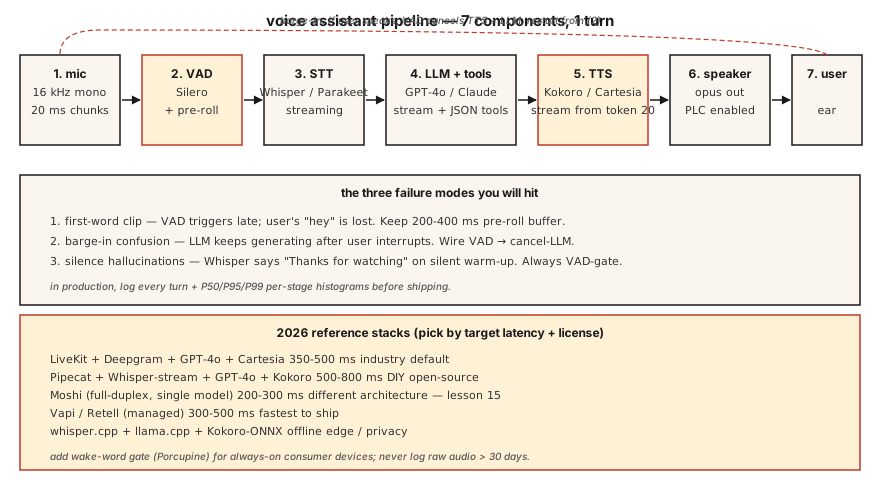
七个组件
- 音频采集。 麦克风 → 16 kHz 单声道 → 20 ms 块。Python 中通常用
sounddevice,生产环境中用原生 AudioUnit/ALSA/WASAPI。 - VAD(第 11 课)。 Silero VAD,阈值 0.5,最短语音 250 ms,静音挂起 500 ms。发出「开始」和「结束」信号。
- 流式 STT(第 4-5 课)。 Whisper-streaming、Parakeet-TDT 或 Deepgram Nova-3(API)。部分 + 最终转写。
- 带 tool calling 的 LLM。 GPT-4o / Claude 3.5 / Gemini 2.5 Flash。工具使用 JSON schema。流式输出 token。
- 流式 TTS(第 7 课)。 Kokoro-82M(最快的开源模型)或 Cartesia Sonic(商业)。在 LLM 输出 20 个 token 后就开始 TTS。
- 播放。 输出到扬声器;低带宽网络用 opus 编码。
- 中断处理器。 如果 TTS 播放期间 VAD 触发,停止播放、取消 LLM、重启 STT。
你会遇到的三种失败模式
- 首个词被截。 VAD 启动晚了一拍,用户的 "hey" 丢了。起始阈值设为 0.3,而不是 0.5。
- 回答中途打断混乱。 用户打断后 LLM 继续生成;助手盖过用户说话。把 VAD → 取消 LLM 接起来。
- 静音幻觉。 Whisper 在静音预热帧上输出 "Thanks for watching"。始终做 VAD 门控。
2026 年生产参考技术栈
| 技术栈 | 延迟 | 许可证 | 备注 |
|---|---|---|---|
| LiveKit + Deepgram + GPT-4o + Cartesia | 350-500 ms | 商业 API | 2026 年行业默认 |
| Pipecat + Whisper-streaming + GPT-4o + Kokoro | 500-800 ms | 大部分开源 | 适合 DIY |
| Moshi(全双工) | 200-300 ms | CC-BY 4.0 | 单模型;架构不同,见第 15 课 |
| Vapi / Retell(托管) | 300-500 ms | 商业 | 上线最快;定制有限 |
| Whisper.cpp + llama.cpp + Kokoro-ONNX | 离线 | 开源 | 隐私 / 边缘 |
构建它
第 1 步:分块麦克风采集(伪代码)
pythonimport sounddevice as sd
def mic_stream(chunk_ms=20, sr=16000):
q = queue.Queue()
def cb(indata, frames, time, status):
q.put(indata.copy().flatten())
with sd.InputStream(channels=1, samplerate=sr, blocksize=int(sr * chunk_ms/1000), callback=cb):
while True:
yield q.get()第 2 步:VAD 门控的轮次采集
pythondef capture_turn(stream, vad, pre_roll_ms=300, silence_ms=500):
buf, pre, triggered = [], collections.deque(maxlen=pre_roll_ms // 20), False
silent = 0
for chunk in stream:
pre.append(chunk)
if vad(chunk):
if not triggered:
buf = list(pre)
triggered = True
buf.append(chunk)
silent = 0
elif triggered:
silent += 20
buf.append(chunk)
if silent >= silence_ms:
return b"".join(buf)第 3 步:流式 STT → LLM → TTS
pythonasync def turn(audio_bytes):
transcript = await stt.transcribe(audio_bytes)
async for token in llm.stream(transcript):
async for audio in tts.stream(token):
await speaker.play(audio)第 4 步:LLM 循环内的 tool calling
pythontools = [
{"name": "get_weather", "parameters": {"location": "string"}},
{"name": "set_timer", "parameters": {"seconds": "int"}},
]
async for chunk in llm.stream(user_text, tools=tools):
if chunk.type == "tool_call":
result = dispatch(chunk.name, chunk.args)
continue_streaming(result)
if chunk.type == "text":
await tts.stream(chunk.text)第 5 步:中断处理
pythontts_task = asyncio.create_task(tts_loop())
while True:
chunk = await mic.get()
if vad(chunk):
tts_task.cancel()
await speaker.stop()
await new_turn()
break使用它
见 code/main.py:一个可运行的模拟,用桩模型把七个组件全部接起来,即使没有硬件也能看到 pipeline 的形状。真实实现中,把桩替换为:
silero-vad(pip install silero-vad)deepgram-sdk或openai-whisperopenai(gpt-4o)或anthropickokoro或cartesiasounddevice用于 I/O
常见陷阱
- 永久记录 PII。 完整轮次音频在大多数司法管辖区都属于 PII。保留 30 天,静态加密。
- 没有 barge-in。 用户会打断。你的助手必须停止说话。
- 阻塞式 TTS。 同步 TTS 会阻塞事件循环。使用异步或独立线程。
- 没有 tool call 错误处理。 工具会失败。LLM 必须拿到错误信息 + 重试一次,然后优雅降级。
- 过度严格的幻觉过滤。 过滤过度,助手就会反复说「我帮不了这个」。过滤不足,它就什么都说。在留出集上校准。
- 没有唤醒词选项。 一直监听是隐私隐患。加入唤醒词门控(Porcupine 或 openWakeWord)。
交付它
保存为 outputs/skill-voice-assistant-architect.md。给定预算 + 规模 + 语言 + 合规约束,产出一份完整的技术栈规格。
练习
- 简单。 运行
code/main.py。它用桩模块端到端模拟一个完整轮次,并打印各阶段延迟。 - 中等。 在预录的
.wav上把 STT 桩替换为真实 Whisper 模型。测量 WER 和端到端延迟。 - 困难。 加入 tool calling:实现
get_weather(任意 API)和set_timer。让 LLM 走工具路由,并验证用户说 "set a 5 minute timer" 时正确的函数被触发,语音回复也确认了这一点。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 轮次(Turn) | 一轮用户 + 助手往返 | 一次 VAD 界定的用户语音 + 一次 LLM-TTS 回应。 |
| Barge-in | 打断 | 助手说话时用户说话;助手停止。 |
| 唤醒词(Wake word) | 「嘿,助手」 | 短关键词检测器;Porcupine、Snowboy、openWakeWord。 |
| 端点检测(End-pointing) | 轮次结束 | VAD + 最小静音判定用户已说完。 |
| Pre-roll | 语音前缓冲 | 在 VAD 触发前保留 200-400 ms 音频,避免截掉第一个词。 |
| Tool call | Function call | LLM 输出 JSON;运行时派发;结果在循环内回灌。 |
延伸阅读
- LiveKit — voice agent quickstart —— 生产级参考。
- Pipecat — voice agent examples —— 适合 DIY 的框架。
- OpenAI Realtime API —— 托管的语音原生路径。
- Kyutai Moshi —— 全双工参考(第 15 课)。
- Porcupine wake-word —— 唤醒词门控。
- Anthropic — tool use guide —— LLM function calling。
示意图共 1 张