问题
2026 年,一段 5 秒的音频就足以用消费级 GPU 制作任何人的高质量声音克隆。ElevenLabs、F5-TTS、OpenVoice v2、VoiceBox 都提供零样本或少样本克隆。这项技术是福音(无障碍 TTS、配音、辅助发声),也是武器(诈骗电话、政治深度伪造、IP 盗用)。
两个密切相关的任务:
- 声音克隆(TTS 一侧): 文本 + 5 秒参考声音 → 用该声音输出的音频。
- 声音转换(语音一侧): 源音频(A 说 X)+ B 的参考声音 → B 说 X 的音频。
两者都把波形分解为(内容、说话人、韵律),再把一个来源的内容与另一个来源的说话人重新组合。
2026 年你必须遵守的关键约束:在欧盟(AI 法案,2026 年 8 月生效)和加州(AB 2905,2025 年生效),水印与同意门禁是法律要求。你的 pipeline 必须嵌入不可听的水印,并拒绝未经同意的克隆。
概念
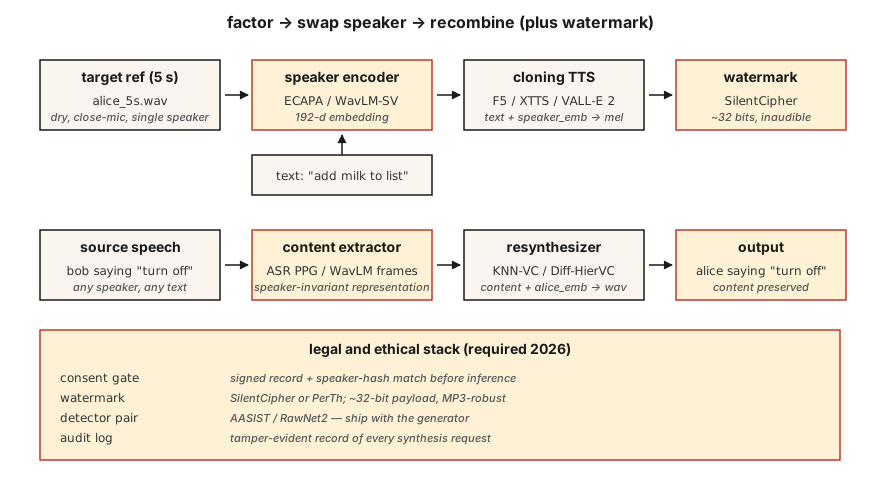
零样本克隆。 把一段 5 秒音频交给在数千名说话人上训练过的模型。说话人编码器把音频映射为说话人嵌入;TTS 解码器以该嵌入和文本为条件。
采用者:F5-TTS(2024)、YourTTS(2022)、XTTS v2(2024)、OpenVoice v2(2024)。
少样本微调。 录制目标声音 5-30 分钟。对基础模型做一小时的 LoRA 微调。质量从「还行」跃升到「无法分辨」。Coqui 和 ElevenLabs 都支持这种模式;社区把它用在 F5-TTS 上。
声音转换(VC)。 有两大类:
- 识别-合成。 运行类 ASR 模型提取内容表示(例如软音素后验,PPG),再用目标说话人嵌入重新合成。对语言和口音鲁棒。KNN-VC(2023)、Diff-HierVC(2023)采用此法。
- 解耦。 训练一个自编码器,在瓶颈处的潜空间中分离内容、说话人和韵律。推理时替换说话人嵌入。质量较低但更快。AutoVC(2019)、VITS-VC 变体采用此法。
基于神经编解码器的克隆(2024+)。 VALL-E、VALL-E 2、NaturalSpeech 3、VoiceBox——把音频视为来自 SoundStream / EnCodec 的离散 token,在编解码器 token 上训练大型自回归或流匹配模型。在短提示上质量可与 ElevenLabs 媲美。
伦理部分是主体,不是附加项
水印。 PerTh(Perth)和 SilentCipher(2024)把约 16-32 位的 ID 不可感知地嵌入音频。能经受重编码、流式传输和常见编辑。已有可用的开源生产实现。
同意门禁。 每个克隆输出都必须附带可验证的同意记录。「我,Rohit,于 2026-04-22 授权此声音用于 X 用途。」存入防篡改日志。
检测。 AASIST、RawNet2 和 Wav2Vec2-AASIST 可作为检测器使用。ASVspoof 2025 挑战赛公布,最先进的检测器针对 ElevenLabs、VALL-E 2 和 Bark 输出的 EER 为 0.8–2.3%。
数据(2026 年)
| 模型 | 零样本? | SECS(目标相似度) | WER(可懂度) | 参数 |
|---|---|---|---|---|
| F5-TTS | 是 | 0.72 | 2.1% | 335M |
| XTTS v2 | 是 | 0.65 | 3.5% | 470M |
| OpenVoice v2 | 是 | 0.70 | 2.8% | 220M |
| VALL-E 2 | 是 | 0.77 | 2.4% | 370M |
| VoiceBox | 是 | 0.78 | 2.1% | 330M |
对大多数听众而言,SECS > 0.70 通常就与目标声音无法区分。
构建它
第 1 步:用识别-合成做分解(main.py 中仅有代码的演示)
pythondef clone_pipeline(ref_audio, text, target_embedder, tts_model):
speaker_emb = target_embedder.encode(ref_audio)
mel = tts_model(text, speaker=speaker_emb)
return vocoder(mel)概念上简单;实现的重头在 tts_model 和说话人编码器里。
第 2 步:用 F5-TTS 做零样本克隆
pythonfrom f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
ref_file="rohit_5s.wav",
ref_text="The quick brown fox jumps over the lazy dog.",
gen_text="Please add milk and bread to my list.",
)参考转写必须与音频完全一致;不匹配会破坏对齐。
第 3 步:用 KNN-VC 做声音转换
pythonimport torch
from knnvc import KNNVC # 2023 model, https://github.com/bshall/knn-vc
vc = KNNVC.load("wavlm-base-plus")
out_wav = vc.convert(source="my_voice.wav", target_pool=["alice_1.wav", "alice_2.wav"])KNN-VC 运行 WavLM,为源音频和目标音频池提取逐帧嵌入,然后把每个源帧替换为池中最近的邻居。非参数化,只需一分钟目标语音即可工作。
第 4 步:嵌入水印
pythonfrom silentcipher import SilentCipher
sc = SilentCipher(model="2024-06-01")
payload = b"consent_id:abc123;ts:1745353200"
watermarked = sc.embed(wav, sr=24000, message=payload)
detected = sc.detect(watermarked, sr=24000) # returns payload bytes约 32 位载荷,在 MP3 重编码和轻度噪声后仍可检测。
第 5 步:同意门禁
pythondef cloned_inference(text, ref_audio, consent_record):
assert verify_signature(consent_record), "Signed consent required"
assert consent_record["speaker_id"] == hash_speaker(ref_audio)
wav = tts.infer(ref_file=ref_audio, gen_text=text)
wav = watermark(wav, payload=consent_record["id"])
return wav使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| 5 秒零样本克隆,开源 | F5-TTS 或 OpenVoice v2 |
| 商业生产克隆 | ElevenLabs Instant Voice Clone v2.5 |
| 声音转换(改写) | KNN-VC 或 Diff-HierVC |
| 多说话人微调 | StyleTTS 2 + 说话人适配器 |
| 跨语言克隆 | XTTS v2 或 VALL-E X |
| 深度伪造检测 | Wav2Vec2-AASIST |
常见陷阱
- 参考转写不对齐。 F5-TTS 之类的模型要求参考文本与参考音频完全一致,包括标点。
- 混响参考。 回声会毁掉克隆。要在安静环境中近距离拾音。
- 情绪不匹配。 用「愉快」的参考训练,会把一切都克隆得很愉快。参考情绪要匹配目标用途。
- 语言泄漏。 克隆英语说话人后让模型说法语,往往还是会带口音;应使用跨语言模型(XTTS、VALL-E X)。
- 没有水印。 从 2026 年 8 月起在欧盟法律上不可发布。
交付它
保存为 outputs/skill-voice-cloner.md。设计一条包含同意门禁 + 水印 + 质量目标的克隆或转换 pipeline。
练习
- 简单。 运行
code/main.py。通过计算两个「说话人」在替换前后的余弦相似度,演示说话人嵌入替换。 - 中等。 用 OpenVoice v2 克隆自己的声音。测量参考与克隆之间的 SECS。用 Whisper 测量 CER。
- 困难。 对 20 个克隆应用 SilentCipher 水印,经 128 kbps MP3 编码+解码,再检测载荷。报告比特准确率。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 零样本克隆(Zero-shot clone) | 5 秒就够了 | 预训练模型 + 说话人嵌入;无需训练。 |
| PPG | 音素后验图 | 逐帧 ASR 后验,用作语言无关的内容表示。 |
| KNN-VC | 最近邻转换 | 用目标池中最近的帧替换每个源帧。 |
| 神经编解码器 TTS | VALL-E 风格 | 在 EnCodec/SoundStream token 上的 AR 模型。 |
| 水印(Watermark) | 不可听的签名 | 嵌入音频的比特,可经受重编码。 |
| SECS | 克隆保真度 | 目标与克隆说话人嵌入之间的余弦。 |
| AASIST | 深度伪造检测器 | 反欺骗模型;检测合成语音。 |
延伸阅读
- Chen et al. (2024). F5-TTS —— 开源 SOTA 零样本克隆。
- Baevski et al. / Microsoft (2023). VALL-E 和 VALL-E 2 (2024) —— 神经编解码器 TTS。
- Qian et al. (2019). AutoVC —— 基于解耦的声音转换。
- Baas, Waubert de Puiseau, Kamper (2023). KNN-VC —— 基于检索的 VC。
- SilentCipher (2024) — Audio Watermarking —— 可用于生产的 32 位音频水印。
- ASVspoof 2025 results —— 检测器与合成器的军备竞赛,2026 年更新。
示意图共 1 张