问题
语言模型处理的是离散 token。音频是连续的。如果你想为语音或音乐构建 LLM 风格的模型——MusicGen、Moshi、Sesame CSM、VibeVoice、Orpheus——你首先需要一个神经音频编解码器(neural audio codec):一个把音频离散化成小词表 token 的学习型编码器,以及一个与之匹配、能重建波形的解码器。
已经出现了两个家族:
- 重建优先的编解码器——EnCodec、DAC。优化感知音频质量。token 是「声学」的——它们捕获一切,包括说话人身份、音色、背景噪声。
- 语义优先的编解码器——Mimi(Kyutai)、SpeechTokenizer。强制第一个码本编码语言/音素内容(通常通过从 WavLM 蒸馏)。后续码本是声学细节。
2024-2026 年的洞见是:纯重建编解码器在你尝试从文本生成时会得到模糊的语音。 在编解码器 token 上训练的 LLM 不得不在同一个码本里同时学习语言结构和声学结构,这无法扩展。把二者分开——语义码本 0、声学码本 1-N——正是 Moshi 和 Sesame CSM 能工作的原因。
概念
核心技巧:残差向量量化(RVQ)
现代音频编解码器都使用 RVQ,而不是一个巨大的码本(那需要数百万个码才能达到好的质量):一串小码本的级联。第一个码本量化编码器输出;第二个量化残差;依此类推。每个码本有 1024 个码。8 个码本 = 有效词表 1024^8 = 10^{24}。
推理时,解码器把每帧所有选中的码相加来重建。
2026 年重要的四个编解码器
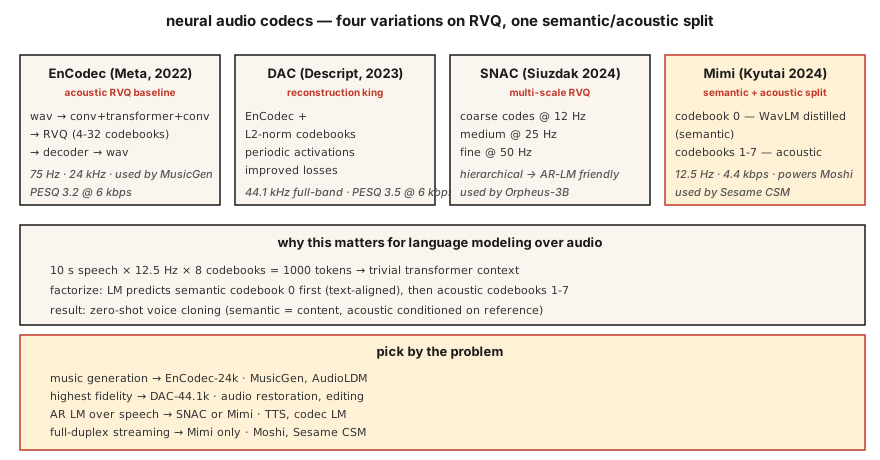
EnCodec(Meta,2022)。 基线。波形上的编码器-解码器,RVQ 瓶颈。24 kHz,最多 32 个码本,默认 4 码本 @ 1.5 kbps。使用 1D conv + transformer + 1D conv 架构。被 MusicGen 使用。
DAC(Descript,2023)。 RVQ 配 L2 归一化码本、周期激活函数、改进的损失。在所有开源编解码器中重建保真度最高——12 码本时有时与原始语音无法区分。44.1 kHz 全频带。
SNAC(Hubert Siuzdak,2024)。 多尺度 RVQ——粗码本比细码本以更低的帧率运行。有效地分层建模音频:约 12 Hz 的粗「草图」加上 50 Hz 的细节。被 Orpheus-3B 使用,因为这种分层结构很好地映射到基于 LM 的生成。
Mimi(Kyutai,2024)。 2026 年的游戏规则改变者。12.5 Hz 帧率(极低),8 码本 @ 4.4 kbps。码本 0 从 WavLM 蒸馏——训练来预测 WavLM 的语音内容特征。码本 1-7 是声学残差。这一拆分支撑了 Moshi(第 15 课)和 Sesame CSM。
帧率对语言建模很重要
帧率越低 = 序列越短 = LM 越快。
| 编解码器 | 帧率 | 1 s = N 帧 | 适合 |
|---|---|---|---|
| EnCodec-24k | 75 Hz | 75 | 音乐、通用音频 |
| DAC-44.1k | 86 Hz | 86 | 高保真音乐 |
| SNAC-24k(粗) | ~12 Hz | 12 | AR-LM 高效 |
| Mimi | 12.5 Hz | 12.5 | 流式语音 |
在 12.5 Hz 下,一段 10 秒的话语只有 125 个编解码器帧——Transformer 可以轻松预测它们。
语义 token 与声学 token
frame_t → [semantic_token_t, acoustic_token_0_t, acoustic_token_1_t, ..., acoustic_token_6_t]- 语义 token(Mimi 中的码本 0)。 编码说了什么——音素、词、内容。通过辅助预测损失从 WavLM 蒸馏。
- 声学 token(码本 1-7)。 编码音色、说话人身份、韵律、背景噪声、细节。
AR LM 先预测语义 token(以文本为条件),再预测声学 token(以语义 + 说话人参考为条件)。这种因式分解正是现代 TTS 能零样本克隆声音的原因:语义模型处理内容,声学模型处理音色。
2026 年的重建质量(每秒比特数,比特率越低越好)
| 编解码器 | 比特率 | PESQ | ViSQOL |
|---|---|---|---|
| Opus-20kbps | 20 kbps | 4.0 | 4.3 |
| EnCodec-6kbps | 6 kbps | 3.2 | 3.8 |
| DAC-6kbps | 6 kbps | 3.5 | 4.0 |
| SNAC-3kbps | 3 kbps | 3.3 | 3.8 |
| Mimi-4.4kbps | 4.4 kbps | 3.1 | 3.7 |
像 Opus 这样的传统编解码器在每比特的感知质量上仍然胜出。神经编解码器赢在离散 token(Opus 不产生这些)和生成模型质量(LM 能用这些 token 做什么)上。
构建它
第 1 步:用 EnCodec 编码
pythonfrom encodec import EncodecModel
import torch
model = EncodecModel.encodec_model_24khz()
model.set_target_bandwidth(6.0) # kbps
wav = torch.randn(1, 1, 24000)
with torch.no_grad():
encoded = model.encode(wav)
codes, scale = encoded[0]
# codes: (1, n_codebooks, n_frames), dtype=int646 kbps 时 n_codebooks=8。每个码是 0-1023(10 比特)。
第 2 步:解码并测量重建
pythonwith torch.no_grad():
wav_recon = model.decode([(codes, scale)])
from torchaudio.functional import compute_deltas
import torch.nn.functional as F
mse = F.mse_loss(wav_recon[:, :, :wav.shape[-1]], wav).item()第 3 步:语义-声学拆分(Mimi 风格)
pythonfrom moshi.models import loaders
mimi = loaders.get_mimi()
with torch.no_grad():
codes = mimi.encode(wav) # shape (1, 8, frames@12.5Hz)
semantic = codes[:, 0]
acoustic = codes[:, 1:]语义码本 0 与 WavLM 对齐。你可以训练一个文本到语义的 Transformer——词表比直接到音频小得多。然后一个单独的声学到波形解码器以说话人参考为条件。
第 4 步:为什么基于编解码器 token 的 AR LM 有效
对于 Mimi 的 12.5 Hz × 8 码本下 10 秒的语音片段:
1000 个 token 对 Transformer 来说是一个很普通的上下文。一个 2.56 亿参数的 Transformer 可以在现代 GPU 上几毫秒内生成 10 秒语音。
使用它
把问题映射到编解码器:
| 任务 | 编解码器 |
|---|---|
| 通用音乐生成 | EnCodec-24k |
| 最高保真重建 | DAC-44.1k |
| 基于语音的 AR LM(TTS) | SNAC 或 Mimi |
| 流式全双工语音 | Mimi(12.5 Hz) |
| 带文本的音效库 | EnCodec + T5 条件 |
| 细粒度音频编辑 | DAC + 修补(inpainting) |
经验法则:如果你在构建生成模型,从 Mimi 或 SNAC 开始。如果你在构建压缩管线,用 Opus。
陷阱
- 码本太多。 增加码本会线性提高保真度,但也会线性增加 LM 序列长度。停在 8-12 个。
- 帧率不匹配。 在 12.5 Hz 的 Mimi 上训练 LM,再在 50 Hz 的 EnCodec 上微调,会静默失败。
- 假设所有码本等价。 在 Mimi 中,码本 0 承载内容;丢失它会摧毁可懂度。丢失码本 7 几乎察觉不到。
- 把重建质量当作唯一指标。 一个编解码器可以有很好的重建,但如果语义结构很差,对基于 LM 的生成就毫无用处。
交付它
保存为 outputs/skill-codec-picker.md。为给定的生成或压缩任务挑选一个编解码器。
练习
- 简单。 运行
code/main.py。它实现一个玩具标量 + 残差量化器,并测量增加码本时的重建误差。 - 中等。 安装
encodec,在一个留出的语音片段上比较 1、4、8、32 个码本。绘制 PESQ 或 MSE 与比特率的关系。 - 困难。 加载 Mimi。编码一个片段。把码本 0 替换为随机整数;解码。然后同样替换码本 7。比较两种损坏——码本 0 损坏应该摧毁可懂度;码本 7 损坏应该几乎不改变任何东西。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| RVQ | 残差量化 | 一串小码本的级联;每个量化前一步的残差。 |
| Frame rate | 编解码器速度 | 每秒多少 token 帧。越低 = LM 越快。 |
| Semantic codebook | 码本 0(Mimi) | 从 SSL 特征蒸馏的码本;编码内容。 |
| Acoustic codebooks | 其余所有 | 音色、韵律、噪声、细节。 |
| PESQ / ViSQOL | 感知质量 | 与 MOS 相关的客观指标。 |
| EnCodec | Meta 编解码器 | RVQ 基线;被 MusicGen 使用。 |
| Mimi | Kyutai 编解码器 | 12.5 Hz 帧率;语义-声学拆分;支撑 Moshi。 |
进一步阅读
- Défossez et al. (2023). EnCodec —— RVQ 基线。
- Kumar et al. (2023). Descript Audio Codec (DAC) —— 保真度最高的开源编解码器。
- Siuzdak (2024). SNAC —— 多尺度 RVQ。
- Kyutai (2024). Mimi codec —— 语义-声学拆分、WavLM 蒸馏。
- Borsos et al. (2023). AudioLM —— 两阶段语义/声学范式。
- Zeghidour et al. (2021). SoundStream —— 最初的可流式 RVQ 编解码器。
示意图共 1 张