问题
文本 → 一段 30 秒到 4 分钟的音乐,带歌词、人声和结构。三个子问题:
- 纯器乐生成。 文本如 "lo-fi hip-hop drums with warm keys" → 音频。MusicGen、Stable Audio、AudioLDM。
- 歌曲生成(带人声 + 歌词)。 "Country song about rainy Texas nights" → 完整歌曲。Suno、Udio、YuE、ACE-Step。
- 条件化 / 可控生成。 延长现有片段、重新生成桥段、切换流派、分离音轨(stem),或局部重绘(inpainting)。Udio 的局部重绘 + 音轨分离是 2026 年要跟进的功能。
概念
基于神经编解码器 token 的 token LM
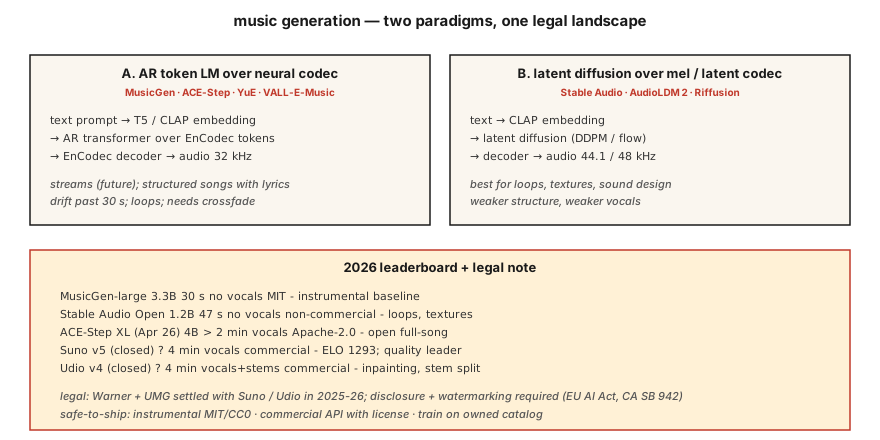
Meta 的 MusicGen(2023,MIT)及许多衍生模型:以文本/旋律嵌入为条件,自回归预测 EnCodec token(32 kHz,4 个码本),再用 EnCodec 解码。300M - 3.3B 参数。强基线;超过 30 秒就吃力。
ACE-Step(开源,4B XL 于 2026 年 4 月发布)将其扩展为歌词条件化的整曲生成。开源社区最接近 Suno 的东西。
在 mel 或潜空间上做扩散
Stable Audio(2023) 和 Stable Audio Open(2024):在压缩音频上做潜扩散。擅长循环、声音设计和环境纹理。不擅长有结构的完整歌曲。
AudioLDM / AudioLDM2:通过 T2I 风格的潜扩散实现文本到音频,可泛化到音乐、音效、语音。
混合式(生产)——Suno、Udio、Lyria
闭源权重。很可能是 AR 编解码器 LM + 基于扩散的声码器,配有专门的人声 / 鼓 / 旋律头。Suno v5(2026)以 ELO 1293 位居质量榜首。Udio v4 增加了局部重绘 + 音轨分离(bass、drums、vocals 可分别下载)。
评估
- FAD(Fréchet 音频距离)。 使用 VGGish 或 PANNs 特征,计算生成音频与真实音频分布之间的嵌入级距离。越低越好。MusicGen small:MusicCaps 上 FAD 4.5;SOTA 约 3.0。
- 音乐性(主观)。 人类偏好。Suno v5 以 ELO 1293 领先。
- 文本-音频对齐。 提示与输出之间的 CLAP 分数。
- 音乐性瑕疵。 抢拍转换、人声乐句漂移、超过 30 秒后结构丢失。
2026 年模型地图
| 模型 | 参数 | 时长 | 人声 | 许可证 |
|---|---|---|---|---|
| MusicGen-large | 3.3B | 30 s | 否 | MIT |
| Stable Audio Open | 1.2B | 47 s | 否 | Stability 非商业 |
| ACE-Step XL(2026 年 4 月) | 4B | > 2 min | 是 | Apache-2.0 |
| YuE | 7B | > 2 min | 是,多语言 | Apache-2.0 |
| Suno v5(闭源) | ? | 4 min | 是,ELO 1293 | 商业 |
| Udio v4(闭源) | ? | 4 min | 是 + 音轨 | 商业 |
| Google Lyria 3(闭源) | ? | 实时 | 是 | 商业 |
| MiniMax Music 2.5 | ? | 4 min | 是 | 商业 API |
法律格局(2025-2026)
- Warner Music 诉 Suno 和解。 5 亿美元。WMG 现在对 Suno 上的 AI 相似度、音乐版权和用户生成音轨拥有监督权。UMG 与 Udio 也有类似和解。
- 欧盟 AI 法案 + 加州 SB 942:AI 生成的音乐必须披露。
- Riffusion / MusicGen 以 MIT 许可发布,没有合规包袱,但也没有商业化人声。
可安全发布的做法:
- 只生成器乐(MusicGen、Stable Audio Open,MIT/CC0 输出)。
- 使用商业 API(Suno、Udio、ElevenLabs Music),按次生成授权。
- 在自有或已获授权的曲库上训练(大多数企业最终走到这一步)。
- 为生成结果打上水印 + 元数据。
构建它
第 1 步:用 MusicGen 生成
pythonfrom audiocraft.models import MusicGen
import torchaudio
model = MusicGen.get_pretrained("facebook/musicgen-small")
model.set_generation_params(duration=10)
wav = model.generate(["upbeat synthwave with driving drums, 128 BPM"])
torchaudio.save("out.wav", wav[0].cpu(), 32000)三种规模:small(300M,快)、medium(1.5B)、large(3.3B)。验证「这个想法是否成立」用 small 就够了。
第 2 步:旋律条件化
pythonmelody, sr = torchaudio.load("humming.wav")
wav = model.generate_with_chroma(
["jazz piano cover"],
melody.squeeze(),
sr,
)MusicGen-melody 接收色谱图(chromagram),在替换音色的同时保留旋律。适用于「把这段旋律改成弦乐四重奏」。
第 3 步:FAD 评估
pythonfrom frechet_audio_distance import FrechetAudioDistance
fad = FrechetAudioDistance()
fad.get_fad_score("generated_folder/", "reference_folder/")计算 VGGish 嵌入距离。适用于流派级别的回归测试;不能替代人类听众。
第 4 步:接入 LLM-音乐工作流
结合第 7-8 课的思路:
pythonprompt = "Write a 30-second jazz loop. Describe the drums, bass, and piano voicing."
description = llm.complete(prompt)
music = musicgen.generate([description], duration=30)使用它
| 目标 | 技术栈 |
|---|---|
| 纯器乐声音设计 | Stable Audio Open |
| 游戏 / 自适应音乐 | Google Lyria RealTime(闭源) |
| 带人声的完整歌曲(商业) | Suno v5 或 Udio v4,需明确授权 |
| 带人声的完整歌曲(开源) | ACE-Step XL 或 YuE |
| 短广告配乐 | 以哼唱参考做旋律条件化的 MusicGen |
| 音乐视频背景 | MusicGen + Stable Video Diffusion |
2026 年仍在踩的坑
- 版权洗白式提示。 "Song in the style of Taylor Swift"——商业 Suno/Udio 现在会过滤这类提示,开源模型不会。自己加一份过滤列表。
- 重复 / 超过 30 秒的漂移。 AR 模型会循环。对多次生成做交叉淡化,或用 ACE-Step 获得结构连贯性。
- 速度漂移。 模型会偏离 BPM。在提示里写 BPM 标签,并用 librosa 的
beat_track做后置过滤。 - 人声可懂度。 Suno 很出色;开源模型在咬字上往往含糊。如果歌词重要,用商业 API 或微调。
- 单声道输出。 开源模型生成单声道或假立体声。用合适的立体声重建(ezst、Cartesia 的立体声扩散)来升级。
交付它
保存为 outputs/skill-music-designer.md。为一次音乐生成部署选定模型、许可证策略、时长 / 结构规划以及披露元数据。
练习
- 简单。 运行
code/main.py。它用 ASCII 符号生成一段「生成式」和弦进行 + 鼓点——一个音乐生成的漫画版。想听的话可以用任意 MIDI 渲染器回放。 - 中等。 安装
audiocraft,用 MusicGen-small 针对 4 个流派提示各生成 10 秒片段,对参考流派集合测量 FAD。 - 困难。 用 ACE-Step(或 MusicGen-melody)为同一段旋律生成三个变体,使用不同的音色提示。计算与提示的 CLAP 相似度以验证对齐。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| FAD | 音频版 FID | 真实与生成音频嵌入分布之间的 Fréchet 距离。 |
| 色谱图(Chromagram) | 用音高表示旋律 | 逐帧 12 维向量;旋律条件化的输入。 |
| 音轨(Stems) | 乐器轨 | 分离出的 bass / drums / vocals / melody WAV。 |
| 局部重绘(Inpainting) | 重新生成某一段 | 遮住一个时间窗口;模型只重生成那一段。 |
| CLAP | 文本-音频版 CLIP | 对比式音频-文本嵌入;评估文本-音频对齐。 |
| EnCodec | 音乐编解码器 | Meta 的神经编解码器,MusicGen 使用;32 kHz,4 个码本。 |
延伸阅读
- Copet et al. (2023). MusicGen —— 开源自回归基准。
- Evans et al. (2024). Stable Audio Open —— 声音设计的默认选择。
- ACE-Step —— 开源 4B 整曲生成器,2026 年 4 月。
- Suno v5 platform docs —— 商业质量领跑者。
- AudioLDM2 —— 面向音乐 + 音效的潜扩散。
- WMG-Suno settlement coverage —— 2025 年 11 月的先例。
示意图共 1 张