问题
语音 Agent 每处理一个 20 ms 块都要做三个不同的判断:
- 这一帧是语音吗? —— VAD。逐帧的二分类。
- 用户是否开始了一段新话语? —— 起始点检测。
- 用户说完了吗? —— 端点判定(轮次结束)。
朴素的答案(能量阈值)在任何噪声下都会失败——车流、键盘、人群嘈杂。2026 年的答案:Silero VAD(开源、深度学习)+ 轮次检测模型(语义端点判定)+ 经 VAD 校准的静音拖尾。
概念
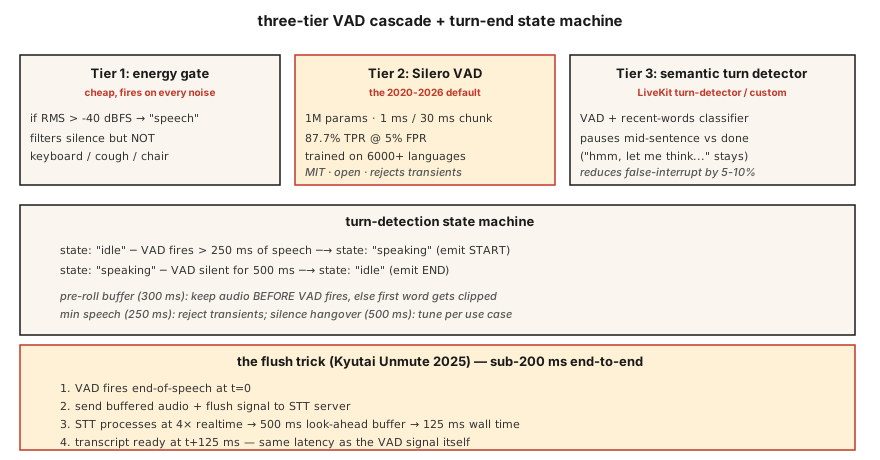
三级 VAD 级联
第 1 级:能量门。 最便宜。在 -40 dBFS 处对 RMS 设阈值。过滤明显的静音,但任何高于阈值的噪声都会触发。
第 2 级:Silero VAD(2020-2026,MIT)。100 万参数。在 6000 多种语言上训练。在单个 CPU 线程上处理 30 ms 块约需 1 ms。5% FPR 下 87.7% TPR。开源领域的默认选择。
第 3 级:语义轮次检测器。 LiveKit 的轮次检测模型(2024-2026)或你自己的小型分类器。区分「句中停顿」和「说完了」。使用语言上下文(语调 + 最近的词),而不仅仅是静音。
关键参数及其默认值
- 阈值。 Silero 输出概率;在 > 0.5(默认)或 > 0.3(敏感)处分类为语音。阈值越低 = 首词被截断更少,误报更多。
- 最短语音时长。 拒绝短于 250 ms 的语音——通常是咳嗽或椅子噪声。
- 静音拖尾(端点判定)。 VAD 回到 0 后,等待 500-800 ms 再宣布轮次结束。太短 → 打断用户。太长 → 感觉迟钝。
- 预卷缓冲区。 VAD 触发前保留 300-500 ms 音频。防止「嘿」被截断。
flush 技巧(Kyutai 2025)
流式 STT 模型有前瞻延迟(Kyutai STT-1B 为 500 ms,STT-2.6B 为 2.5 s)。通常情况下,你需要在语音结束后等那么久才能拿到转写。flush 技巧:当 VAD 触发语音结束时,向 STT 发送 flush 信号,强制立即输出。STT 以约 4 倍实时速度处理,所以 500 ms 的缓冲约 125 ms 就能完成。
端到端:125 ms VAD + flush STT = 对话级延迟。
2026 年 VAD 对比
| VAD | TPR @ 5% FPR | 延迟 | 许可证 |
|---|---|---|---|
| WebRTC VAD(Google,2013) | 50.0% | 30 ms | BSD |
| Silero VAD(2020-2026) | 87.7% | ~1 ms | MIT |
| Cobra VAD(Picovoice) | 98.9% | ~1 ms | 商业 |
| pyannote segmentation | 95% | ~10 ms | 类 MIT |
Silero 是正确的默认选择。Cobra 是合规/精度升级。纯能量 VAD 在 2026 年的生产环境里没有位置。
构建它
第 1 步:能量门
pythondef energy_vad(chunk, threshold_dbfs=-40.0):
rms = (sum(x * x for x in chunk) / len(chunk)) ** 0.5
dbfs = 20.0 * math.log10(max(rms, 1e-10))
return dbfs > threshold_dbfs第 2 步:Python 中的 Silero VAD
pythonfrom silero_vad import load_silero_vad, get_speech_timestamps
vad = load_silero_vad()
audio = torch.tensor(waveform_16k, dtype=torch.float32)
segments = get_speech_timestamps(
audio, vad, sampling_rate=16000,
threshold=0.5,
min_speech_duration_ms=250,
min_silence_duration_ms=500,
speech_pad_ms=300,
)
for s in segments:
print(f"{s['start']/16000:.2f}s - {s['end']/16000:.2f}s")第 3 步:轮次结束状态机
pythonclass TurnDetector:
def __init__(self, silence_hangover_ms=500, min_speech_ms=250):
self.state = "idle"
self.speech_ms = 0
self.silence_ms = 0
self.silence_hangover_ms = silence_hangover_ms
self.min_speech_ms = min_speech_ms
def update(self, is_speech, chunk_ms=20):
if is_speech:
self.speech_ms += chunk_ms
self.silence_ms = 0
if self.state == "idle" and self.speech_ms >= self.min_speech_ms:
self.state = "speaking"
return "START"
else:
self.silence_ms += chunk_ms
if self.state == "speaking" and self.silence_ms >= self.silence_hangover_ms:
self.state = "idle"
self.speech_ms = 0
return "END"
return None第 4 步:flush 技巧骨架
pythondef flush_on_end(stt_client, audio_buffer):
stt_client.send_audio(audio_buffer)
stt_client.send_flush()
return stt_client.recv_transcript(timeout_ms=150)STT(Kyutai、Deepgram、AssemblyAI)必须支持 flush 才能生效。Whisper 流式不支持——它基于块,总是等待块齐。
使用它
| 场景 | VAD 选择 |
|---|---|
| 开源、快速、通用 | Silero VAD |
| 商业呼叫中心 | Cobra VAD |
| 设备端(手机) | Silero VAD ONNX |
| 研究/说话人分离 | pyannote segmentation |
| 零依赖回退 | WebRTC VAD(遗留) |
| 需要轮次结束质量 | Silero + LiveKit turn-detector 分层 |
经验法则:除非真的别无选择,永远不要上线纯能量 VAD。
陷阱
- 固定阈值。 安静时有效,嘈杂时失败。要么在设备上校准,要么改用 Silero。
- 静音拖尾太短。 助手在句中打断。500-800 ms 是对话语音的最佳区间。
- 拖尾太长。 感觉迟钝。与目标用户做 A/B 测试。
- 没有预卷缓冲。 用户音频的前 200-300 ms 丢失。始终保留一个滚动预卷。
- 忽略语义端点判定。 「嗯,让我想想……」包含长停顿。用户讨厌在思考中途被打断。使用 LiveKit 的 turn-detector 或类似方案。
交付它
保存为 outputs/skill-vad-tuner.md。为某个工作负载选择 VAD 模型、阈值、拖尾、预卷和轮次检测策略。
练习
- 简单。 运行
code/main.py。它模拟语音 + 静音 + 语音 + 咳嗽的序列,并测试三个 VAD 层级。 - 中等。 安装
silero-vad,处理一段 5 分钟的录音,调整阈值以同时最小化首词截断和误触发。报告精确率/召回率。 - 困难。 构建一个迷你轮次检测器:Silero VAD + 一个作用于最近 10 个词 embedding 的 3 层 MLP(使用 sentence-transformers)。在手工标注的轮次结束数据集上训练。F1 比纯 Silero 高 10%。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| VAD | 语音检测器 | 逐帧二分类:这是语音吗? |
| Turn detection | 端点判定 | VAD + 静音拖尾 + 语义端点。 |
| Silence hangover | 语音后等待 | 宣布轮次结束前等待的时间;500-800 ms。 |
| Pre-roll | 语音前缓冲 | VAD 触发前保留 300-500 ms 音频。 |
| Flush trick | Kyutai 技巧 | VAD → flush-STT → 125 ms 而非 500 ms 延迟。 |
| Semantic endpoint | 「他们是想停吗?」 | 看词而不只是静音的 ML 分类器。 |
| TPR @ FPR 5% | ROC 点 | 标准 VAD 基准;Silero 87.7%,WebRTC 50%。 |
进一步阅读
- Silero VAD —— 参考开源 VAD。
- Picovoice Cobra VAD —— 商业精度领先者。
- Kyutai — Unmute + flush trick —— 亚 200 ms 的工程技巧。
- LiveKit — turn detection —— 生产中的语义端点判定。
- WebRTC VAD —— 遗留基线。
- pyannote segmentation —— 说话人分离级分割。
示意图共 1 张