问题
取一段 10 秒、16 kHz 的音频。那是 160,000 个浮点数,都在 [-1, 1] 内,与「狗叫」或「cat 这个词」这样的标签几乎完全不相关。原始波形包含信息,但以一种模型难以提取的形式组织。相隔 100 ms 说出的两个相同音素,原始采样点完全不同。
频谱图解决了这个问题。它压缩了人类感知本就忽略的时间细节(微秒级抖动),同时保留了感知所关注的结构(在约 10–25 ms 的时间窗内,哪些频率能量强)。
梅尔频谱图更进一步。人类以对数方式感知音高:100 Hz 与 200 Hz 之间的「距离感」,和 1000 Hz 与 2000 Hz 之间相同。梅尔尺度扭曲频率轴以匹配这种感知。从 2010 年到 2026 年,梅尔尺度频谱图一直是语音机器学习中最重要的单一特征。
概念
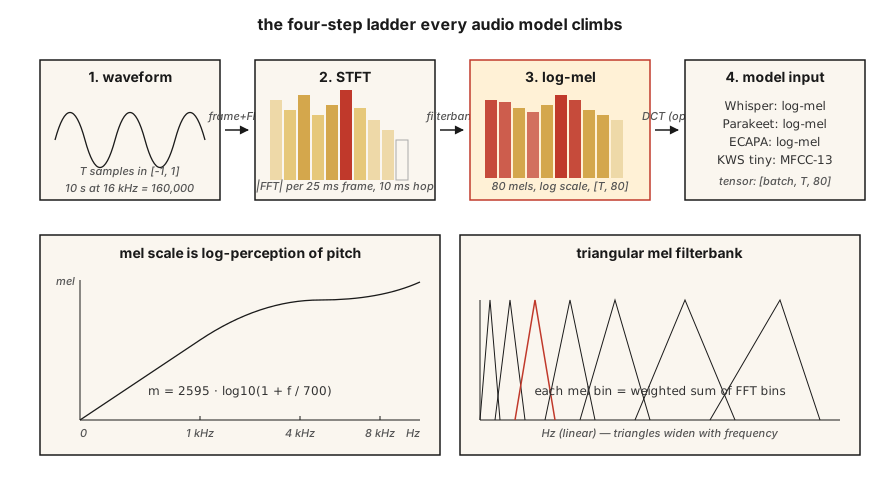
STFT(短时傅里叶变换)。 把波形切成重叠的帧(典型配置:25 ms 窗、10 ms 帧移,在 16 kHz 下即 400 个采样点 / 160 个采样点)。每帧乘一个窗函数(默认 Hann;Hamming 的取舍略有不同)。对每帧做 FFT。把幅值谱堆叠成形状为 (n_frames, n_freq_bins) 的矩阵。这就是频谱图。
对数幅值。 原始幅值跨越 5–6 个数量级。取 log(|X| + 1e-6) 或 20 * log10(|X|) 来压缩动态范围。所有生产 pipeline 都用对数幅值,而不是原始幅值。
梅尔尺度。 频率 f(Hz)按 m = 2595 \cdot \log_{10}(1 + f / 700) 映射到梅尔值 m。这个映射在 1 kHz 以下大致线性,以上大致对数。覆盖 0–8 kHz 的 80 个梅尔 bin 是标准的 ASR 输入。
梅尔滤波器组。 一组在梅尔尺度上等距排列的三角滤波器。每个滤波器都是相邻 FFT bin 的加权和。STFT 幅值矩阵乘以滤波器组矩阵,一次矩阵乘法就得到梅尔频谱图。
Log-mel 频谱图。 log(mel_spec + 1e-10)。Whisper 的输入。Parakeet 的输入。SeamlessM4T 的输入。2026 年通用的音频前端。
MFCC。 对 log-mel 频谱图做 DCT(type II),保留前 13 个系数。这样能去相关并进一步压缩特征。约 2015 年之前它是主导特征,之后 CNN/Transformer 直接处理原始 log-mel 追了上来。说话人识别中仍在用(x-vector、ECAPA)。
分辨率取舍。 更大的 FFT 带来更好的频率分辨率,但时间分辨率更差。25 ms / 10 ms 是音频机器学习的默认值;音乐用 50 ms / 12.5 ms;瞬态检测(鼓点、爆破音)用 5 ms / 2 ms。
构建它
第 1 步:对波形分帧
pythondef frame(signal, frame_len, hop):
n = 1 + (len(signal) - frame_len) // hop
return [signal[i * hop : i * hop + frame_len] for i in range(n)]10 秒、16 kHz 的音频在 frame_len=400, hop=160 下得到 998 帧。
第 2 步:Hann 窗
pythonimport math
def hann(N):
return [0.5 * (1 - math.cos(2 * math.pi * n / (N - 1))) for n in range(N)]在 FFT 之前逐元素相乘。它消除了因在非零端点处截断而产生的频谱泄漏。
第 3 步:STFT 幅值
pythondef stft_magnitude(signal, frame_len=400, hop=160):
win = hann(frame_len)
frames = frame(signal, frame_len, hop)
return [magnitudes(dft([w * s for w, s in zip(win, f)])) for f in frames]生产环境用 torch.stft 或 librosa.stft(基于 FFT、向量化)。这里的循环只是教学用途;code/main.py 中它只处理短音频。
第 4 步:梅尔滤波器组
pythondef hz_to_mel(f):
return 2595.0 * math.log10(1.0 + f / 700.0)
def mel_to_hz(m):
return 700.0 * (10 ** (m / 2595.0) - 1)
def mel_filterbank(n_mels, n_fft, sr, fmin=0, fmax=None):
fmax = fmax or sr / 2
mels = [hz_to_mel(fmin) + (hz_to_mel(fmax) - hz_to_mel(fmin)) * i / (n_mels + 1)
for i in range(n_mels + 2)]
hzs = [mel_to_hz(m) for m in mels]
bins = [int(h * n_fft / sr) for h in hzs]
fb = [[0.0] * (n_fft // 2 + 1) for _ in range(n_mels)]
for m in range(n_mels):
for k in range(bins[m], bins[m + 1]):
fb[m][k] = (k - bins[m]) / max(1, bins[m + 1] - bins[m])
for k in range(bins[m + 1], bins[m + 2]):
fb[m][k] = (bins[m + 2] - k) / max(1, bins[m + 2] - bins[m + 1])
return fbn_fft=400、覆盖 0–8 kHz 的 80 个梅尔滤波器,会得到 (80, 201) 的矩阵。把 (n_frames, 201) 的 STFT 幅值乘以它的转置,得到 (n_frames, 80) 的梅尔频谱图。
第 5 步:log-mel
pythondef log_mel(mel_spec, eps=1e-10):
return [[math.log(max(v, eps)) for v in frame] for frame in mel_spec]常见替代方案:librosa.power_to_db(以参考值归一化的 dB)、10 * log10(power + eps)。Whisper 用的是更复杂的截断加归一化流程(见 Whisper 的 log_mel_spectrogram)。
第 6 步:MFCC
pythondef dct_ii(x, n_coeffs):
N = len(x)
return [
sum(x[n] * math.cos(math.pi * k * (2 * n + 1) / (2 * N)) for n in range(N))
for k in range(n_coeffs)
]对每个 log-mel 帧做 DCT,保留前 13 个系数,就得到 MFCC 矩阵。第一个系数通常被丢弃(它编码的是整体能量)。
使用它
2026 年的技术栈:
| 任务 | 特征 |
|---|---|
| ASR(Whisper、Parakeet、SeamlessM4T) | 80 维 log-mel,10 ms 帧移,25 ms 窗 |
| TTS 声学模型(VITS、F5-TTS、Kokoro) | 80 维梅尔,5–12 ms 帧移以获得精细时间控制 |
| 音频分类(AST、PANNs、BEATs) | 128 维 log-mel,10 ms 帧移 |
| 说话人嵌入(ECAPA-TDNN、WavLM) | 80 维 log-mel 或原始波形 SSL |
| 音乐(MusicGen、Stable Audio 2) | EnCodec 离散 token(不是梅尔) |
| 关键词唤醒 | 40 维 MFCC,用于小型设备 |
经验法则:如果你做的不是音乐,就从 80 维 log-mel 开始。 任何偏离都要自证合理性。
2026 年仍在交付的坑
- 梅尔数量不一致。 训练用 80 维,推理用 128 维。静默失败。在两端都把特征形状记入日志。
- 上游采样率不匹配。 在 22.05 kHz 下计算的梅尔和在 16 kHz 下看起来不一样。要在特征提取之前修好采样率。
- dB 与 log。 Whisper 期望 log-mel,不是 dB-mel。有些 Hugging Face pipeline 会自动检测;你的自定义代码不会。
- 归一化漂移。 训练时逐句归一化,推理时全局归一化。这是会让 WER 翻倍的生产 bug。
- 填充泄漏。 在音频末尾补零会让尾部帧产生平坦频谱。要对称填充,或者复制填充。
交付它
保存为 outputs/skill-feature-extractor.md。这项技能会针对给定的模型目标选择特征类型、梅尔数量、帧长/帧移与归一化方式。
练习
- 简单。 运行
code/main.py。它合成一段 chirp(频率从 200 Hz 扫到 4000 Hz),并打印每帧 argmax 的梅尔 bin。可选地绘图,确认与扫频一致。 - 中等。 用
n_mels取{40, 80, 128}、frame_len取{200, 400, 800}重跑。沿时间轴测量尖峰带宽。哪种组合对 chirp 的分辨最好? - 困难。 实现
power_to_db,并在 AudioMNIST 上比较一个小型 CNN 分类器使用 (a) 原始 log-mel、(b) 以ref=max的 dB-mel、(c) MFCC-13 + delta + delta-delta 时的 ASR 准确率。报告 top-1 准确率。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| 帧 | 一个切片 | 送入一次 FFT 的 25 ms 波形块。 |
| 帧移(hop) | 步长 | 相邻帧之间的采样点间隔;10 ms 是 ASR 默认值。 |
| 窗 | Hann/Hamming 之类 | 逐点乘子,把帧边缘渐隐到零。 |
| STFT | 频谱图生成器 | 分帧加窗的 FFT;得到时间 × 频率矩阵。 |
| 梅尔 | 扭曲的频率 | 对数感知尺度;m = 2595·log10(1 + f/700)。 |
| 滤波器组 | 那个矩阵 | 把 STFT 投影到梅尔 bin 的三角滤波器。 |
| Log-mel | Whisper 的输入 | log(mel_spec + eps);2026 年已标准化。 |
| MFCC | 老派特征 | 对 log-mel 做 DCT;13 个去相关系数。 |
延伸阅读
- Davis, Mermelstein (1980). Comparison of parametric representations for monosyllabic word recognition —— MFCC 论文。
- Stevens, Volkmann, Newman (1937). A Scale for the Measurement of the Psychological Magnitude Pitch —— 梅尔尺度的原始论文。
- OpenAI — Whisper source, log_mel_spectrogram —— 阅读参考实现。
- librosa feature extraction docs ——
mfcc、melspectrogram以及帧移/窗参数参考。 - NVIDIA NeMo — audio preprocessing —— Parakeet + Canary 模型的生产级 pipeline。
示意图共 1 张