问题
麦克风产生的是压力随时间变化的信号。你的神经网络消费的是张量。两者之间隔着一套约定,一旦违反,就会产生悄无声息的 bug:模型训练看起来正常,WER 却翻倍;TTS 交付时带着嘶嘶声;语音克隆系统记住的是麦克风,而不是说话人。
语音系统中的每个 bug 都可追溯到三个问题之一:
- 数据以什么采样率录制,模型又期望什么采样率?
- 信号是否发生了混叠?
- 你操作的是原始采样点,还是频域表示?
这几点做对了,第 6 阶段的其余内容就都可以驾驭。做错了,即便是 Whisper-Large-v4 也只会输出垃圾。
概念
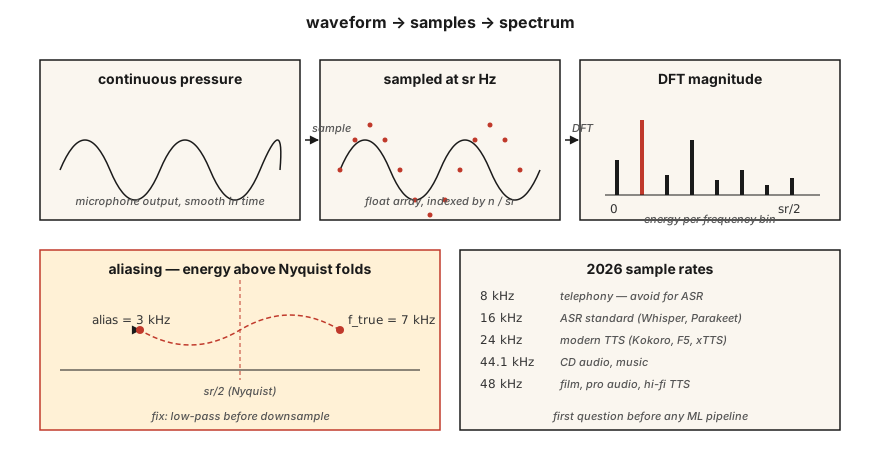
波形。 一维浮点数组,取值范围是 [-1.0, 1.0],以采样点序号为索引。要换算成秒,除以采样率:t = n / sr。一段 16 kHz 的 10 秒音频,就是包含 160,000 个浮点数的数组。
采样率(sr)。 每秒采样多少个点。2026 年的常见采样率:
| 采样率 | 用途 |
|---|---|
| 8 kHz | 电话、传统 VOIP。奈奎斯特频率在 4 kHz,会把辅音毁掉。ASR 应避开。 |
| 16 kHz | ASR 标准。Whisper、Parakeet、SeamlessM4T v2 都使用 16 kHz。 |
| 22.05 kHz | 较老模型的 TTS 声码器训练。 |
| 24 kHz | 现代 TTS(Kokoro、F5-TTS、xTTS v2)。 |
| 44.1 kHz | CD 音频、音乐。 |
| 48 kHz | 电影、专业音频、高保真 TTS(VALL-E 2、NaturalSpeech 3)。 |
奈奎斯特-香农采样定理。 采样率为 sr 时,能够无歧义表示的频率上限是 sr/2。这个 sr/2 边界称为奈奎斯特频率。高于奈奎斯特频率的能量会发生混叠(aliasing)——被折叠到更低频段——从而污染信号。降采样之前一定要先做低通滤波。
位深。 16-bit PCM(有符号 int16,范围 ±32,767)是通用的交换格式。音乐用 24-bit,内部 DSP 用 32-bit 浮点。soundfile 之类的库读入 int16,但对外暴露 [-1, 1] 范围内的 float32 数组。
傅里叶变换。 任何有限信号都是一组不同频率正弦波之和。离散傅里叶变换(DFT)对 N 个采样点计算出 N 个复数系数——每个频率 bin 对应一个。bin k 对应频率 k · sr / N Hz。幅值是该频率的振幅,角度是相位。
FFT。 快速傅里叶变换:当 N 是 2 的幂时,用于计算 DFT 的 O(N log N) 算法。所有音频库底层都用 FFT。16 kHz 下做 1024 点 FFT,得到 512 个可用频率 bin,覆盖 0–8 kHz,分辨率 15.6 Hz。
分帧与加窗。 我们不会对整个音频片段做一次 FFT。而是把它切成互相重叠的帧(通常 25 ms,帧移 10 ms),每帧乘以一个窗函数(Hann、Hamming)以消除边缘不连续,然后对每帧做 FFT。这就是短时傅里叶变换(STFT)。第 02 课从这里继续。
构建它
第 1 步:读取音频并绘制波形
code/main.py 只使用标准库 wave 模块,让演示不依赖第三方库。生产环境里你会用 soundfile 或 torchaudio.load(两者都返回 (waveform, sr) 元组):
pythonimport soundfile as sf
waveform, sr = sf.read("clip.wav", dtype="float32") # shape (T,), sr=int第 2 步:从第一性原理合成正弦波
pythonimport math
def sine(freq_hz, sr, seconds, amp=0.5):
n = int(sr * seconds)
return [amp * math.sin(2 * math.pi * freq_hz * i / sr) for i in range(n)]440 Hz 正弦波(标准音 A)在 16 kHz 下持续 1 秒,就是 16,000 个浮点数。用 wave.open(..., "wb") 以 16-bit PCM 编码写入。
第 3 步:手写计算 DFT
pythondef dft(x):
N = len(x)
out = []
for k in range(N):
re = sum(x[n] * math.cos(-2 * math.pi * k * n / N) for n in range(N))
im = sum(x[n] * math.sin(-2 * math.pi * k * n / N) for n in range(N))
out.append((re, im))
return outO(N²) —— 对 N=256 验证正确性足够,用于真实音频则毫无用处。真实代码会调用 numpy.fft.rfft 或 torch.fft.rfft。
第 4 步:找出主导频率
幅值峰值索引 k_star 对应频率 k_star * sr / N。对 440 Hz 正弦波运行这段代码,峰值应出现在 bin 440 * N / sr 处。
第 5 步:演示混叠
以 10 kHz 采样 7 kHz 正弦波(奈奎斯特频率 = 5 kHz)。7 kHz 音调高于奈奎斯特频率,会折叠到 10 − 7 = 3 kHz。FFT 峰值出现在 3 kHz。这是经典的混叠演示,也是每个 DAC/ADC 都配有砖墙式低通滤波器的原因。
使用它
2026 年你实际会用的技术栈:
| 任务 | 库 | 原因 |
|---|---|---|
| 读写 WAV/FLAC/OGG | soundfile(libsndfile 封装) | 最快、稳定、返回 float32。 |
| 重采样 | torchaudio.transforms.Resample 或 librosa.resample | 内置正确的抗混叠处理。 |
| STFT / 梅尔 | torchaudio 或 librosa | 对 GPU 友好;PyTorch 生态。 |
| 实时流式 | sounddevice 或 pyaudio | 跨平台的 PortAudio 绑定。 |
| 检查文件 | ffprobe 或 soxi | CLI 工具,快速报告采样率/声道数/编解码器。 |
决策规则:先对齐采样率,再对齐其他一切。Whisper 期望 16 kHz 单声道 float32。喂给它 44.1 kHz 立体声,你会得到看起来像模型 bug 的垃圾输出。
交付它
保存为 outputs/skill-audio-loader.md。这项技能帮你检查音频输入是否符合下游模型的预期,并在不符合时正确重采样。
练习
- 简单。 在 16 kHz 下合成一段 1 秒的 220 Hz + 440 Hz + 880 Hz 混合信号。运行 DFT,确认在预期 bin 上出现三个峰值。
- 中等。 以 48 kHz 录一段 3 秒的自己的声音。先用
torchaudio.transforms.Resample(带抗混叠)降到 16 kHz,再用朴素抽取(每三个采样点取一个)降到 16 kHz。对两者分别做 FFT。混叠出现在哪里? - 困难。 只用
math和第 3 步的 DFT 从零实现 STFT。帧长 400,帧移 160,Hann 窗。用matplotlib.pyplot.imshow绘制幅值图。这就是第 02 课要讲的频谱图。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| 采样率 | 每秒多少个采样点 | ADC 测量信号的频率,单位 Hz。 |
| 奈奎斯特 | 能表示的最高频率 | sr/2;高于它的能量会混叠折回低频。 |
| 位深 | 每个采样点的分辨率 | int16 = 65,536 个级别;float32 在 [-1, 1] 内提供 24-bit 精度。 |
| DFT | 序列的傅里叶变换 | N 个采样点 → N 个复数频率系数。 |
| FFT | 快速 DFT | 要求 N 为 2 的幂的 O(N log N) 算法。 |
| Bin | 频率列 | k · sr / N Hz;分辨率 = sr / N。 |
| STFT | 底层意义上的频谱图 | 随时间分帧加窗的 FFT。 |
| 混叠 | 奇怪的频率鬼影 | 高于奈奎斯特频率的能量镜像折回较低 bin。 |
延伸阅读
- Shannon (1949). Communication in the Presence of Noise —— 采样定理背后的论文。
- Smith — The Scientist and Engineer's Guide to Digital Signal Processing —— 免费、经典的 DSP 教材。
- librosa docs — audio primer —— 带代码的实用入门教程。
- Heinrich Kuttruff — Room Acoustics (6th ed.) —— 解释真实世界音频为何不是干净正弦波的参考书。
- Steve Eddins — FFT Interpretation notebook —— 10 分钟讲清频率 bin 直觉。
示意图共 1 张