问题
2017 年以前,地球上所有最先进的序列模型——语言、翻译、语音——都是循环神经网络。LSTM 和 GRU 在相当于 ImageNet 级别的翻译基准上统治了五年。它们是当时仅有的工具。
它们有三个致命弱点。顺序计算意味着无法沿时间轴并行:token t+1 需要 token t 的隐藏状态。一个 1,024 token 的序列意味着在每周期可执行 1,000,000 次浮点运算的 GPU 上要做 1,024 个串行步骤。在为并行而设计的硬件上,训练的实际耗时随序列长度线性增长。
梯度消失意味着 50 个 token 之前的信息已经经过 50 层非线性压缩。门控循环单元(LSTM、GRU)缓和了这种挤压,但从未消除它。长距离依赖——「我去年夏天在飞往京都的飞机上读的那本书是……」——经常失效。
固定宽度的隐藏状态意味着编码器先把整个源序列压缩成一个向量,解码器才看到任何东西。源是 5 个 token 还是 500 个都一样;瓶颈的形状不变。
2017 年的论文「Attention Is All You Need」提出了一个激进的想法:完全抛弃循环。让每个位置并行地关注所有其他位置。用一次大的矩阵乘法训练,而不是 1,024 次串行的。
其成果到 2026 年统治了每一种模态。语言(GPT-5、Claude 4、Llama 4)、视觉(ViT、DINOv2、SAM 3)、音频(Whisper)、生物(AlphaFold 3)、机器人(RT-2)。同一个模块,不同的输入。
概念
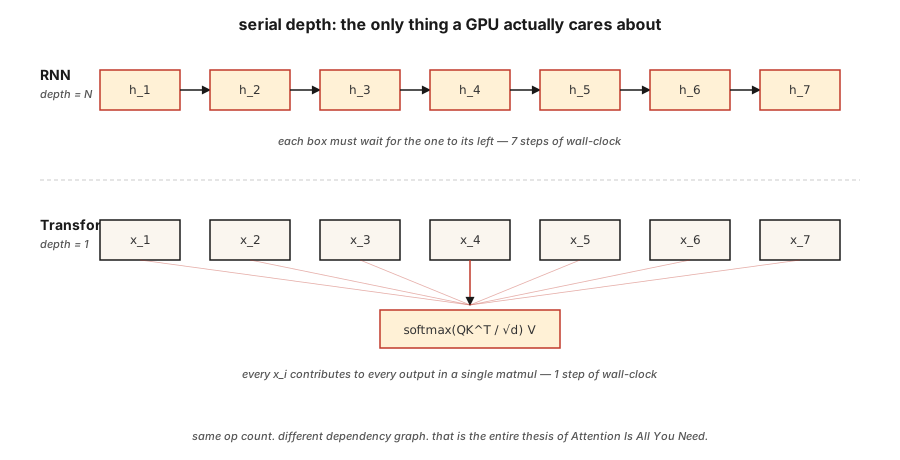
循环作为瓶颈。 RNN 计算 h_t = f(h_{t-1}, x_t)。每一步都依赖上一步。你无法在 h_4 之前算出 h_5。在拥有 10,000+ 并行核心的现代 GPU 上,这在长序列上浪费了 99% 的硅片。
注意力作为广播。 自注意力对每一对 (i, j) 同时计算 output_i = sum_j(a_ij * v_j)。整个 N×N 注意力矩阵在一次批量矩阵乘法中填满。没有哪一步依赖另一步。GPU 最喜欢这种工作。
加速不是常数。 它是 O(N) 串行深度与 O(1) 串行深度之间的差别。实践中,在 N=512 的同等硬件上,Transformer 每 epoch 训练快 5–10 倍;随着序列变长,差距会继续扩大,直到撞上注意力的 O(N^2) 内存墙(后来由 Flash Attention 解决——见第 12 课)。
Transformer 的代价。 注意力内存按 O(N^2) 扩展。2K 上下文没问题。128K 上下文则需要滑动窗口、RoPE 外推、Flash Attention 分块或线性注意力变体。循环在时间和内存上都是 O(N);Transformer 用内存换时间,再通过并行把时间赢回来。
归纳偏置的转变。 RNN 假设局部性和近因性。Transformer 什么都不假设——每一对都是注意力的候选。这解释了为什么 Transformer 需要更多数据才能训练好,但一旦有了数据就能扩展得更远。Chinchilla(2022)将其形式化:给定足够的 token,Transformer 总会击败参数量相同的 RNN。
构建它
这里没有神经网络——我们用数值方式模拟核心瓶颈,让你在笔记本上就能感受到差距。
第 1 步:测量串行深度
见 code/main.py。我们构建两个函数。一个把序列编码为一连串加法(串行,像 RNN)。另一个把它编码为并行归约(广播,像注意力)。相同的数学,不同的依赖图。
pythondef rnn_style(xs):
h = 0.0
for x in xs:
h = 0.9 * h + x # can't parallelize: h depends on previous h
return h
def attention_style(xs):
return sum(xs) / len(xs) # every x is independent我们对最多 100,000 个元素的序列计时。RNN 版本是 O(N) 且只有一条 CPU pipeline。即使在纯 Python 中,注意力风格的归约在长度 ≥ 1,000 时也能胜出,因为 Python 的 sum() 用 C 实现,迭代时没有每步的解释器开销。
第 2 步:计算理论运算量
两种算法都做 N 次加法。区别在于依赖深度:下一次运算开始前,必须顺序完成多少次运算。RNN 深度 = N。注意力深度 = 树形归约的 log(N),或并行扫描的 1。决定 GPU 时间的是深度,不是运算次数。
第 3 步:长序列上的经验扩展
我们打印一张计时表,让 O(N) 的差距可见。在 2026 年的 Mac 笔记本上,1,000 个元素以下的序列快到无法测量。100,000 个元素的序列显示出干净的线性扫描。把它放大到 16,384 token 的 Transformer 和等价的 12 层 LSTM,你就明白为什么在 2016 年训练的实际耗时会成为拦路虎。
使用它
2026 年什么时候仍然该选 RNN:
| 场景 | 选择 |
|---|---|
| 流式推理,一次一个 token,内存恒定 | RNN 或状态空间模型(Mamba、RWKV) |
| 超长序列(>1M token),注意力内存爆炸 | 线性注意力、Mamba 2、Hyena |
| 没有矩阵乘法加速器的边缘设备 | 深度可分离 RNN 在 FLOPs/瓦特上仍然胜出 |
| 其他所有场景(训练、批量推理、128K 以内的上下文) | Transformer |
状态空间模型(SSM)如 Mamba 本质上是带结构化参数化的 RNN,兼具两者之长:O(N) 的扫描内存,通过选择性扫描实现并行训练。它们以更好的长上下文扩展性恢复了 Transformer 90% 的质量。2026 年大多数前沿实验室都在训练 SSM+Transformer 混合模型(如 Jamba、Samba)——循环没有死,它只是变成了一个组件。
交付它
见 outputs/skill-architecture-picker.md。这个 skill 根据长度、吞吐量和训练预算约束,为新的序列问题挑选架构。对于超过 1B token 的训练任务,它应始终拒绝推荐纯 RNN,除非同时说明权衡。
练习
- 简单。 取
code/main.py中的rnn_style,把标量隐藏状态替换为长度为 64 的隐藏状态向量。重新计时。串行开销随隐藏状态维度增长了多少? - 中等。 用纯 Python 实现并行前缀和(Hillis-Steele 扫描)。验证它在长度 1024 上与串行扫描产生相同的数值输出。统计深度。
- 困难。 把注意力风格的归约移植到 GPU 上的 PyTorch。将序列长度从 64 扫到 65,536,分别计时。画出曲线并解释其形状。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Recurrence | 「RNN 是串行的」 | 第 t 步依赖第 t-1 步的计算,沿时间轴强制串行执行。 |
| Serial depth | 「图有多深」 | 依赖运算的最长链;即使在无限硬件上也决定实际耗时。 |
| Attention | 「让 token 互相看」 | 加权和 \sum_j a_{ij} v_j,其中 a_{ij} 来自位置 i 与 j 之间的相似度得分。 |
| Context window | 「模型能看到多少」 | 一个注意力层能作为输入的位置数量;二次方内存成本在此处扩展。 |
| Inductive bias | 「烙进架构的假设」 | 关于数据长什么样的先验;CNN 假设平移不变性,RNN 假设近因性。 |
| State-space model | 「背后有代数的 RNN」 | 通过结构化状态空间矩阵参数化为可并行训练的循环。 |
| Quadratic bottleneck | 「上下文为什么这么贵」 | 注意力内存 = O(N^2)(序列长度);Flash Attention 隐藏的是常数,不是扩展阶数。 |
延伸阅读
- Vaswani 等(2017). Attention Is All You Need —— 终结了循环结构在主流 NLP 中统治地位的论文。
- Bahdanau、Cho、Bengio(2014). Neural MT by Jointly Learning to Align and Translate —— 注意力诞生之处,当时还挂在 RNN 上。
- Hochreiter、Schmidhuber(1997). Long Short-Term Memory —— 原始 LSTM 论文,存档用。
- Gu、Dao(2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces —— 对 Transformer 的现代循环式回答。
示意图共 1 张