问题
仅解码器的 GPT 和仅编码器的 BERT 各自为了不同目标,删减了 2017 年的原始架构。但很多任务天然就是输入-输出形式:
- 翻译:英语 → 法语。
- 摘要:5,000 token 的文章 → 200 token 的摘要。
- 语音识别:音频 token → 文本 token。
- 结构化抽取:散文 → JSON。
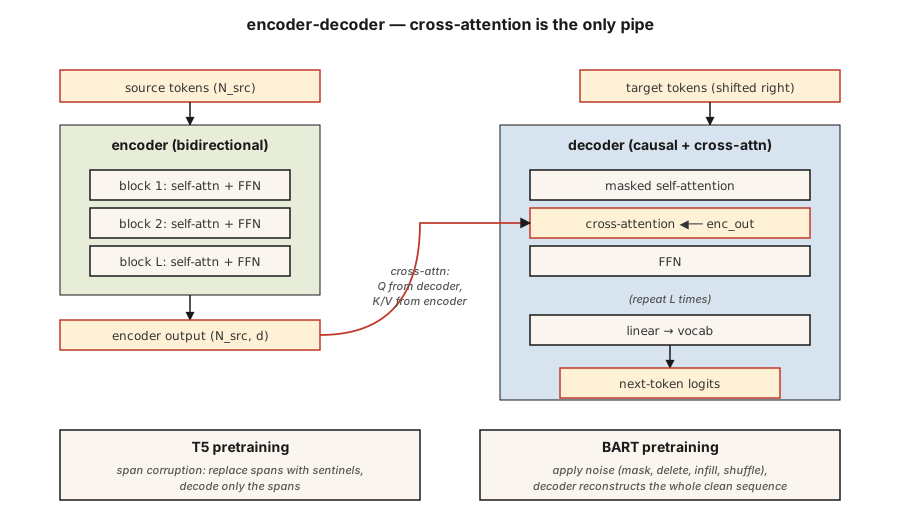
对这类任务,编码器-解码器是最干净的选择。编码器产生源端的稠密表示。解码器在每一步交叉关注这份表示来生成输出。训练时在输出端做错一位预测。损失与 GPT 相同,只是以编码器输出为条件。
两篇论文定义了现代范式:
- T5(Raffel 等,2019)。「Text-to-Text Transfer Transformer」。每个 NLP 任务都被重新表述为文本进、文本出。单一架构、单一词表、单一损失。用掩码片段预测做预训练(破坏输入中的片段,在输出中解码出来)。
- BART(Lewis 等,2019)。「Bidirectional and Auto-Regressive Transformer」。去噪自编码器:以多种方式破坏输入(打乱、掩码、删除、旋转),让解码器重建原始内容。
2026 年,编码器-解码器格式仍在输入结构重要的地方延续:
- Whisper(语音 → 文本)。
- Google 的翻译栈。
- 一些代码补全/修复模型,其上下文与编辑具有不同的结构。
- Flan-T5 及其用于结构化推理任务的变体。
仅解码器抢尽了风头,但编码器-解码器从未消失。
概念
前向循环
source tokens ─▶ encoder ─▶ (N_src, d_model) ──┐
│
target tokens ─▶ decoder block │
├─▶ masked self-attention │
├─▶ cross-attention ◀───────────┘
└─▶ FFN
↓
next-token logits关键在于,编码器对每个输入只运行一次。解码器自回归运行,但每一步都交叉关注同一份编码器输出。缓存编码器输出对长输入是白送的加速。
T5 预训练——片段破坏
从输入中随机挑选若干片段(平均长度 3 个 token,共占 15%)。每个片段替换为唯一的哨兵 token:<extra_id_0>、<extra_id_1> 等。解码器只输出被破坏的片段,并带上各自的哨兵前缀:
source: The quick <extra_id_0> fox jumps <extra_id_1> dog
target: <extra_id_0> brown <extra_id_1> over the lazy这比预测整条序列的信号更便宜。在 T5 论文的消融实验中,它与 MLM(BERT)和 prefix-LM(UniLM)相当。
BART 预训练——多重噪声去噪
BART 尝试了五种加噪函数:
- Token 掩码。
- Token 删除。
- 文本填充(掩掉一个片段,解码器补上正确长度)。
- 句子打乱。
- 文档旋转。
文本填充加句子打乱的组合取得了最好的下游指标。解码器始终重建原始内容。BART 的输出是整条序列,而不只是被破坏的片段——所以预训练算力高于 T5。
推理
与 GPT 相同的自回归生成。贪心、束搜索、top-p 采样都适用。宽度 4–5 的束搜索是翻译和摘要的标准做法,因为这些任务的输出分布比聊天更窄。
2026 年如何选择
| 任务 | 用编码器-解码器? | 原因 |
|---|---|---|
| 翻译 | 通常用 | 源序列清晰;输出分布固定;束搜索有效 |
| 语音转文本 | 用(Whisper) | 输入模态与输出不同;编码器塑造音频特征 |
| 聊天 / 推理 | 不用,仅解码器 | 没有持久的「输入」——对话本身就是序列 |
| 代码补全 | 通常不用 | 长上下文的仅解码器模型更胜一筹;Qwen 2.5 Coder 等代码模型就是仅解码器 |
| 摘要 | 都可以 | BART、PEGASUS 曾胜过早期的仅解码器基线;现代仅解码器 LLM 已能与之匹敌 |
| 结构化抽取 | 都可以 | T5 更干净,因为「文本 → 文本」能吸收任何输出格式 |
2022 年以来的趋势:仅解码器模型正在接管原本属于编码器-解码器的任务,原因有三:(a) 经指令微调的仅解码器 LLM 通过 prompt 就能泛化到任何任务;(b) 一套架构比两套更容易扩展;(c) RLHF 默认面向解码器。编码器-解码器则在输入模态不同(语音、图像)或束搜索质量重要的场景中守住阵地。
构建它
见 code/main.py。我们为玩具语料实现 T5 风格的片段破坏——这是本课最有用的一个零件,因为此后每个编码器-解码器预训练配方里都有它。
第 1 步:片段破坏
pythondef corrupt_spans(tokens, mask_rate=0.15, mean_span=3.0, rng=None):
"""Pick spans summing to ~mask_rate of tokens. Return (corrupted_input, target)."""
n = len(tokens)
n_mask = max(1, int(n * mask_rate))
n_spans = max(1, int(round(n_mask / mean_span)))
...目标格式遵循 T5 惯例:<sent0> span0 <sent1> span1 ...。被破坏的输入把未改动的 token 与片段位置上的哨兵 token 交错排列。
第 2 步:验证往返重建
给定被破坏的输入和目标,重建原始句子。如果破坏过程可逆,前向传播就有良好定义。这是一个健全性检查——真实训练不会做这一步,但测试成本很低,还能抓出片段记账中的差一错误。
第 3 步:BART 加噪
五个函数:token_mask、token_delete、text_infill、sentence_permute、document_rotate。组合其中两个并展示结果。
使用它
HuggingFace 参考写法:
pythonfrom transformers import T5ForConditionalGeneration, T5Tokenizer
tok = T5Tokenizer.from_pretrained("google/flan-t5-base")
model = T5ForConditionalGeneration.from_pretrained("google/flan-t5-base")
inputs = tok("translate English to French: Attention is all you need.", return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=32)
print(tok.decode(out[0], skip_special_tokens=True))T5 的诀窍:任务名写进输入文本。同一个模型处理几十种任务,因为每个任务都是文本进、文本出。2026 年,这一模式已被指令微调的仅解码器模型普遍化,但 T5 最先把它成文。
交付它
见 outputs/skill-seq2seq-picker.md。该 skill 依据输入-输出结构、延迟和质量目标,为新任务在编码器-解码器与仅解码器之间做选择。
练习
- 简单。 运行
code/main.py,对一条 30 token 的句子施加片段破坏,验证:把源端非哨兵 token 与解码出的目标片段拼接起来,能还原原句。 - 中等。 实现 BART 的
text_infill噪声:用单个<mask>token 替换随机片段,解码器必须推断出正确的片段长度和内容。展示一个例子。 - 困难。 在一个小小的英语 → 猪拉丁语(pig-Latin)语料(200 对)上微调
flan-t5-small。在留出的 50 对集合上测量 BLEU。与在相同数据和相同算力下微调Llama-3.2-1B作对比。
关键术语
| 术语 | 通俗说法 | 实际含义 |
|---|---|---|
| 编码器-解码器 | 「Seq2seq Transformer」 | 两套堆叠:用于输入的双向编码器,以及带交叉注意力、用于输出的因果解码器。 |
| 交叉注意力 | 「源端与目标端对话的地方」 | 解码器的 Q 乘以编码器的 K/V。编码器信息进入解码器的唯一通道。 |
| 片段破坏 | 「T5 的预训练技巧」 | 用哨兵 token 替换随机片段;解码器输出这些片段。 |
| 去噪目标 | 「BART 的玩法」 | 对输入施加加噪函数,训练解码器重建干净序列。 |
| 哨兵 token | 「<extra_id_N> 占位符」 | 特殊 token,在源端标记被破坏的片段,并在目标端重新标记。 |
| Flan | 「指令微调的 T5」 | 在 1,800 多个任务上微调的 T5;让编码器-解码器在指令遵循上具备竞争力。 |
| 束搜索 | 「解码策略」 | 每一步保留 top-k 个部分序列;翻译/摘要的标准做法。 |
| 教师强制 | 「训练时的输入」 | 训练时把真实的上一输出 token 喂给解码器,而不是采样得到的 token。 |
延伸阅读
- Raffel et al. (2019). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer —— T5。
- Lewis et al. (2019). BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension —— BART。
- Chung et al. (2022). Scaling Instruction-Finetuned Language Models —— Flan-T5。
- Radford et al. (2022). Robust Speech Recognition via Large-Scale Weak Supervision —— Whisper,2026 年最典型的编码器-解码器。
- HuggingFace
modeling_t5.py—— 参考实现。
示意图共 1 张