问题
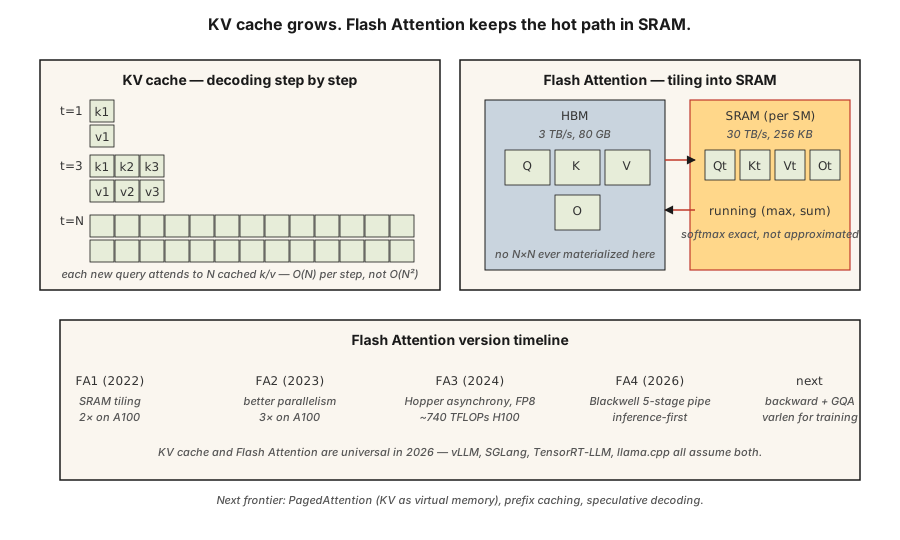
朴素的自回归解码器生成 N 个 token 要做 O(N^2) 的工作:每一步都在整个前缀上重算注意力。对一条 4K token 的回复,这就是 1600 万次注意力运算,其中大部分是冗余的。前缀 token 的每个隐藏状态一旦算出就是确定的——你只需要用新 token 的 query 去查询此前所有 token 缓存的 key 和 value。
除此之外,注意力本身搬运的数据也很多。标准注意力要实际生成 N×N 的分数矩阵、N×d 的 softmax 输出、N×d 的最终输出——对 HBM 的读写太多。当 N≥2K 时,注意力在触及 FLOP 瓶颈之前就先撞上显存带宽瓶颈。经典注意力内核只用到现代 GPU 能力的 1/4 到 1/10。
两项优化,都来自 Dao 等人,把前沿推理从「慢」推向「快」:
- KV cache。 存储每个前缀 token 的 K 和 V 向量。新 token 的注意力就是一次 query 对缓存 key 的查询。单个生成步的推理从 O(N^2) 降到 O(N)。
- Flash Attention。 把注意力计算分块(tile),让完整的 N×N 矩阵永远不落到 HBM。softmax 和矩阵乘法全部在 SRAM 中完成。A100 上实际耗时加速 2–4 倍;H100 配合 FP8 可达 5–10 倍。
到 2026 年,两者已是普遍配置。每个生产推理栈(vLLM、TensorRT-LLM、SGLang、llama.cpp)都默认依赖它们。每个前沿模型发布时都启用了 Flash Attention。
概念
KV cache 的计算
每个解码器层、每个 token、每个注意力头:
bytes_per_token_per_layer = 2 * d_head * dtype_size
^
K and V对于一个 7B 模型,32 层、32 头、d_head=128、fp16:
per token per layer = 2 * 128 * 2 = 512 bytes
per token (32 layers) = 16 KB
per 32K context = 512 MB对于 Llama 3 70B(80 层、d_head=128、8 个 KV 头的 GQA):
per token per layer = 2 * 8 * 128 * 2 = 4096 bytes (4 KB)
per 32K context = 10.4 GB正是这 10 GB,使得 Llama 3 70B 在 128K 上下文、batch size 为 1 时,光 KV cache 就要占掉 40 GB A100 的大部分。
GQA 是 KV cache 的赢家。 64 头的 MHA 会需要 32 GB。MLA 压缩得更狠。
拖动各个维度,观察缓存大小的变化。把序列长度或 batch 推高,看看它多快就超出单张 GPU 的容量:
Flash Attention——分块技巧
标准注意力:
S = Q @ K^T (HBM read, N×N, HBM write)
P = softmax(S) (HBM read, HBM write)
O = P @ V (HBM read, HBM write)三次 HBM 往返。在 H100 上,HBM 带宽是 3 TB/s,SRAM 是 30 TB/s。每一次 HBM 往返,相比把数据全部留在片上,都慢约 10 倍。
Flash Attention:
for each block of Q (tile size ~128 × 128):
load Q_tile into SRAM
for each block of K, V:
load K_tile, V_tile into SRAM
compute S_tile = Q_tile @ K_tile^T (SRAM)
running softmax aggregation (SRAM)
accumulate into O_tile (SRAM)
write O_tile to HBM每个块只做一次 HBM 往返。总内存占用从 O(N^2) 降到 O(N)。反向传播时从正向结果重算部分数值,而不是存储它们——又一次内存收益。
数值技巧。 流式 softmax 跨块维护 (max, sum),使最终归一化精确无误。它不是近似——Flash Attention 的输出与标准注意力逐位相同(忽略 fp16 的非结合性差异)。
版本演进:
| 版本 | 年份 | 关键变化 | 参考硬件上的加速 |
|---|---|---|---|
| Flash 1 | 2022 | 分块 SRAM 内核 | A100 上 2× |
| Flash 2 | 2023 | 更好的并行性,因果优先的顺序 | A100 上 3× |
| Flash 3 | 2024 | Hopper 异步、FP8 | H100 上 1.5–2×(约 740 TFLOPs FP16) |
| Flash 4 | 2026 | Blackwell 五级 pipeline,软件 exp2 | 推理优先(初期只支持前向) |
Flash 4 发布时只支持前向传播。训练仍使用 Flash 3。Flash 4 的 GQA 与变长(varlen)支持尚待推出(2026 年中)。
投机解码——另一项延迟收益
廉价模型提议 N 个 token。大模型并行验证全部 N 个。如果验证接受了 k 个 token,你就用一次大模型前向传播换来了 k 个生成结果。在代码和散文上,k 通常为 3–5。
2026 年的默认方案:
- EAGLE 2 / Medusa。 与验证模型共享隐藏状态的集成草稿头。加速 2–3 倍且无质量损失。
- 带草稿模型的投机解码。 在消费级硬件上加速 2–4 倍。
- 前瞻解码(Lookahead decoding)。 用 Jacobi 迭代;不需要草稿模型。小众但免费。
连续批处理
经典批处理推理:等最慢的序列结束,再开一个新 batch。当短回复早早结束时,GPU 就被浪费了。
连续批处理(最早在 Orca 中实现,现已进入 vLLM、TensorRT-LLM、SGLang):旧请求一结束就把新请求换进 batch。对典型聊天负载,吞吐量提升 5–10 倍。
PagedAttention——把 KV cache 当作虚拟内存
vLLM 的招牌特性。KV cache 按 16 个 token 一块分配;页表把逻辑位置映射到物理块。这样可以跨并行样本共享 KV(束搜索、并行采样),为 prompt 缓存热切换前缀,并整理内存碎片。相比朴素的连续分配,吞吐量提升 4 倍。
构建它
见 code/main.py。我们实现:
- 一个朴素的 O(N^2) 增量解码器。
- 一个 O(N) 的 KV cache 解码器。
- 一个模拟 Flash Attention 运行最大值算法的分块 softmax。
第 1 步:KV cache
pythonclass KVCache:
def __init__(self, n_layers, n_heads, d_head):
self.K = [[[] for _ in range(n_heads)] for _ in range(n_layers)]
self.V = [[[] for _ in range(n_heads)] for _ in range(n_layers)]
def append(self, layer, head, k, v):
self.K[layer][head].append(k)
self.V[layer][head].append(v)
def read(self, layer, head):
return self.K[layer][head], self.V[layer][head]很简单:在逐层、逐头的列表里不断追加每个 token 的 K、V 向量。
第 2 步:分块 softmax
pythondef tiled_softmax_dot(q, K, V, tile=4):
"""Flash-attention-style softmax(qK^T)V with running max/sum."""
m = float("-inf")
s = 0.0
out = [0.0] * len(V[0])
for start in range(0, len(K), tile):
k_block = K[start:start + tile]
v_block = V[start:start + tile]
scores = [sum(qi * ki for qi, ki in zip(q, k)) for k in k_block]
new_m = max(m, *scores)
exp_old = math.exp(m - new_m) if m != float("-inf") else 0.0
exp_new = [math.exp(sc - new_m) for sc in scores]
s = s * exp_old + sum(exp_new)
for j in range(len(out)):
out[j] = out[j] * exp_old + sum(e * v[j] for e, v in zip(exp_new, v_block))
m = new_m
return [o / s for o in out]输出与一次性计算 softmax(qK) V 逐位相同,但任意时刻的工作集只是一个 tile × d_head 的块,而不是完整的 N × d_head。
第 3 步:在 100 token 生成上比较朴素解码与缓存解码
统计注意力运算次数。朴素:O(N^2) = 5050。缓存:O(N) = 100。代码会打印两者。
使用它
python# HuggingFace transformers auto-enables KV cache on decoder-only generate().
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-3.2-3B",
attn_implementation="flash_attention_2", # use FA3 if Hopper
torch_dtype="bfloat16",
)
# generate() uses KV cache automaticallyvLLM 生产部署:
bashpip install vllm
vllm serve meta-llama/Llama-3.1-70B-Instruct \
--tensor-parallel-size 4 \
--max-model-len 32768 \
--enable-prefix-caching \
--kv-cache-dtype fp8跨请求的前缀缓存是 2026 年的一大收益——相同的系统 prompt、少样本示例或长上下文文档可以在多次调用间复用 KV。对于反复使用工具 prompt 的 Agent 负载,前缀缓存通常带来 5 倍吞吐提升。
交付它
见 outputs/skill-inference-optimizer.md。该 skill 为新的推理部署选择注意力实现、KV cache 策略、量化和投机解码方案。
练习
- 简单。 运行
code/main.py。确认朴素解码器和缓存解码器输出相同;注意运算次数的差异。 - 中等。 实现前缀缓存:给定 prompt P 和若干条补全,先对 P 跑一次前向传播填满 KV cache,再分别为每条补全分支。测量相对每次都重新编码 P 的加速比。
- 困难。 实现一个玩具版 PagedAttention:KV cache 放在固定的 16 token 块中,并用一个空闲链表管理。序列结束时把它占用的块归还池中。模拟 1,000 次长度不一的聊天补全。比较内存碎片与连续分配的差异。
关键术语
| 术语 | 通俗说法 | 实际含义 |
|---|---|---|
| KV cache | 「让解码变快的技巧」 | 保存每个前缀 token 的 K 和 V;新的 query 直接关注它们,不再重算。 |
| HBM | 「GPU 主存」 | High Bandwidth Memory;H100 上 80 GB,B200 上 192 GB。带宽约 3 TB/s。 |
| SRAM | 「片上内存」 | 每个 SM 的高速内存,H100 上每个 SM 约 256 KB。带宽约 30 TB/s。 |
| Flash Attention | 「分块注意力内核」 | 计算注意力时不必在 HBM 中物化 N×N 矩阵。 |
| 连续批处理 | 「不等人的批处理」 | 把完成的序列换出、新序列换入,无需清空整个 batch。 |
| PagedAttention | 「vLLM 的招牌」 | KV cache 按固定块分配并配有页表;消除内存碎片。 |
| 前缀缓存 | 「复用长 prompt」 | 跨请求缓存共享前缀的 KV;为 Agent 大幅降低成本。 |
| 投机解码 | 「草稿 + 验证」 | 廉价的草稿模型提议 token;大模型一次前向验证 k 个。 |
延伸阅读
- Dao et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness —— Flash 1。
- Dao (2023). FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning —— Flash 2。
- Shah et al. (2024). FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision —— Flash 3。
- FlashAttention-4 release notes (Dao-AILab, 2026) —— Blackwell 五级 pipeline 以及软件 exp2 技巧;本课提到的「发布时仅支持前向」等注意事项,可读该仓库 README。
- Kwon et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention —— vLLM 论文。
- Leviathan et al. (2023). Fast Inference from Transformers via Speculative Decoding —— 投机解码。
- Li et al. (2024). EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty —— EAGLE-1/2 论文,本课引用的集成草稿方案。
- Cai et al. (2024). Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads —— 与 EAGLE 并列提到的 Medusa 方案。
- vLLM docs — PagedAttention —— 关于 16 token 块与页表设计的权威深入解析。
示意图共 1 张