问题
缩放点积注意力对顺序是盲的。注意力矩阵 softmax(Q K^T / √d) V 由两两相似度算出。打乱 X 的行,输出的行也会以同样方式被打乱。注意力内部没有任何东西关心位置。
这在词袋模型里不是缺陷。对语言、代码、音频、视频——任何顺序承载意义的场景——它是致命的。
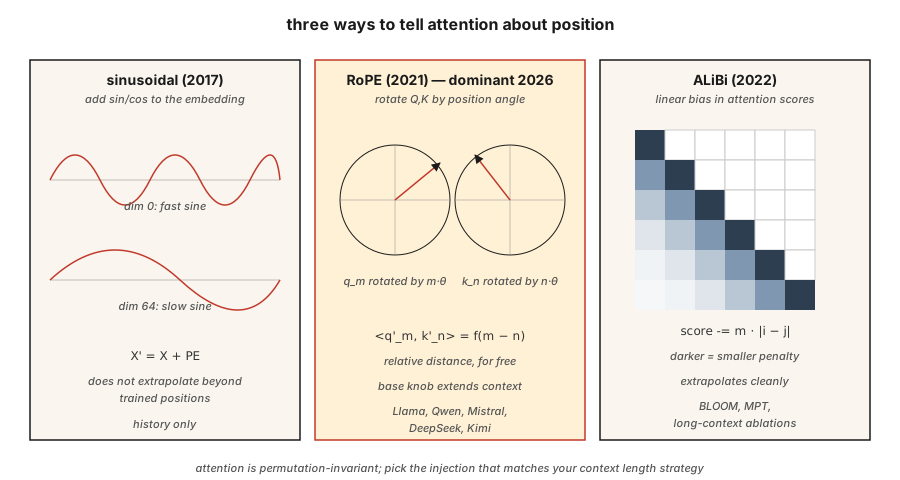
修复的办法是把位置以某种方式注入 embedding。三个时代的答案:
- 绝对正弦(Vaswani 2017)。把位置的
sin/cos加到 embedding 上。简单、无需学习、在训练长度之外外推很差。 - RoPE——旋转位置编码(Rotary Position Embeddings)(Su 2021)。按与位置成正比的角度旋转 Q 和 K 向量。在点积中直接编码相对位置。2026 年的主流。
- ALiBi——带线性偏置的注意力(Attention with Linear Biases)(Press 2022)。完全跳过 embedding;根据距离给每个头的注意力分数加线性惩罚。长度外推极佳。
截至 2026 年,几乎所有前沿开源模型都用 RoPE:Llama 2/3/4、Qwen 2/3、Mistral、Mixtral、DeepSeek-V3、Kimi。少数长上下文模型使用 ALiBi 或其现代变体。绝对正弦已是历史。
概念
绝对正弦
预先计算一个形状为 (max_len, d_model) 的固定矩阵 PE:
然后在注意力之前令 X' = X + PE[:N]。每个维度都是不同频率的正弦波。模型学会从相位模式中读出位置。超过 max_len 就会失效:模型只见过 0–2047 的位置,没人告诉它位置 2048 会发生什么。
RoPE
旋转 Q 和 K 向量(不是 embedding)。对于一对维度 (2i, 2i+1):
对位置为 pos_k 的 key 施加相同的旋转。点积 q'_m \cdot k'_n 变成仅与 (m - n) 有关的函数。也就是说:注意力分数只依赖相对距离,尽管旋转是按绝对位置施加的。这是个漂亮的技巧。
扩展 RoPE:base 可以被缩放(NTK-aware、YaRN、LongRoPE),从而在不重新训练的情况下外推到更长的上下文。Llama 3 就是用这种方式把上下文从 8K 扩展到 128K。
ALiBi
跳过 embedding 技巧,直接给注意力分数加偏置:
其中 m_h 是每个头特定的斜率(例如 1 / 2^{8h/H})。更近的 token 得到提升;更远的 token 被惩罚。没有训练时开销。论文显示其长度外推优于正弦编码,并能在原始训练长度上匹敌 RoPE。
2026 年怎么选
| 变体 | 外推能力 | 训练成本 | 使用者 |
|---|---|---|---|
| 绝对正弦 | 差 | 免费 | 原始 Transformer、早期 BERT |
| 可学习绝对位置 | 无 | 极小 | GPT-2、GPT-3 |
| RoPE | 配合缩放则好 | 免费 | Llama 2/3/4、Qwen 2/3、Mistral、DeepSeek-V3、Kimi |
| RoPE + YaRN | 极佳 | 微调阶段 | Qwen2-1M、Llama 3.1 128K |
| ALiBi | 极佳 | 免费 | BLOOM、MPT、Baichuan |
RoPE 胜出,因为它无需改变架构就能嵌入注意力、编码相对位置,而且它的 base 超参数为长上下文微调提供了一个干净的旋钮。
构建它
第 1 步:正弦编码
见 code/main.py。四行计算:
pythondef sinusoidal(N, d):
pe = [[0.0] * d for _ in range(N)]
for pos in range(N):
for i in range(d // 2):
theta = pos / (10000 ** (2 * i / d))
pe[pos][2 * i] = math.sin(theta)
pe[pos][2 * i + 1] = math.cos(theta)
return pe在第一个注意力层之前把它加到 embedding 矩阵上。
第 2 步:把 RoPE 应用于 Q、K
RoPE 对 Q 和 K 原地操作。对每一对维度:
pythondef apply_rope(x, pos, base=10000):
d = len(x)
out = list(x)
for i in range(d // 2):
theta = pos / (base ** (2 * i / d))
c, s = math.cos(theta), math.sin(theta)
a, b = x[2 * i], x[2 * i + 1]
out[2 * i] = a * c - b * s
out[2 * i + 1] = a * s + b * c
return out关键:对位置为 m 的 Q 和位置为 n 的 K 施加同一个函数。它们的点积会在每个坐标对上带出一个 \cos((m-n) \cdot \theta_i) 因子。注意力免费学会了相对位置。
第 3 步:ALiBi 斜率与偏置
pythondef alibi_bias(n_heads, seq_len):
# slope_h = 2 ** (-8 * h / n_heads) for h = 1..n_heads
slopes = [2 ** (-8 * (h + 1) / n_heads) for h in range(n_heads)]
bias = []
for m in slopes:
row = [[-m * abs(i - j) for j in range(seq_len)] for i in range(seq_len)]
bias.append(row)
return bias # add to attention scores before softmax把 bias[h] 加到第 h 个头的 (seq_len, seq_len) 注意力分数矩阵上,然后做 softmax。
第 4 步:验证 RoPE 的相对距离性质
取两个随机向量 a, b。按 (pos_a, pos_b) 旋转。再按 (pos_a + k, pos_b + k) 旋转。两次旋转后的点积必须在浮点误差内相同。这个性质正是 RoPE 的全部意义——它对绝对偏移不变,只有相对间隔起作用。
使用它
PyTorch 2.5+ 在 torch.nn.functional 中提供了 RoPE 工具。多数生产代码使用 flash_attn 或 xformers,其中 RoPE 在注意力 kernel 内部应用。
pythonfrom transformers import AutoModel
model = AutoModel.from_pretrained("meta-llama/Llama-3.2-3B")
# model.config.rope_scaling → {"type": "yarn", "factor": 32.0, "original_max_position_embeddings": 8192}2026 年的长上下文技巧:
- NTK-aware 插值。 从 4K 扩展到 16K+ 时,把
base重新缩放为base * (scale_factor)^(d/(d-2))。 - YaRN。 更聪明的插值方法,在长上下文上保持注意力熵。Llama 3.1 128K 使用它。
- LongRoPE。 微软 2024 年的方法,用进化搜索挑选逐维缩放因子。Phi-3-Long 使用它。
- 位置插值 + 微调。 直接按扩展因子缩小位置,然后用 1–5B token 微调。效果出奇地好。
交付它
见 outputs/skill-positional-encoding-picker.md。这个 skill 根据目标上下文长度、外推需求和训练预算,为新模型挑选编码策略。
练习
- 简单。 把
max_len=512, d=128的正弦PE矩阵画成热力图。确认「随着维度索引增长,条纹变宽」的模式。 - 中等。 实现 NTK-aware RoPE 缩放。在长度为 256 的序列上训练一个小型 LM,然后在长度 1024 上测试,分别使用和不使用缩放。测量困惑度。
- 困难。 在同一个注意力模块中实现 ALiBi 和 RoPE。在长度为 512 的复制任务上训练一个 4 层 Transformer。测试时外推到 2048。比较性能退化程度。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Positional encoding | 「告诉注意力顺序信息」 | 任何加到 embedding 或注意力上、用于编码位置的信号。 |
| Sinusoidal | 「最初的那一个」 | 按几何频率的 sin/cos 加到 embedding;不能外推。 |
| RoPE | 「旋转 embedding」 | 按位置相关的角度旋转 Q、K;点积编码相对距离。 |
| ALiBi | 「线性偏置技巧」 | 给注意力分数加 -m \cdot \lvert i-j \rvert;无需 embedding,外推极佳。 |
| base | 「RoPE 的旋钮」 | RoPE 中的频率缩放器;增大它可在推理时扩展上下文。 |
| NTK-aware | 「一种 RoPE 缩放技巧」 | 重新缩放 base,避免上下文扩展时高频维度被挤压。 |
| YaRN | 「讲究的那一个」 | 逐维插值 + 外推,保持注意力熵。 |
| Extrapolation | 「超出训练长度也能工作」 | 位置方案能否在超过训练时见过的 max_len 之后仍产出正确输出? |
延伸阅读
- Vaswani 等(2017). Attention Is All You Need §3.5 —— 原始正弦编码。
- Su 等(2021). RoFormer: Enhanced Transformer with Rotary Position Embedding —— RoPE 论文。
- Press、Smith、Lewis(2021). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation —— ALiBi。
- Peng 等(2023). YaRN: Efficient Context Window Extension of Large Language Models —— 最先进的 RoPE 缩放方法。
- Chen 等(2023). Extending Context Window of Large Language Models via Positional Interpolation —— Meta 的 Llama 2 长上下文论文。
- Ding 等(2024). LongRoPE: Extending LLM Context Window Beyond 2 Million Tokens —— 被 Phi-3-Long 使用、并在「使用它」一节中提到的微软方法。
- HuggingFace Transformers ——
modeling_rope_utils.py—— 每种 RoPE 缩放方案(default、linear、dynamic、YaRN、LongRoPE、Llama-3)的生产级实现。
示意图共 1 张