问题
在 Whisper(OpenAI,Radford 等,2022)之前,最先进的自动语音识别(ASR)意味着 wav2vec 2.0 和 HuBERT——自监督特征提取器加一个微调头。质量高,但数据管道昂贵,且对领域脆弱。多语言语音识别需要为每个语系准备单独模型。
Whisper 押了三个赌注:
- 在一切数据上训练。 从互联网抓取 68 万小时弱标注音频,覆盖 97 种语言。没有干净的学术语料。没有音素标签。
- 单模型多任务。 一个解码器通过任务 token,同时训练转写、翻译、语音活动检测、语种识别和时间戳预测。
- 标准的编码器-解码器 Transformer。 编码器消费 log-mel 频谱图。解码器自回归产生文本 token。没有声码器,没有 CTC,没有 HMM。
结果是:Whisper large-v3 在口音、噪声以及完全没有干净标注数据的语言上都表现稳健。2026 年,它是所有开源语音助手以及大多数商业语音助手的默认语音前端。
概念
第 1 步——重采样并加窗
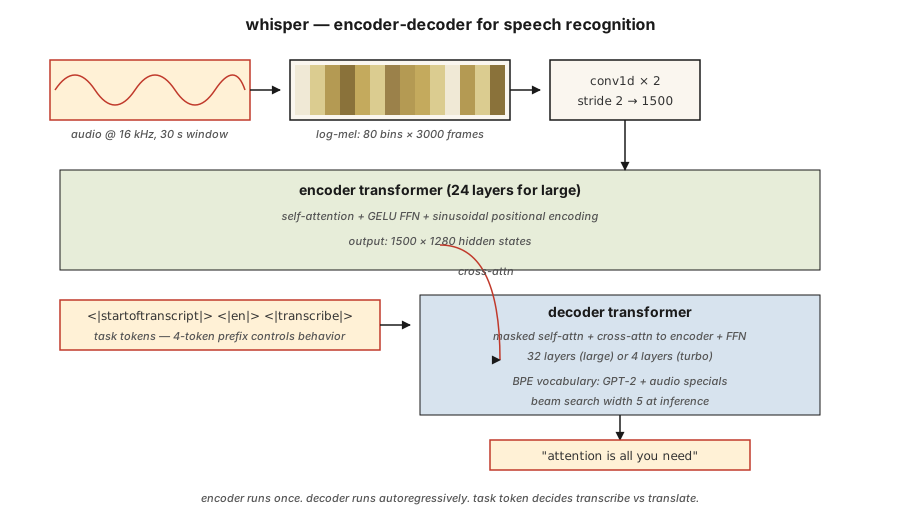
音频为 16 kHz。裁剪或填充到 30 秒。计算 log-mel 频谱图:80 个 mel 频带,10 ms 步长 → 约 3,000 帧 × 80 个特征。这就是 Whisper 眼中的「输入图像」。
第 2 步——卷积主干
两个核为 3、步长为 2 的 Conv1D 层把 3,000 帧降到 1,500 帧。序列长度减半,参数量增加很少。
第 3 步——编码器
在大模型上是 24 层的 Transformer 编码器,处理 1,500 个时间步。正弦位置编码、自注意力、GELU FFN。输出 1,500 × 1,280 的隐藏状态。
第 4 步——解码器
一个 24 层 Transformer 解码器。它自回归地从 BPE 词表中产生 token;该词表是 GPT-2 词表的超集,外加少量音频专用特殊 token。
第 5 步——任务 token
解码器 prompt 以控制 token 开头,告诉模型该做什么:
<|startoftranscript|> <|en|> <|transcribe|> <|0.00|>或者
<|startoftranscript|> <|fr|> <|translate|> <|0.00|>模型就是按这套约定训练的。你用前缀控制任务。这是 2026 年指令微调的等价物,只不过作用于语音。
第 6 步——输出
宽度为 5 的束搜索,外加对数概率阈值。当 <|notimestamps|> token 未出现时,每 0.02 秒音频预测一个时间戳。
Whisper 的规格
| 模型 | 参数 | 层数 | d_model | 头数 | 显存(fp16) |
|---|---|---|---|---|---|
| Tiny | 39M | 4 | 384 | 6 | ~1 GB |
| Base | 74M | 6 | 512 | 8 | ~1 GB |
| Small | 244M | 12 | 768 | 12 | ~2 GB |
| Medium | 769M | 24 | 1024 | 16 | ~5 GB |
| Large | 1550M | 32 | 1280 | 20 | ~10 GB |
| Large-v3 | 1550M | 32 | 1280 | 20 | ~10 GB |
| Large-v3-turbo | 809M | 32 | 1280 | 20 | ~6 GB(4 层解码器) |
Large-v3-turbo(2024)把解码器从 32 层砍到 4 层。解码速度快 8 倍,WER 回退不到 1 个点。解码速度的这一突破,使 Whisper-turbo 成为 2026 年实时语音 Agent 的默认选择。
Whisper 不做什么
- 不做说话人分离(谁在说话)。需要配合 pyannote。
- 原生不支持实时流式——30 秒窗口是固定的。现代封装(
faster-whisper、WhisperX)通过 VAD 加重叠分段拼出流式能力。 - 超过 30 秒的长音频需要外部切块。实践效果不错,因为人类语音转写很少需要长程上下文。
2026 年的格局
| 任务 | 模型 | 备注 |
|---|---|---|
| 英语 ASR | Whisper-turbo、Moonshine | Moonshine 在边缘设备上快 4 倍 |
| 多语种 ASR | Whisper-large-v3 | 97 种语言 |
| 流式 ASR | faster-whisper + VAD | 可以达到 150 ms 延迟目标 |
| TTS | Piper、XTTS-v2、Kokoro | 编码器-解码器模式,但形状类似 Whisper |
| 音频 + 语言 | AudioLM、SeamlessM4T | 文本 token 加音频 token 放在同一个 Transformer 里 |
构建它
见 code/main.py。我们不训练 Whisper——我们构建 log-mel 频谱图管道和任务 token 的 prompt 格式化器。这些才是你在生产里真正会碰到的部分。
第 1 步:合成音频
生成一段 1 秒、440 Hz 的正弦波,采样率 16 kHz。共 16,000 个采样点。
第 2 步:log-mel 频谱图(简化版)
完整的 mel 频谱图需要 FFT。我们做一个简化的分帧加逐帧能量的版本,不依赖 librosa 也能展示整条管道:
pythondef frame_signal(x, frame_size=400, hop=160):
frames = []
for start in range(0, len(x) - frame_size + 1, hop):
frames.append(x[start:start + frame_size])
return frames帧长 25 ms,帧移 10 ms。与 Whisper 的加窗一致。为教学起见,用逐帧能量代替 mel 频带。
第 3 步:填充到 30 秒
Whisper 始终处理 30 秒的块。把频谱图填充(或裁剪)到 3,000 帧。
第 4 步:构造 prompt token
pythondef whisper_prompt(lang="en", task="transcribe", timestamps=True):
tokens = ["<|startoftranscript|>", f"<|{lang}|>", f"<|{task}|>"]
if not timestamps:
tokens.append("<|notimestamps|>")
return tokens任务控制的全部表面就是这些。一个 4 token 的前缀。
使用它
pythonimport whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("meeting.wav", language="en", task="transcribe")
print(result["text"])
print(result["segments"][0]["start"], result["segments"][0]["end"])更快的写法,兼容 OpenAI 接口:
pythonfrom faster_whisper import WhisperModel
model = WhisperModel("large-v3-turbo", compute_type="int8_float16")
segments, info = model.transcribe("meeting.wav", vad_filter=True)
for s in segments:
print(f"{s.start:.2f} - {s.end:.2f}: {s.text}")2026 年什么时候选 Whisper:
- 用单个模型做多语种 ASR。
- 对嘈杂、多样音频的稳健转写。
- 研究或原型阶段的 ASR——最快的起点。
什么时候选别的:
- 边缘超低延迟流式——同等质量下 Moonshine 胜过 Whisper。
- 需要低于 200 ms 的实时对话 AI——用专门的流式 ASR。
- 说话人分离——Whisper 不做这个,加上 pyannote。
交付它
见 outputs/skill-asr-configurator.md。该 skill 为新的语音应用选择 ASR 模型、解码参数和预处理管道。
练习
- 简单。 运行
code/main.py。确认 16 kHz、10 ms 帧移下,1 秒信号的分帧数约为 100 帧;30 秒约为 3,000 帧。 - 中等。 用
numpy.fft构建完整的 log-mel 频谱图。验证 80 个 mel 频带与librosa.feature.melspectrogram(n_mels=80)在数值误差范围内一致。 - 困难。 实现流式推理:把音频切成 10 秒窗口、重叠 2 秒,对每个块运行 Whisper,再合并转写结果。在 5 分钟的播客样本上测量词错误率,与单次整段处理对比。
关键术语
| 术语 | 通俗说法 | 实际含义 |
|---|---|---|
| Mel 频谱图 | 「音频图像」 | 二维表示:一个轴是频率带,另一个轴是时间帧;每个单元格是对数刻度的能量。 |
| Log-mel | 「Whisper 看到的东西」 | 取过对数的 mel 频谱图;近似人耳对响度的感知。 |
| 帧 | 「一个时间切片」 | 25 ms 的采样窗口;以 10 ms 步长重叠。 |
| 任务 token | 「语音的 prompt 前缀」 | 解码器 prompt 中的特殊 token,如 <|transcribe|> / <|translate|>。 |
| 语音活动检测(VAD) | 「找到说话声」 | 在 ASR 之前去掉静音的闸门;大幅降低成本。 |
| CTC | 「Connectionist Temporal Classification」 | 用于免对齐训练的经典 ASR 损失;Whisper 并不使用它。 |
| Whisper-turbo | 「小解码器,完整编码器」 | large-v3 编码器加 4 层解码器;解码快 8 倍。 |
| Faster-whisper | 「生产级封装」 | CTranslate2 重实现;int8 量化;比 OpenAI 参考实现快 4 倍。 |
延伸阅读
- Radford et al. (2022). Robust Speech Recognition via Large-Scale Weak Supervision —— Whisper 论文。
- OpenAI Whisper repo —— 参考代码与模型权重。读一读
whisper/model.py,约 400 行就能从上到下看到 Conv1D 主干、编码器和解码器。 - OpenAI Whisper —
whisper/decoding.py—— 第 5–6 步描述的束搜索与任务 token 逻辑都在这里;500 行,完全可读。 - Baevski et al. (2020). wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations —— 前身方法;在某些场景下仍是 SOTA 特征。
- SYSTRAN/faster-whisper —— 生产级封装,比参考实现快 4 倍。
- Jia et al. (2024). Moonshine: Speech Recognition for Live Transcription and Voice Commands —— 2024 年面向边缘的 ASR,形状类似 Whisper 但更小。
- HuggingFace blog — "Fine-Tune Whisper For Multilingual ASR with 🤗 Transformers" —— 权威微调配方,包含 mel 频谱图预处理器和 token 时间戳处理。
- HuggingFace
modeling_whisper.py—— 完整实现(编码器、解码器、交叉注意力、生成),与本课的架构图一一对应。
示意图共 1 张