问题
你已经读过每一篇论文。你实现了注意力、多头拆分、位置编码、编码器与解码器块、BERT 和 GPT 损失、MoE、KV cache。现在让它们在一个真实任务上协同工作。
项目:在一个字符级语言建模任务上端到端训练一个小型 decoder-only Transformer。它读莎士比亚,生成新的莎士比亚。它小到能在笔记本上 10 分钟内训练完。它也足够正确,换更大的数据集、训练更久就能得到一个真正的 LM。
这是本课程的「nanoGPT」。它并非原创——Karpathy 2023 年的 nanoGPT 教程是每个学生至少写一遍的参考实现。我们沿用它的形态,并围绕本课覆盖的内容重新改装。
概念
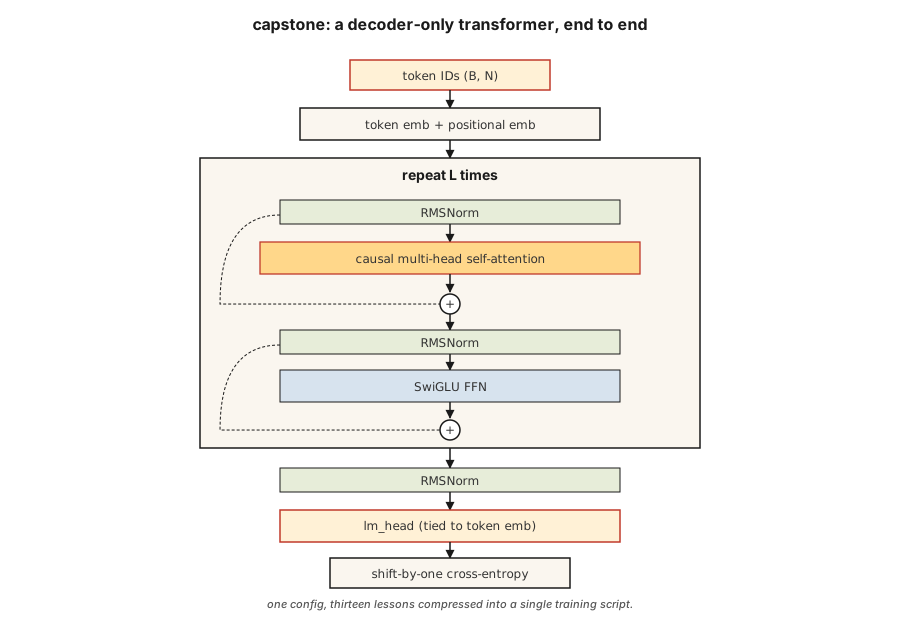
架构,带注释:
input tokens (B, N)
│
▼
token embedding + positional embedding ◀── Lesson 04 (RoPE option)
│
▼
┌──── block × L ────────────────────┐
│ RMSNorm │ ◀── Lesson 05
│ MultiHeadAttention (causal) │ ◀── Lesson 03 + 07 (causal mask)
│ residual │
│ RMSNorm │
│ SwiGLU FFN │ ◀── Lesson 05
│ residual │
└────────────────────────────────── ┘
│
▼
final RMSNorm
│
▼
lm_head (tied to token embedding)
│
▼
logits (B, N, V)
│
▼
shift-by-one cross-entropy ◀── Lesson 07我们交付什么
GPTConfig——集中配置所有超参数。MultiHeadAttention——因果、批处理,可选 Flash 风格路径(PyTorch 的scaled_dot_product_attention)。SwiGLUFFN——现代 FFN。Block——pre-norm、残差包裹的注意力 + FFN。GPT——embedding、堆叠的 block、LM head、generate()。- 训练循环:AdamW、余弦学习率、梯度裁剪。
- 莎士比亚文本上的字符级 tokenizer。
我们不交付什么
- RoPE——在第 04 课中做了概念性实现。这里为了简单使用可学习位置 embedding。练习要求你换成 RoPE。
- 生成时的 KV cache——每个生成步骤都对完整前缀重算注意力。更慢但更简单。练习要求你添加 KV cache。
- Flash Attention——输入匹配时 PyTorch 2.0+ 会自动分派;我们使用
F.scaled_dot_product_attention。 - MoE——每个 block 单个 FFN。你在第 11 课见过 MoE。
目标指标
在 Mac M2 笔记本上,一个 4 层、4 头、d_model=128 的 GPT 在 tinyshakespeare.txt 上训练 2,000 步:
- 训练损失从约 4.2(随机)收敛到约 1.5,耗时约 6 分钟。
- 采样输出看起来像莎士比亚:古语词、换行、像「ROMEO:」这样的专有名词会涌现。
- 验证损失(留出的最后 10% 文本)紧随训练损失;在这个规模/预算下没有过拟合。
构建它
本课使用 PyTorch。安装 torch(CPU 版本即可)。见 code/main.py。脚本处理:
- 缺少
tinyshakespeare.txt时下载(或读取本地副本)。 - 字节级字符 tokenizer。
- 按 90/10 划分训练/验证。
- 在支持的硬件上使用 bf16 autocast 的训练循环。
- 训练完成后采样。
第 1 步:数据
pythontext = open("tinyshakespeare.txt").read()
chars = sorted(set(text))
stoi = {c: i for i, c in enumerate(chars)}
itos = {i: c for c, i in stoi.items()}
encode = lambda s: [stoi[c] for c in s]
decode = lambda xs: "".join(itos[x] for x in xs)65 个唯一字符。极小的词表。4 字节的 vocab_size 就够。没有 BPE,没有 tokenizer 的麻烦。
第 2 步:模型
见 code/main.py。block 是第 05 课教科书式的实现——pre-norm、RMSNorm、SwiGLU、因果 MHA。4/4/128 的参数数量约为 80 万。
第 3 步:训练循环
取一个长度为 256 的 token 窗口随机 batch。前向。shift-by-one 交叉熵。反向。AdamW 更新。记录。重复。
pythonfor step in range(max_steps):
x, y = get_batch("train")
logits = model(x)
loss = F.cross_entropy(logits.view(-1, vocab_size), y.view(-1))
loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
opt.step()
opt.zero_grad()第 4 步:采样
给定 prompt,反复前向、从 top-p logit 采样、追加、继续。500 个 token 后停止。
第 5 步:读输出
2,000 步后:
ROMEO:
Away and mild will not thy friend, that thou shalt wit:
The chief that well shame and hath been his friends,
...不是莎士比亚。但有莎士比亚的形状。用约 80 万参数和笔记本上的 6 分钟换取,这是明确的胜利。
使用它
这个项目是一个参考架构。要把它推向真实应用,有三条扩展路径:
- 换 tokenizer。 使用 BPE(例如
tiktoken.get_encoding("cl100k_base"))。词表从 65 跳到约 50,000。模型容量需要相应扩大来补偿。 - 在更大语料上训练。 使用
OpenWebText或fineweb-edu(Hugging Face)。对 125M 参数的 GPT,单张 A100 上 10B token 约需 24 小时。 - 加入 RoPE + KV cache + Flash Attention。 下面的练习会带你逐项完成。
最终会得到一个生成流畅英语的 125M 参数 GPT。不是前沿模型。但同一条代码路径——只是更大——正是 Karpathy、EleutherAI 和 Allen Institute 在 2026 年训练研究 checkpoint 时所用的。
交付它
见 outputs/skill-transformer-review.md。该技能按照前 13 课的全部要点,审查一个从零实现的 Transformer 是否正确。
练习
- 简单。 运行
code/main.py。确认训练好的模型最后一步验证损失低于 2.0。把max_steps从 2,000 改为 5,000——验证损失会继续改善吗? - 中等。 用 RoPE 替换可学习位置 embedding。在
MultiHeadAttention内对 Q 和 K 施加旋转。训练并确认验证损失至少一样低。 - 中等。 在采样循环中实现 KV cache。分别在有缓存和无缓存时生成 500 个 token。笔记本上的实际耗时应改善 5–20 倍。
- 困难。 给模型加第二个 head,预测下下个 token(MTP——来自 DeepSeek-V3 的多 token 预测)。联合训练。有帮助吗?
- 困难。 把每个 block 的单个 FFN 换成 4 专家 MoE。Router + top-2 路由。看看在相同激活参数下验证损失如何变化。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| nanoGPT | 「Karpathy 的教程仓库」 | 极简 decoder-only Transformer 训练代码,约 300 行;经典参考实现。 |
| tinyshakespeare | 「标准玩具语料」 | 约 1.1 MB 文本;2015 年以来每个字符级 LM 教程都用它。 |
| 绑定 embedding(Tied embeddings) | 「共享输入/输出矩阵」 | LM head 权重 = token embedding 矩阵的转置;省参数、提质量。 |
| bf16 autocast | 「训练精度技巧」 | 前向/反向用 bf16,优化器状态保持 fp32;2021 年以来的标准做法。 |
| 梯度裁剪 | 「阻止尖峰」 | 将全局梯度范数上限设为 1.0;防止训练爆炸。 |
| 余弦学习率调度 | 「2020+ 的默认」 | 学习率先线性上升(warmup),再按余弦形状衰减到峰值的 10%。 |
| MFU | 「模型 FLOP 利用率」 | 实际达到的 FLOPs / 理论峰值;2026 年 40% 稠密、30% MoE 算很强。 |
| 验证损失 | 「留出损失」 | 模型从未见过的数据上的交叉熵;过拟合探测器。 |
延伸阅读
- The Annotated Transformer (Harvard NLP) —— 经典的带注释实现。
示意图共 1 张