问题
2020 年之前,计算机视觉就意味着卷积。ImageNet、COCO 以及各项检测基准上的每一个 SOTA 都用 CNN 骨干。Transformer 是语言的专利。
Dosovitskiy 等(2020)——「An Image is Worth 16x16 Words」——证明可以完全去掉卷积。把图像切成固定大小的 patch,将每个 patch 线性投影成一个 embedding,把序列喂给原版 Transformer 编码器。在足够规模下(ImageNet-21k 预训练或更大),ViT 追平或超过基于 ResNet 的模型。
ViT 开启了 2026 年一个更广泛的模式:一套架构,多种模态。Whisper 把音频 token 化,ViT 把图像 token 化,机器人用动作 token,视频用像素 token。Transformer 不在乎——喂给它序列,它就能学。
到 2026 年,ViT 及其后代(DeiT、Swin、DINOv2、ViT-22B、SAM 3)占据了视觉的大部分版图。CNN 仍在边缘设备和延迟敏感任务上领先。除此之外的场景,技术栈里总有 ViT 的身影。
概念
第 1 步——切分 patch
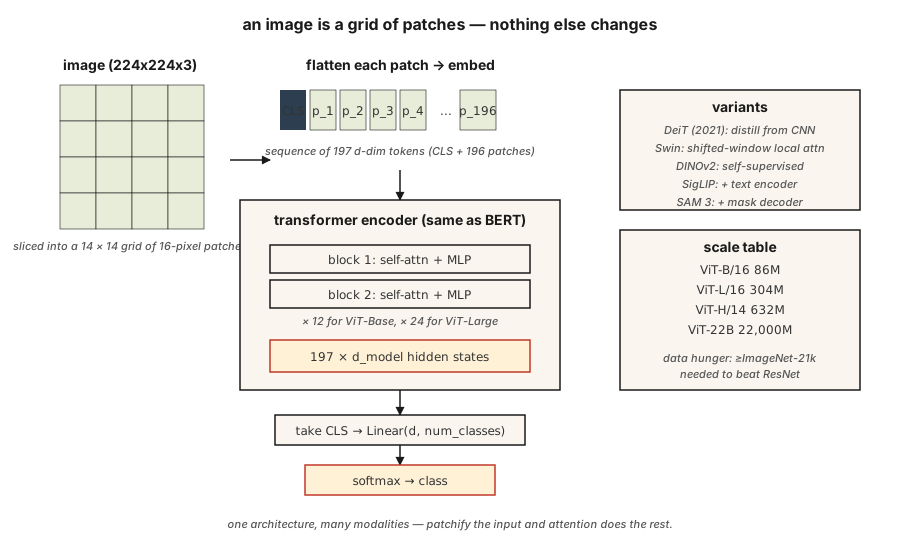
把 H × W × C 的图像拆成 N × (P·P·C) 的展平 patch 序列。典型设置:224 × 224 图像、16 × 16 patch → 196 个 patch,每个 768 个数值。
image (224, 224, 3) → 14 × 14 grid of 16x16x3 patches → 196 vectors of length 768patch 大小是调节杠杆。patch 越小 = token 越多、分辨率越高、注意力成本按平方增长。patch 越大 = 越粗糙、越便宜。
第 2 步——线性嵌入
用一个可学习矩阵把每个展平 patch 投影到 d_model。等价于核大小为 P、步长为 P 的卷积。在 PyTorch 里就是 nn.Conv2d(C, d_model, kernel_size=P, stride=P)——两行实现。
第 3 步——前置 [CLS] token,加入位置嵌入
- 前置一个可学习的
[CLS]token。它的最终隐藏状态就是用于分类的图像表示。 - 加入可学习的位置嵌入(初代 ViT)或二维正弦位置编码(后续变体)。
- 2024 年起,RoPE 扩展到二维位置,有时甚至不再需要显式位置嵌入。
第 4 步——标准 Transformer 编码器
堆叠 L 个 LayerNorm → Self-Attention → + → LayerNorm → MLP → + 块。与 BERT 完全相同。没有任何视觉专用的层。这正是论文在教学上的点睛之笔。
第 5 步——输出头
分类:取 [CLS] 隐藏状态 → 线性层 → softmax。对 DINOv2 或 SAM,丢弃 [CLS],直接使用 patch embedding。
重要的变体
| 模型 | 年份 | 变化 |
|---|---|---|
| ViT | 2020 | 初代。固定 patch 大小,全全局注意力。 |
| DeiT | 2021 | 蒸馏;仅在 ImageNet-1k 上即可训练。 |
| Swin | 2021 | 分层结构加移位窗口。修复了亚二次方的成本。 |
| DINOv2 | 2023 | 自监督(无标签)。最好的通用视觉特征。 |
| ViT-22B | 2023 | 220 亿参数;缩放定律依然适用。 |
| SigLIP | 2023 | ViT 加语言端配对,sigmoid 对比损失。 |
| SAM 3 | 2025 | 分割一切;ViT-Large 加可提示的掩码解码器。 |
为什么花了这么久
ViT 需要海量数据才能追平 CNN,因为它不具备 CNN 的任何归纳偏置(平移不变性、局部性)。没有超过 1 亿张标注图像或强自监督预训练,同等算力下 CNN 仍然胜出。DeiT 在 2021 年用蒸馏技巧缓解了这一点;DINOv2 在 2023 年用自监督永久解决了它。
构建它
见 code/main.py。纯标准库的切 patch、线性嵌入和健全性检查。不训练——任何现实规模的 ViT 都需要 PyTorch 和数小时 GPU 时间。
第 1 步:假图像
一张 24 × 24 的 RGB 图像,表示为若干行 (R, G, B) 元组。使用 6×6 的 patch → 16 个 patch,每个 patch 是 108 维的嵌入向量。
第 2 步:切分 patch
pythondef patchify(image, P):
H = len(image)
W = len(image[0])
patches = []
for i in range(0, H, P):
for j in range(0, W, P):
patch = []
for di in range(P):
for dj in range(P):
patch.extend(image[i + di][j + dj])
patches.append(patch)
return patches光栅顺序:按行优先遍历网格。每个 ViT 都采用这种顺序。
第 3 步:线性嵌入
将每个展平 patch 乘以一个随机的 (patch_flat_size, d_model) 矩阵。验证前置 [CLS] 之后输出形状为 (N_patches + 1, d_model)。
第 4 步:计算一个真实 ViT 的参数量
打印 ViT-Base 的参数量:12 层、12 头、d=768、patch=16。与 ResNet-50(约 2500 万)对比。ViT-Base 约 8600 万。ViT-Large 约 3.07 亿。ViT-Huge 约 6.32 亿。
使用它
pythonfrom transformers import ViTImageProcessor, ViTModel
import torch
from PIL import Image
processor = ViTImageProcessor.from_pretrained("google/vit-base-patch16-224-in21k")
model = ViTModel.from_pretrained("google/vit-base-patch16-224-in21k")
img = Image.open("cat.jpg")
inputs = processor(img, return_tensors="pt")
out = model(**inputs).last_hidden_state # (1, 197, 768): [CLS] + 196 patches
cls_emb = out[:, 0] # image representationDINOv2 embedding 是 2026 年图像特征的默认选择。 冻结骨干,训练一个小头。适用于分类、检索、检测、描述生成。Meta 的 DINOv2 checkpoint 在每个非文本视觉任务上都优于 CLIP。
patch 大小怎么选。 小模型用 16×16(ViT-B/16)。稠密预测(分割)用 8×8 或 14×14(SAM、DINOv2)。超大模型用 14×14。
交付它
见 outputs/skill-vit-configurator.md。该 skill 依据数据集规模、分辨率和算力预算,为新视觉任务选择 ViT 变体和 patch 大小。
练习
- 简单。 运行
code/main.py。验证 patch 数量等于(H/P) * (W/P),展平 patch 的维度等于P*P*C。 - 中等。 实现二维正弦位置嵌入——为每个 patch 的
row和col各生成一份独立的正弦编码,再拼接起来。把它们喂进一个小型 PyTorch ViT,在 CIFAR-10 上与可学习位置嵌入比较准确率。 - 困难。 构建一个 3 层 ViT(PyTorch),用 4×4 patch 在 1,000 张 MNIST 图像上训练。测量测试准确率。然后对同样的 1,000 张图像加入 DINOv2 式预训练(简化版:只训练编码器从被掩码的 patch 预测 patch embedding)。准确率有提升吗?
关键术语
| 术语 | 通俗说法 | 实际含义 |
|---|---|---|
| Patch | 「视觉 Transformer 的 token」 | 图像中 P × P × C 区域像素值的展平向量。 |
| 切分 patch(patchify) | 「切块加拉平」 | 把图像切成互不重叠的 patch,每个展平为向量。 |
[CLS] token | 「图像摘要」 | 前置的可学习 token;它的最终嵌入就是图像表示。 |
| 归纳偏置 | 「模型预设了什么」 | ViT 的先验比 CNN 少;需要更多数据来弥补差距。 |
| DINOv2 | 「自监督 ViT」 | 不使用标签训练,靠图像增强加动量教师模型。2026 年最好的通用图像特征。 |
| SigLIP | 「CLIP 的后继者」 | ViT 加文本编码器,用 sigmoid 对比损失训练;同等算力下优于 CLIP。 |
| Swin | 「窗口化 ViT」 | 带局部注意力和移位窗口的分层 ViT;亚二次方复杂度。 |
| 寄存器 token | 「2023 年的技巧」 | 几个额外的可学习 token,用来吸收注意力汇点;可改善 DINOv2 特征。 |
延伸阅读
- Dosovitskiy et al. (2020). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale —— ViT 论文。
- Touvron et al. (2021). Training data-efficient image transformers & distillation through attention —— DeiT。
- Liu et al. (2021). Swin Transformer: Hierarchical Vision Transformer using Shifted Windows —— Swin。
- Oquab et al. (2023). DINOv2: Learning Robust Visual Features without Supervision —— DINOv2。
- Darcet et al. (2023). Vision Transformers Need Registers —— 为 DINOv2 引入寄存器 token 的修复方案。
示意图共 1 张