问题
单个注意力层是特征提取器,不是模型。每层一次矩阵乘法不足以承载语言。你需要深度——而深度若没有正确的管道就会崩坏。
2017 年 Vaswani 的论文打包了六个设计决策,把一个注意力层变成了可堆叠的模块。此后每个 Transformer——仅编码器(BERT)、仅解码器(GPT)、编码器-解码器(T5)——都继承同一套骨架。2026 年模块本身已被改良(RMSNorm、SwiGLU、pre-norm、RoPE),但骨架完全相同。
本课讲骨架。后续课程将其特化——06 讲编码器、07 讲解码器、08 讲编码器-解码器。
概念
六个部件
- Embedding + 位置信号。 Token → 向量。位置通过 RoPE(现代)或正弦(经典)注入。
- 自注意力。 每个位置关注所有其他位置。解码器中带掩码。
- 前馈网络(FFN)。 逐位置的两层 MLP:
W_2 · activation(W_1 · x)。默认扩展比 4×。 - 残差连接。
x + sublayer(x)。没有它,超过约 6 层梯度就会消失。 - 层归一化。
LayerNorm或RMSNorm(现代)。稳定残差流。 - 交叉注意力(仅解码器)。 Query 来自解码器,key 和 value 来自编码器输出。
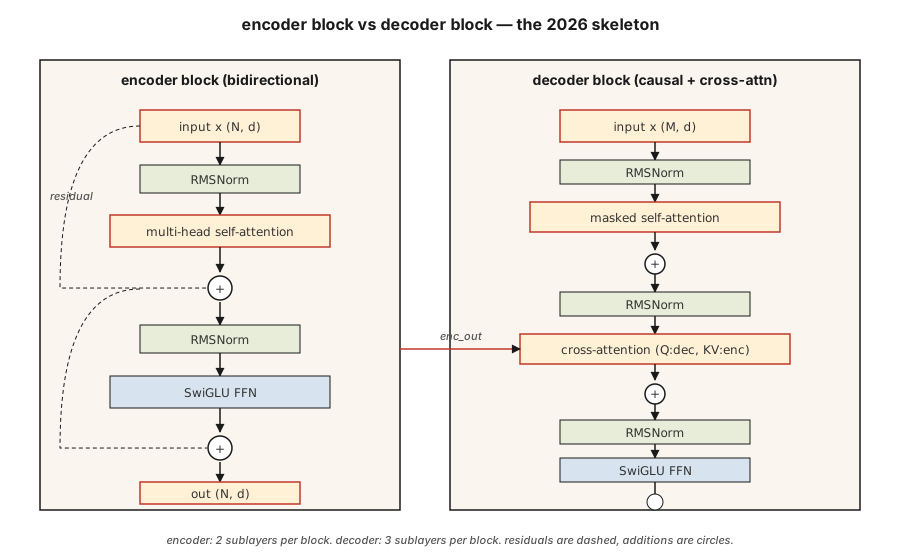
观察一个向量流经单个模块:注意力在位置之间混合信息,残差把它向前携带,FFN 对它做变换,归一化让整条流保持稳定。
编码器模块(BERT、T5 编码器使用)
x → LN → MHA(self) → + → LN → FFN → + → out
^ ^
| |
└── residual ──┘编码器是双向的。没有掩码。所有位置都能看到所有位置。
解码器模块(GPT、T5 解码器使用)
x → LN → MHA(masked self) → + → LN → MHA(cross to encoder) → + → LN → FFN → + → out解码器每个模块有三个子层。中间那个——交叉注意力——是信息从编码器流向解码器的唯一地方。在纯仅解码器架构(GPT)中,交叉注意力被省略,只剩带掩码的自注意力 + FFN。
Pre-norm 与 post-norm
原始论文:x + sublayer(LN(x)) 对比 LN(x + sublayer(x))。Post-norm 在 2019 年前后失宠——没有细致的 warmup,很难训练得很深。Pre-norm(LN 在子层之前)是 2026 年的默认:Llama、Qwen、GPT-3+、Mistral 都在用。
2026 年的现代化模块
Vaswani 2017 交付的是 LayerNorm + ReLU。现代技术栈把两者都替换了。生产模块实际长这样:
| 组件 | 2017 | 2026 |
|---|---|---|
| 归一化 | LayerNorm | RMSNorm |
| FFN 激活 | ReLU | SwiGLU |
| FFN 扩展比 | 4× | 2.6×(SwiGLU 用三个矩阵,总参数量相当) |
| 位置 | 正弦绝对位置 | RoPE |
| 注意力 | 完整 MHA | GQA(或 MLA) |
| 偏置项 | 有 | 无 |
RMSNorm 去掉了 LayerNorm 的均值中心化(少一次减法),节省计算,且经验上至少同样稳定。SwiGLU(Swish(W1 x) ⊙ W3 x)在 Llama、PaLM 和 Qwen 的论文中始终比 ReLU/GELU FFN 好约 0.5 个点的 ppl。
参数量
对于一个 d_model = d、FFN 扩展比为 r 的模块:
- MHA:
4 · d²(Q、K、V、O 投影) - FFN(SwiGLU):
3 · d · (r · d)≈3rd² - 归一化:可忽略
在 d = 4096, r = 2.6, layers = 32(大致相当于 Llama 3 8B)时,总计:32 · (4·4096² + 3·2.6·4096²) ≈ 32 · (16 + 32) M = ~1.5B parameters per layer × 32 ≈ 7B(加上 embedding 和输出头)。与公开的数字吻合。
构建它
第 1 步:基础组件
使用第 03 课的小型 Matrix 类(为独立性已复制到本文件):
layer_norm(x, eps=1e-5)—— 减去均值,除以标准差。rms_norm(x, eps=1e-6)—— 除以 RMS。不减均值。gelu(x)和silu(x) * W3 x(SwiGLU)。ffn_swiglu(x, W1, W2, W3)。encoder_block(x, params)和decoder_block(x, enc_out, params)。
完整接线见 code/main.py。
第 2 步:接一个 2 层编码器和 2 层解码器
把它们堆叠起来。把编码器输出传入解码器的每一个交叉注意力。在输出投影之前加一个最终的 LN。
pythondef encode(tokens, params):
x = embed(tokens, params.emb) + sinusoidal(len(tokens), params.d)
for block in params.encoder_blocks:
x = encoder_block(x, block)
return x
def decode(target_tokens, encoder_out, params):
x = embed(target_tokens, params.emb) + sinusoidal(len(target_tokens), params.d)
for block in params.decoder_blocks:
x = decoder_block(x, encoder_out, block)
return x第 3 步:在玩具例子上跑前向
喂入一个 6 token 的源序列和一个 5 token 的目标序列。验证输出形状是 (5, vocab)。不训练——本课讲的是架构,不是损失。
第 4 步:换成 RMSNorm + SwiGLU
把 LayerNorm 和 ReLU-FFN 替换为 RMSNorm 和 SwiGLU。确认形状仍然匹配。这就是 2026 年的现代化:替换一个函数即可。
使用它
PyTorch/TF 的参考实现:nn.TransformerEncoderLayer、nn.TransformerDecoderLayer。但 2026 年多数生产代码自己写模块,因为:
- Flash Attention 是在注意力内部调用的,而不是通过
nn.MultiheadAttention。 - GQA / MLA 不在标准库参考实现中。
- RoPE、RMSNorm、SwiGLU 不是 PyTorch 的默认选项。
HF transformers 有干净的参考模块值得一读:modeling_llama.py 是 2026 年规范的仅解码器模块。约 500 行,值得完整走一遍。
编码器 vs 解码器 vs 编码器-解码器——如何选择:
| 需求 | 选择 | 例子 |
|---|---|---|
| 分类、embedding、文本 QA | 仅编码器 | BERT、DeBERTa、ModernBERT |
| 文本生成、对话、代码、推理 | 仅解码器 | GPT、Llama、Claude、Qwen |
| 结构化输入 → 结构化输出(翻译、摘要) | 编码器-解码器 | T5、BART、Whisper |
仅解码器赢得了语言,因为它扩展得最干净,且同时处理理解与生成。当输入有明确的「源序列」身份(翻译、语音识别、结构化任务)时,编码器-解码器仍然最佳。
交付它
见 outputs/skill-transformer-block-reviewer.md。这个 skill 对照 2026 年的默认配置审查新的 Transformer 模块实现,并标出缺失的部分(pre-norm、RoPE、RMSNorm、GQA、FFN 扩展比)。
练习
- 简单。 计算你的
encoder_block在d_model=512, n_heads=8, ffn_expansion=4, swiglu=True下的参数量。实现该模块并用sum(p.numel() for p in block.parameters())验证。 - 中等。 从 post-norm 切换到 pre-norm。分别初始化两者,在随机输入上测量堆叠 12 层后的激活范数。Post-norm 的激活应当爆炸;pre-norm 的应当保持有界。
- 困难。 在一个玩具复制任务(反向复制
x)上实现 4 层编码器-解码器。训练 100 步。报告损失。换成 RMSNorm + SwiGLU + RoPE——损失会下降吗?
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Block | 「一个 Transformer 层」 | 由 norm + attention + norm + FFN 组成、外包残差连接的堆叠。 |
| Residual | 「跳跃连接」 | x + f(x) 输出;使梯度能流过深堆叠。 |
| Pre-norm | 「先归一化,而不是后」 | 现代做法:x + sublayer(LN(x))。无需繁琐 warmup 也能训练得更深。 |
| RMSNorm | 「没有均值的 LayerNorm」 | 除以 RMS;少一个运算,经验稳定性相同。 |
| SwiGLU | 「大家都换用的 FFN」 | Swish(W1 x) ⊙ W3 x → W2。在 LM ppl 上胜过 ReLU/GELU。 |
| Cross-attention | 「解码器看编码器的方式」 | Q 来自解码器、K/V 来自编码器输出的 MHA。 |
| FFN expansion | 「中间 MLP 有多宽」 | 隐藏大小与 d_model 的比值,通常为 4(LayerNorm)或 2.6(SwiGLU)。 |
| Bias-free | 「去掉 +b 项」 | 现代技术栈在线性层省略偏置;ppl 略有改善,模型更小。 |
延伸阅读
- Vaswani 等(2017). Attention Is All You Need —— 原始模块规范。
- Xiong 等(2020). On Layer Normalization in the Transformer Architecture —— 为什么深层网络中 pre-norm 胜过 post-norm。
- Zhang、Sennrich(2019). Root Mean Square Layer Normalization —— RMSNorm。
- Shazeer(2020). GLU Variants Improve Transformer —— SwiGLU 论文。
- HuggingFace
modeling_llama.py—— 2026 年规范的仅解码器模块。
示意图共 1 张