问题
游戏拥有 RL 想要的一切。干净的奖励(赢/输)。无限的回合(自博弈重置)。完美的仿真(游戏就是仿真器)。离散或小的连续动作空间。强制对抗稳健性的多 Agent 结构。
而且每一个重大 RL 突破都是在游戏上测试的。TD-Gammon(双陆棋,1992)。Atari-DQN(2013)。AlphaGo(2016)。AlphaZero(2017)。OpenAI Five(Dota 2,2019)。AlphaStar(StarCraft II,2019)。MuZero(学习到的模型,2019)。AlphaTensor(矩阵乘法,2022)。AlphaDev(排序算法,2023)。DeepSeek-R1(数学推理,2025)——游戏 RL 技术在文本上有效的最新证明。
这个收尾课通过一个统一的透镜来考察三种里程碑架构——AlphaZero、MuZero 和 GRPO:自博弈 + 搜索 + 策略改进。每一个都推广了前一个;尤其是 GRPO,它是 AlphaZero 配方在 LLM 推理上的应用,token 是动作,数学验证是胜利信号。
概念
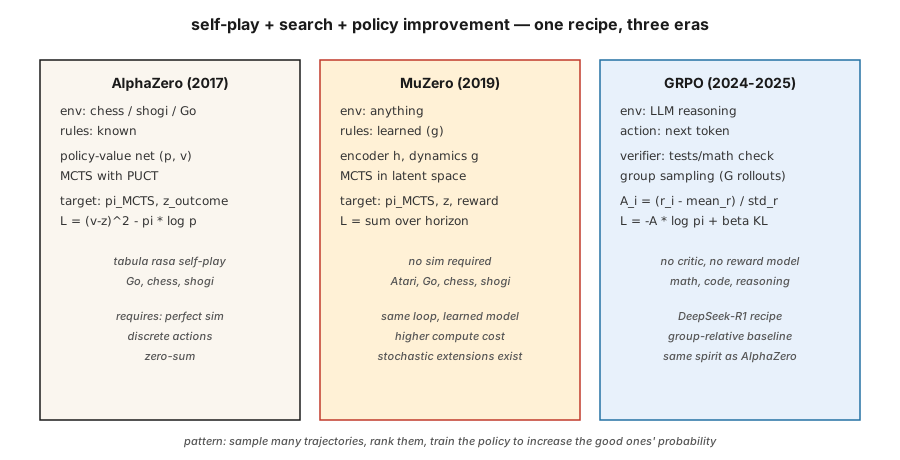
统一的循环。
while True:
trajectory = self_play(current_policy, search) # play game against self
policy_target = search.improved_policy(trajectory) # search improves raw policy
policy_net.update(policy_target, value_target) # supervised on search outputAlphaZero(2017)。 Silver 等人。给定一个规则已知的游戏(国际象棋、将棋、围棋):
- 策略-价值网络:一个塔 f_\theta(s) \to (p, v)。p 是合法着法的先验。v 是期望游戏结果。
- 蒙特卡洛树搜索(MCTS):每一步,展开一棵可能后续的树。用 (p, v) 作先验 + 自举。按 UCB(PUCT)选择节点:a^{\ast} = \arg\max_a Q(s, a) + c \cdot p(a \mid s) \cdot \sqrt{N(s)} / (1 + N(s, a))。
- 自博弈:Agent 对 Agent 下棋。在第 t 步,MCTS 的访问分布 \pi_t 成为策略训练目标。
- 损失:L = (v - z)^2 - \pi \cdot \log p + c \cdot \lVert \theta \rVert^2。z 是游戏结果(+1 / 0 / -1)。
零人类知识。零手工启发式。一个配方,在每种游戏几千万局自博弈之后,精通了国际象棋、将棋和围棋。
MuZero(2019)。 Schrittwieser 等人。去掉了「规则已知」这一要求。
- 不用固定环境,而是学一个隐动力学模型 (h, g, f):
- h(s):把观测编码成隐状态。
- g(s_{\text{latent}}, a):预测下一个隐状态 + 奖励。
- f(s_{\text{latent}}):预测策略先验 + 价值。
- MCTS 在学习到的隐空间里运行。同样的搜索,同样的训练循环。
- 适用于围棋、国际象棋、将棋以及 Atari——一个算法,不需要规则知识。
随机 MuZero(2022)。 加入随机动力学和机会节点;扩展到双陆棋一类游戏。
Muesli、Gumbel MuZero(2022-2024)。 在样本效率和确定性搜索上的改进。
GRPO(2024-2025)。 DeepSeek-R1 配方。同样 AlphaZero 形状的循环,应用到语言模型推理:
- 「游戏」:回答一道数学 / 编程 / 推理题。「胜利」= 验证器(测试用例通过、数值答案匹配)返回 1。
- 策略:LLM。动作:token。状态:提示 + 到目前为止的回复。
- 没有评论家(PPO 式的 V_\phi)。取而代之,对每个提示从策略采样 G 个补全。给每个计算奖励。用组相对优势 A_i = (r_i - \text{mean}_r) / \text{std}_r 作为 REINFORCE 式更新的信号。
- 对参考策略的 KL 惩罚,防止漂移(像 RLHF 那样)。
- 完整损失:
L_{\text{GRPO}}(\theta) = -\mathbb E_{q, \lbrace o_i \rbrace} \left[ \frac{1}{G} \sum_i A_i \cdot \log \pi_\theta(o_i \mid q) \right] + \beta \cdot \mathrm{KL}(\pi_\theta \Vert \pi_{\text{ref}})
没有奖励模型,没有评论家,没有 MCTS。组相对基线一举替代了这三者。在推理基准上达到或超过 PPO-RLHF 的质量,算力只占一小部分。
完整的 R1 配方。 DeepSeek-R1(DeepSeek 2025)一篇论文里是两个模型:
- R1-Zero。 从 DeepSeek-V3 基础模型开始。不做 SFT。直接用两个奖励分量应用 GRPO:准确率奖励(基于规则——最终答案能否解析出正确数字 / 代码能否通过单元测试)和格式奖励(补全是否把思维链包在
<think>…</think>标签里)。数千步之后,平均回复长度从约 100 增长到约 10,000 token,数学基准分数攀升到接近 o1-preview 的水平。模型从零学会了推理。缺点:它的思维链常常难以阅读、中英混杂、缺少风格打磨。 - R1。 用四阶段 pipeline 修复 R1-Zero 的可读性问题:
1. 冷启动 SFT。 收集几千条格式干净的长 CoT 示范。在它们上面监督微调基础模型。这给出一个可读的起点。
2. 面向推理的 GRPO。 应用 GRPO,使用准确率+格式奖励,外加语言一致性奖励以防代码切换。
3. 拒绝采样 + 第二轮 SFT。 从 RL checkpoint 采样约 60 万条推理轨迹,只保留最终答案正确且 CoT 可读的,再与约 20 万条非推理 SFT 示例(写作、问答、自我认知)合并。再次微调基础模型。
4. 全谱 GRPO。 再来一轮 RL,覆盖推理(基于规则的奖励)和通用对齐(基于偏好的有帮助/无害奖励)。
结果在开放权重下于 AIME 和 MATH-500 上匹敌 o1,而且小到可以蒸馏。同一篇论文还发布了六个蒸馏稠密模型(Qwen-1.5B 到 Llama-70B),方法是在 R1 的推理轨迹上做 SFT——学生端不用 RL。蒸馏一个强 RL 教师,在学生规模上始终胜过从零做 RL。
为什么推理用 GRPO 而不是 PPO。 DeepSeekMath 论文(2024 年 2 月)给出三个理由:(1) 不需要训练价值网络,内存减半;(2) 组基线天然处理推理任务产生的稀疏轨迹末端奖励;(3) 按提示归一化让优势在难度天差地别的问题之间可比,而 PPO 的单一评论家做不到。
无搜索 vs 基于搜索。 游戏已经分叉:
- 长时程完美信息游戏(围棋、国际象棋):仍然基于搜索。AlphaZero / MuZero 主导。
- LLM 推理:生产中还没有 MCTS;对完整 rollout 用 GRPO,推理算力用 best-of-N。过程奖励模型(PRM)暗示步骤级搜索可能会被加回来。
构建它
code/main.py 里的代码实现了缩小版 GRPO——一个带多组样本的 bandit。算法与 LLM 上相同;只是策略和环境更简单。它教的是损失和组相对优势,这是 2025 年的创新。
第 1 步:极小的验证器环境
pythonQUESTIONS = [
{"prompt": "q1", "correct": 3},
{"prompt": "q2", "correct": 1},
]
def verify(prompt_idx, answer_token):
return 1.0 if answer_token == QUESTIONS[prompt_idx]["correct"] else 0.0真实 GRPO 里,验证器跑单元测试或检查数学等式。
第 2 步:策略:每个提示上 K 个答案 token 的 softmax
pythondef policy_probs(theta, p_idx):
return softmax(theta[p_idx])等价于 LLM 以提示为条件的最后一层输出。
第 3 步:组采样与组相对优势
pythondef grpo_step(theta, p_idx, G=8, beta=0.01, lr=0.1, rng=None):
probs = policy_probs(theta, p_idx)
samples = [sample(probs, rng) for _ in range(G)]
rewards = [verify(p_idx, s) for s in samples]
mean_r = sum(rewards) / G
std_r = stddev(rewards) + 1e-8
advs = [(r - mean_r) / std_r for r in rewards]
for a, A in zip(samples, advs):
grad = onehot(a) - probs
for i in range(len(probs)):
theta[p_idx][i] += lr * A * grad[i]
# KL penalty: pull theta toward reference
for i in range(len(probs)):
theta[p_idx][i] -= beta * (theta[p_idx][i] - reference[p_idx][i])组相对优势是 2024 年 DeepSeek 的技巧。不需要评论家。「基线」是组均值,归一化用组标准差。
第 4 步:与 REINFORCE 基线对比(无价值函数)
同样的设置,同样的算力,朴素 REINFORCE。GRPO 收敛得更快、更稳定。
第 5 步:观察熵和 KL
与 RLHF 相同的诊断:对参考的平均 KL、策略熵、奖励随时间的变化。这些稳定下来,训练就完成了。
常见陷阱
- 通过验证器钻空子实现的奖励作弊。 GRPO 继承了 RLHF 的风险:如果验证器有错或可被利用,LLM 就会找到漏洞。稳健的验证器(多个测试用例、形式化证明)很重要。
- 组太小。 组基线的方差按 1/\sqrt{G} 变化。低于 G = 4,优势信号噪声很大;标准选择是 G = 8 到 64。
- 长度偏差。 不同长度的 LLM 补全有不同的对数概率。按 token 数归一化,或用序列级对数概率,或截断到最大长度。
- 纯自博弈循环。 AlphaZero 式的训练在一般和游戏上可能卡在支配循环里。用多样对手池缓解(联赛训练,第 10 课)。
- 搜索-策略不匹配。 AlphaZero 训练策略去模仿搜索输出。如果策略网络太小,表示不了搜索的分布,训练就会停滞。
- 算力下限。 MuZero / AlphaZero 需要海量算力。单次消融常常要几百 GPU 小时。为了学习,有微型演示(例如 Connect Four 上的 AlphaZero)。
- 验证器覆盖不足。 对 buggy 解也能通过的单元测试,会强化 bug。设计能抓住边界情况的验证器。
使用它
2026 年游戏 RL 格局,按领域:
| 领域 | 主导方法 |
|---|---|
| 双人零和棋类(围棋、国际象棋、将棋) | AlphaZero / MuZero / KataGo |
| 不完全信息纸牌游戏(扑克) | CFR + 深度学习(DeepStack、Libratus、Pluribus) |
| Atari / 像素游戏 | Muesli / MuZero / IMPALA-PPO |
| 大型多人策略(Dota、StarCraft) | PPO + 自博弈 + 联赛(OpenAI Five、AlphaStar) |
| LLM 数学/代码推理 | GRPO(DeepSeek-R1、Qwen-RL、开放复现) |
| LLM 对齐 | DPO / RLHF-PPO(不用 GRPO;验证信号是偏好而非可验证) |
| 机器人 | PPO + DR(不是游戏 RL,但用同样的策略梯度工具) |
| 组合问题 | AlphaZero 变体(AlphaTensor、AlphaDev) |
这套配方——自博弈、搜索增强的改进、策略蒸馏——横跨文本、像素和物理控制。GRPO 是最年轻的实例;还会有更多。
交付它
保存为 outputs/skill-game-rl-designer.md:
markdown---
name: game-rl-designer
description: Design a game-RL or reasoning-RL training pipeline (AlphaZero / MuZero / GRPO) for a given domain.
version: 1.0.0
phase: 9
lesson: 12
tags: [rl, alphazero, muzero, grpo, self-play]
---
Given a target (perfect-info game / imperfect-info / Atari / LLM reasoning / combinatorial), output:
1. Environment fit. Known rules? Markov? Stochastic? Multi-agent? Informs AlphaZero vs MuZero vs GRPO.
2. Search strategy. MCTS (PUCT with learned prior), Gumbel-sampled, best-of-N, or none.
3. Self-play plan. Symmetric self-play / league / offline data / verifier-generated.
4. Target signal. Game outcome / verifier reward / preference / learned model. Include robustness plan.
5. Diagnostics. Win rate vs baseline, ELO curve, verifier pass rate, KL to reference.
Refuse AlphaZero on imperfect-info games (route to CFR). Refuse GRPO without a trusted verifier. Refuse any game-RL pipeline without a fixed baseline opponent set (self-play ELO is uncalibrated otherwise).练习
- 简单。 实现
code/main.py里的 GRPO bandit。在 2 个提示 × 每个 4 个答案 token 上训练。用 G=8 在不到 1,000 次更新内收敛。 - 中等。 接入 PPO(裁剪版)和原版 REINFORCE。在同一个 bandit 上对比样本效率和奖励方差。
- 困难。 扩展成长度 2 的「推理链」:Agent 发出两个 token,验证器给这一对打分。测量 GRPO 如何处理跨两步序列的信用分配。(提示:按完整序列计算组优势,再传播到两个 token 位置。)
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| MCTS | "带学习网络的树搜索" | 蒙特卡洛树搜索;用学到的 (p, v) 先验做 UCB1/PUCT 选择。 |
| AlphaZero | "自博弈 + MCTS" | 训练策略-价值网络去匹配 MCTS 访问和游戏结果。 |
| MuZero | "有学习模型的 AlphaZero" | 同样的循环,但通过学到的动力学在隐空间里进行。 |
| GRPO | "无评论家的 PPO" | Group Relative Policy Optimization;带组均值基线 + KL 的 REINFORCE。 |
| PUCT | "AlphaZero 的 UCB" | Q + c \cdot p \cdot \sqrt{N} / (1 + N_a)——在价值估计与先验之间平衡。 |
| Self-play | "Agent 对抗过去的自己" | 零和的标准;对称训练信号。 |
| League play | "基于种群的自我对弈" | 将过去 + 当前 + 剥削者采样为对手。 |
| Verifier reward | "可验证 RL" | 奖励来自确定性检查器(测试通过、答案匹配)。 |
| Process reward | "PRM" | 给每个推理步骤打分,而不只是最终答案。 |
延伸阅读
- Silver et al. (2017). Mastering the game of Go without human knowledge (AlphaGo Zero).
- Silver et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play (AlphaZero).
- Schrittwieser et al. (2020). Mastering Atari, Go, chess and shogi by planning with a learned model (MuZero).
- Vinyals et al. (2019). Grandmaster level in StarCraft II (AlphaStar).
- DeepSeek-AI (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO) — 引入 GRPO 和组相对基线的论文。
- DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning — 完整的四阶段 R1 配方加上 R1-Zero 消融。
- Brown et al. (2019). Superhuman AI for multiplayer poker (Pluribus) — 大规模 CFR + 深度学习。
- Tesauro (1995). Temporal Difference Learning and TD-Gammon — 一切开始的那篇论文。
- Hugging Face TRL — GRPOTrainer — 用自定义奖励函数应用 GRPO 的生产参考。
- Qwen Team (2024). Qwen2.5-Math — GRPO replication — 在多个规模上对 R1 配方的开放复现。
- Sutton & Barto (2018). Ch. 17 — Frontiers of Reinforcement Learning — 自博弈、搜索和「设计奖励」的教科书框架,R1 在 LLM 规模上将其具象化。
示意图共 1 张