问题
训练真实的机器人又慢、又危险、又贵。一台双足机器人要学走路需要数百万个训练回合;而真实的双足机器人只要摔一次就会损坏硬件。仿真给你无限的复位、确定性的可复现性、并行环境和零物理损伤。
但仿真器是错的。轴承的摩擦比 MuJoCo 模型更大。相机有镜头畸变,仿真器里没有。电机有延迟、齿隙和饱和,99% 的仿真模型都略过了。风、灰尘和变化的光照会破坏在无菌渲染上训练出的政策。现实鸿沟(reality gap)——仿真分布与真实分布之间的系统性差异——是机器人部署 RL 的核心问题。
你需要一个对 sim-to-real 分布偏移稳健的政策。历史上有三种方法:随机化仿真器(域随机化)、用少量真实数据适应政策(域适应 / 微调),或辨识真实系统的参数并让仿真匹配(系统辨识)。2026 年的主流配方把三者与大规模并行仿真结合起来(Isaac Sim、Isaac Lab、GPU 上的 Mujoco MJX)。
概念
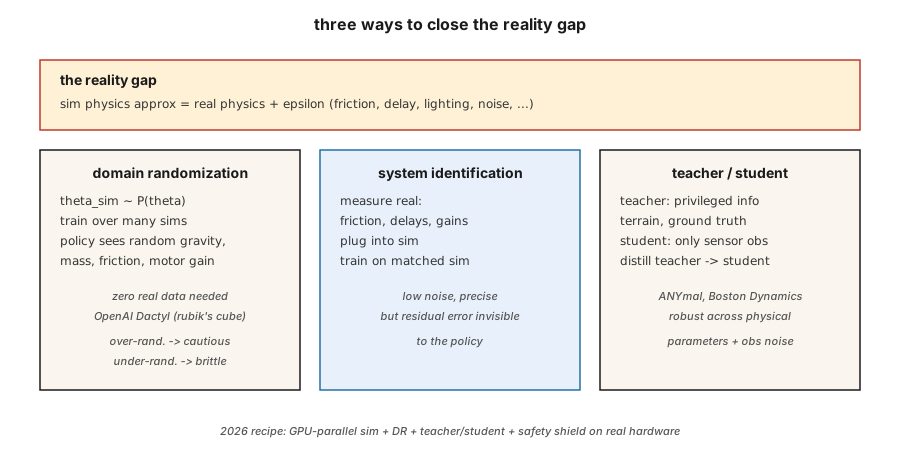
域随机化(Domain Randomization,DR)。 Tobin 等人 2017,Peng 等人 2018。训练时随机化每一个可能与真实机器人不同的仿真参数:质量、摩擦系数、电机 PD 增益、传感器噪声、相机位置、光照、纹理、接触模型。政策学到一个关于「今天处在哪个仿真里」的条件分布,并在整个跨度上泛化。如果真实机器人落在训练包络内,政策就能工作。
- 优点: 不需要真实数据。一个配方,多种机器人。
- 缺点: 过度随机化的训练会产生一个「通用」但过度保守的政策。噪声太多 ≈ 正则化太强。
系统辨识(System Identification,SI)。 在训练前把仿真器的参数拟合到真实世界数据。如果你能在真实机器人上测量臂关节摩擦,就把它插进仿真。然后训练一个期望这些值的政策。需要接触真实系统,但直接缩小现实鸿沟。
- 优点: 精确、低噪声的训练目标。
- 缺点: 残余模型误差对政策不可见;未辨识出的细小效应(例如电机死区)仍会破坏部署。
域适应(Domain Adaptation)。 在仿真里训练,用少量真实数据微调。两种形式:
- Real2Sim2Real: 用真实 rollout 学一个残差仿真器 f(s, a, z) - f_{\text{sim}}(s, a),在校正过的仿真里训练。用不多的真实数据闭合鸿沟。
- 观测适应: 训练一个通过学到的特征提取器(例如 GAN 像素到像素)把真实观测 → 类仿真观测的策略。控制器留在仿真里。
特权学习 / 教师-学生。 Miki 等人 2022(ANYmal 四足机器人)。在仿真里训练一个能访问特权信息的教师(真值摩擦、地形高度、IMU 漂移)。蒸馏出一个只看到真实传感器观测的学生。学生学习从历史中推断特权特征,从而跨物理参数稳健。
大规模并行仿真。 2024–2026。Isaac Lab、Mujoco MJX、Brax 都在单块 GPU 上跑数千个并行机器人。4096 个并行人形机器人的 PPO 在几小时内收集数年的经验。随着训练分布变宽,「现实鸿沟」缩小;当这 4096 个环境各有不同的随机化参数时,DR 几乎免费。
2026 年的真实世界配方(四足行走示例):
- 大规模并行仿真,对重力、摩擦、电机增益、负载做域随机化。
- 用特权信息(地形图、身体速度真值)训练教师政策。
- 只用本体感觉(腿关节编码器)从教师蒸馏学生政策。
- 可选:在真实 IMU 上用自编码器做观测适应。
- 部署。对 10 种以上环境零样本。如果失败,用带安全约束的 PPO 做几分钟真实世界微调。
构建它
本课代码是一个极小的域随机化演示,在转移带噪声的 GridWorld 上做。我们训练一个在「仿真」里经历随机打滑概率的政策,然后在「真实」环境里用它在训练中从未见过的打滑水平评估。这个形状直接对应 MuJoCo 到硬件的迁移。
第 1 步:参数化仿真
pythondef step(state, action, slip):
if rng.random() < slip:
action = random_perpendicular(action)
...slip 是仿真器暴露的一个参数。在真实机器人学里,它可以是摩擦、质量、电机增益——任何在仿真与现实之间变化的东西。
第 2 步:用 DR 训练
每个回合开始时,采样 slip ~ Uniform[0.0, 0.4]。训练 PPO / Q-learning / 随便什么。跑很多回合。
第 3 步:在「真实」打滑水平上零样本评估
在 slip ∈ {0.0, 0.1, 0.2, 0.3, 0.5, 0.7} 上评估。前四个在训练支撑集内;0.5 和 0.7 在分布外。DR 训练出的政策应在支撑集内保持接近最优,在外部优雅退化。固定打滑训练出的政策在训练打滑之外会很脆弱。
第 4 步:与窄范围训练对比
训练第二个政策,只用 slip = 0.0。在同样的 slip 扫描上评估。一旦真实打滑 > 0,你应该会看到灾难性的下降。
常见陷阱
- 随机化太多。 在
slip ∈ [0, 0.9]上训练,政策会变得极度风险厌恶,永远不走最优路径。匹配期望的真实世界分布,而不是「什么都有可能」。 - 随机化太少。 只在很窄的切片上训练,政策根本无法泛化。使用自适应课程(Automatic Domain Randomization),随政策提升逐步加宽分布。
- 参数空间辨识错误。 随机化错了东西(真实鸿沟是电机延迟,你却随机化相机色调),DR 没用。先分析真实机器人。
- 特权信息泄漏。 教师用全局状态而非仅观测来做动作,可能造出跟不上的学生。确保教师的政策在学生可用的观测历史下是可实现的。
- sim-to-sim 迁移失败。 如果你的政策对更难的仿真变体都不稳健,它对真实世界也不会稳健。部署前一定要在留出的仿真变体上测试。
- 没有真实世界安全包络。 在仿真里有效、在真实里也「有效」但没有底层安全盾的政策,仍可能损坏硬件。在非学习控制器里加速率限制、力矩限制、关节限制。
使用它
2026 年的 sim-to-real 技术栈:
| 领域 | 技术栈 |
|---|---|
| 腿式运动(ANYmal、Spot、人形) | Isaac Lab + DR + 特权教师 / 学生 |
| 操作(灵巧手、抓取放置) | Isaac Lab + DR + 视觉用 DR-GAN |
| 自动驾驶 | CARLA / NVIDIA DRIVE Sim + DR + 真实微调 |
| 无人机竞速 | RotorS / Flightmare + DR + 在线适应 |
| 手指/手内操作 | OpenAI Dactyl(空前规模的 DR) |
| 工业机械臂 | MuJoCo-Warp + SI + 少量真实微调 |
无论规模大小,控制的工作流都是一致的:尽可能好地拟合仿真,对拟合不了的东西做随机化,训练超大政策,蒸馏,用安全盾部署。
交付它
保存为 outputs/skill-sim2real-planner.md:
markdown---
name: sim2real-planner
description: Plan a sim-to-real transfer pipeline for a given robot + task, covering DR, SI, and safety.
version: 1.0.0
phase: 9
lesson: 11
tags: [rl, sim2real, robotics, domain-randomization]
---
Given a robot platform, a task, and access to real hardware time, output:
1. Reality gap inventory. Suspected sources ranked by expected impact (contact, sensing, actuation delay, vision).
2. DR parameters. Exact list, ranges, distribution. Justify each range against real measurements.
3. SI steps. Which parameters to measure; measurement method.
4. Teacher/student split. What privileged info the teacher uses; what obs the student uses.
5. Safety envelope. Low-level limits, emergency stops, backup controller.
Refuse to deploy without (a) a zero-shot sim-variant test, (b) a safety shield, (c) a rollback plan. Flag any DR range wider than 3× measured real variability as likely over-randomized.练习
- 简单。 在固定打滑的 GridWorld(slip=0.0)上训练 Q-learning Agent。在 \text{slip} \in \lbrace 0.0, 0.1, 0.3, 0.5 \rbrace 上评估。画出回报随打滑的变化。
- 中等。 训练一个采样
slip ~ Uniform[0, 0.3]的 DR Q-learning Agent。评估同样的扫描。在 slip=0.5(分布外)时 DR 带来了多少收益? - 困难。 实现一个课程:从 slip=0.0 开始,每次政策达到最优的 90% 就加宽 DR 范围。测量达到 slip=0.3 零样本所需的总环境步数,与固定 DR 基线对比。
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| Reality gap | "sim-to-real 差异" | 训练与部署之间物理/传感的分布偏移。 |
| Domain randomization (DR) | "在随机仿真上训练" | 训练时随机化仿真参数,让政策泛化。 |
| System identification (SI) | "测量真实、拟合仿真" | 估计真实物理参数;设置仿真来匹配。 |
| Domain adaptation | "在真实数据上微调" | 仿真训练后用少量真实世界微调;可适应观测或动力学。 |
| Privileged info | "给教师的真值" | 只有仿真才有的信息;学生必须从观测历史中推断。 |
| Teacher/student | "把特权蒸馏成可观测" | 教师带着捷径训练;学生学会在没有捷径的情况下模仿。 |
| ADR | "Automatic Domain Randomization" | 随政策提升逐步加宽 DR 范围的课程。 |
| Real2Sim | "用真实数据闭合鸿沟" | 学一个残差,让仿真模仿真实 rollout。 |
延伸阅读
- Tobin et al. (2017). Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World — 原始的 DR 论文(机器人视觉)。
- Peng et al. (2018). Sim-to-Real Transfer of Robotic Control with Dynamics Randomization — 动力学 DR,四足运动。
- OpenAI et al. (2019). Solving Rubik's Cube with a Robot Hand — Dactyl,大规模 ADR。
- Miki et al. (2022). Learning robust perceptive locomotion for quadrupedal robots in the wild — ANYmal 的教师-学生。
- Makoviychuk et al. (2021). Isaac Gym: High Performance GPU Based Physics Simulation for Robot Learning — 驱动 2025–2026 年部署的大规模并行仿真。
- Akkaya et al. (2019). Automatic Domain Randomization — ADR 课程方法。
- Sutton & Barto (2018). Ch. 8 — Planning and Learning with Tabular Methods — Dyna 框架(用模型做规划 + rollout),它是现代 sim-to-real pipeline 的基础。
- Zhao, Queralta & Westerlund (2020). Sim-to-Real Transfer in Deep Reinforcement Learning for Robotics: a Survey — sim-to-real 方法的分类学与基准结果。
示意图共 1 张