问题
一个机器人学习在房间里导航,是单 Agent RL 问题。一支足球队不是。AlphaStar 对抗 StarCraft 对手不是。一个竞价 Agent 组成的市场不是。两辆车在四向停车路口协商不是。现实世界里大量多对多的问题都不是。
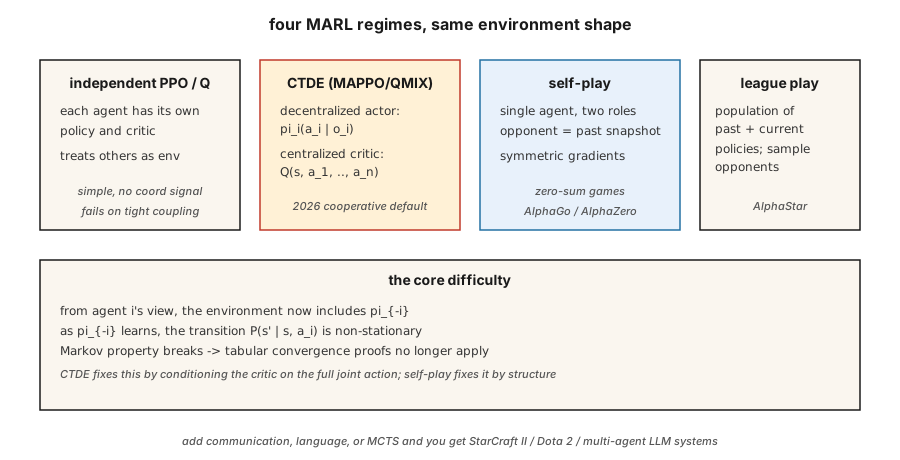
在每一种多 Agent 设定里,从任何一个 Agent 的视角看,其他 Agent就是环境的一部分。当它们学习并改变行为时,环境变得非平稳。马尔可夫性质——「下一状态只取决于当前状态和我的动作」——被违反了,因为下一状态还取决于其他Agent 选了什么,而它们的策略是移动靶。
这打破了表格型收敛证明(Q-learning 的保证假设环境平稳)。它也打破了朴素的深度 RL:Agent 互相追逐、绕圈,永远收敛不到稳定策略。你需要多 Agent 专属技术:集中训练 / 分散执行、反事实基线、联赛训练、自博弈。
2026 年的应用:机器人群体、交通路由、自动驾驶车队、市场模拟器、多 Agent LLM 系统(Phase 16),以及任何有两个以上智能玩家的游戏。
概念
形式化:马尔可夫博弈。 MDP 的推广:状态 S、联合动作 a = (a_1, \ldots, a_n)、转移 P(s' \mid s, a)、以及每个 Agent 的奖励 R_i(s, a, s')。每个 Agent i 在各自策略 \pi_i 下最大化自己的回报。如果奖励完全相同,就是完全合作。如果是零和,就是对抗。如果是混合,就是一般和。
核心挑战:
- 非平稳性。 从 Agent i 的视角看,P(s' \mid s, a_i) 取决于 \pi_{-i},而它在变化。
- 信用分配。 共享奖励下,是哪个 Agent 造成的?
- 探索协调。 Agent 必须探索互补策略,而不是冗余地探索同一个状态。
- 可扩展性。 联合动作空间随 n 指数增长。
- 部分可观测性。 每个 Agent 只能看到自己的观测;全局状态是隐藏的。
四种主导范式:
1. 独立 Q-learning / 独立 PPO(IQL、IPPO)。 每个 Agent 学自己的 Q 或策略,把其他 Agent 当作环境的一部分。简单,有时有效(尤其当经验回放充当平滑式的 Agent 建模技巧时)。理论收敛性:没有。实践中:适合松耦合任务,不适合紧耦合任务。
2. 集中训练、分散执行(CTDE)。 现代最常见的范式。每个 Agent 有自己的策略 \pi_i,以局部观测 o_i 为条件——部署时是标准的分散执行。在训练期间,一个集中评论家 Q(s, a_1, \ldots, a_n) 以完整全局状态和联合动作为条件。例子:
- MADDPG(Lowe 等人 2017):每个 Agent 一个集中评论家的 DDPG。
- COMA(Foerster 等人 2017):反事实基线——问「如果我当时改选动作 a',我的奖励会是多少?」——隔离出我的贡献。
- MAPPO / 共享评论家的 IPPO(Yu 等人 2022):带集中价值函数的 PPO。2026 年合作型 MARL 的主流。
- QMIX(Rashid 等人 2018):价值分解——Q_{\text{tot}}(s, a) = f(Q_1(s, a_1), \ldots, Q_n(s, a_n)),混合函数单调。
3. 自博弈。 同一个 Agent 的两个副本互相对抗。对手的策略就是我过去某个快照的策略。AlphaGo / AlphaZero / MuZero。OpenAI Five。最适合零和游戏;训练信号是对称的。
4. 联赛训练。 把自博弈扩展到一般和 / 对抗环境:维护一个过去和当前策略的种群,从联赛中采样对手,对着它们训练。加入剥削者(专精于击败当前最强)和主剥削者(专精于击败剥削者)。AlphaStar(StarCraft II)。当游戏存在「石头剪刀布」策略循环时需要它。
通信。 允许 Agent 互相发送学到的消息 m_i。在合作设定里有效。Foerster 等人(2016)表明可微的 Agent 间通信可以端到端训练。今天的 LLM 多 Agent 系统(Phase 16)本质上用自然语言通信。
构建它
本课用一个 6×6 GridWorld,两个合作 Agent。它们从对角出发,必须到达同一个目标。共享奖励:只要还有 Agent 在移动,每步 -1;两个都到达时 +10。见 code/main.py。
第 1 步:多 Agent 环境
pythonclass CoopGridWorld:
def __init__(self):
self.size = 6
self.goal = (5, 5)
def reset(self):
return ((0, 0), (5, 0)) # two agents
def step(self, state, actions):
a1, a2 = state
new1 = move(a1, actions[0])
new2 = move(a2, actions[1])
done = (new1 == self.goal) and (new2 == self.goal)
reward = 10.0 if done else -1.0
return (new1, new2), reward, done联合动作空间是 |A|² = 16。全局状态是两个位置。
第 2 步:独立 Q-learning
每个 Agent 跑自己的 Q 表,以联合状态为键。每一步:双方用 ε-greedy 选动作,收集联合转移,各自用共享奖励更新自己的 Q。
pythondef independent_q(env, episodes, alpha, gamma, epsilon):
Q1, Q2 = defaultdict(default_q), defaultdict(default_q)
for _ in range(episodes):
s = env.reset()
while not done:
a1 = epsilon_greedy(Q1, s, epsilon)
a2 = epsilon_greedy(Q2, s, epsilon)
s_next, r, done = env.step(s, (a1, a2))
target1 = r + gamma * max(Q1[s_next].values())
target2 = r + gamma * max(Q2[s_next].values())
Q1[s][a1] += alpha * (target1 - Q1[s][a1])
Q2[s][a2] += alpha * (target2 - Q2[s][a2])
s = s_next在这个任务上有效,因为奖励稠密且对齐。在紧耦合任务上会失败(例如一个 Agent 必须等待另一个)。
第 3 步:带分解价值更新的集中 Q
在联合动作上用一个 Q:Q(s, a_1, a_2)。用共享奖励更新。执行时通过边缘化来分散:\pi_i(s) = \arg\max_{a_i} \max_{a_{-i}} Q(s, a_1, a_2)。用指数的联合动作空间换取正确的全局视角。
第 4 步:简单的自博弈(对抗式双 Agent)
同一个 Agent,两个角色。训练 Agent A 对抗 Agent B;每 K 个回合后,把 A 的权重复制给 B。对称训练,持续进步。AlphaZero 配方的缩小版。
常见陷阱
- 非平稳回放。 独立 Agent 配经验回放比单 Agent 更糟,因为旧转移是由如今已过时的对手产生的。修复:重新打标,或按新近程度加权。
- 信用分配模糊。 长回合后的共享奖励;说不清是哪个 Agent 贡献的。修复:反事实基线(COMA),或按 Agent 做奖励塑形。
- 策略漂移 / 追逐。 每个 Agent 的最佳响应随对方的每次更新而改变。修复:集中评论家、慢学习率,或一次冻结一个。
- 通过协调实现的奖励作弊。 Agent 找到设计者没预料到的协调性钻空子。拍卖 Agent 会收敛到零出价。修复:仔细设计奖励、行为约束。
- 探索冗余。 两个 Agent 探索同样的状态-动作对。修复:每个 Agent 的熵奖励,或角色条件化。
- 联赛循环。 纯自博弈可能卡在支配循环里。修复:带多样对手的联赛训练。
- 样本爆炸。
n个 Agent × 状态空间 × 联合动作。用函数逼近来近似;因子化动作空间(每个 Agent 一个策略输出头)。
使用它
2026 年 MARL 应用地图:
| 领域 | 方法 | 备注 |
|---|---|---|
| 合作导航 / 操作 | MAPPO / QMIX | CTDE;共享评论家 + 分散演员。 |
| 双人游戏(国际象棋、围棋、扑克) | 带 MCTS 的自博弈(AlphaZero) | 零和;对称训练。 |
| 复杂多人游戏(Dota、StarCraft) | 联赛训练 + 模仿预训练 | OpenAI Five、AlphaStar。 |
| 自动驾驶车队 | CTDE MAPPO / 带注意力的 PPO | 部分观测;队伍规模可变。 |
| 拍卖市场 | 博弈论均衡 + RL | n → ∞ 时用平均场 RL。 |
| LLM 多 Agent 系统(Phase 16) | 自然语言通信 + 角色条件化 | RL 循环在 Agent 规划层。 |
2026 年,MARL 增长最快的领域是基于 LLM 的:语言模型 Agent 群体协商、辩论、构建软件。RL 以轨迹级输出的偏好优化形式出现,而不是 token 级(Phase 16 · 03)。
交付它
保存为 outputs/skill-marl-architect.md:
markdown---
name: marl-architect
description: Pick the right multi-agent RL regime (IPPO, CTDE, self-play, league) for a given task.
version: 1.0.0
phase: 9
lesson: 10
tags: [rl, multi-agent, marl, self-play]
---
Given a task with `n` agents, output:
1. Regime classification. Cooperative / adversarial / general-sum. Justify.
2. Algorithm. IPPO / MAPPO / QMIX / self-play / league. Reason tied to coupling tightness and reward structure.
3. Information access. Centralized training (what global info goes to the critic)? Decentralized execution?
4. Credit assignment. Counterfactual baseline, value decomposition, or reward shaping.
5. Exploration plan. Per-agent entropy, population-based training, or league.
Refuse independent Q-learning on tightly-coupled cooperative tasks. Refuse to recommend self-play for general-sum with cycle risks. Flag any MARL pipeline without a fixed-opponent eval (cherry-picked self-play numbers are common).练习
- 简单。 在两 Agent 合作 GridWorld 上训练独立 Q-learning。平均回报 > 0 需要多少回合?画出联合学习曲线。
- 中等。 加一个「协调」任务:只有两个 Agent 在同一回合都踏上目标时才算到达。独立 Q 还能收敛吗?什么坏了?
- 困难。 为 MAPPO 式训练实现一个集中评论家,在协调任务上对比独立 PPO 的收敛速度。
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| Markov game | "多 Agent MDP" | (S, A_1, \ldots, A_n, P, R_1, \ldots, R_n);每个 Agent 有自己的奖励。 |
| CTDE | "集中训练、分散执行" | 训练时用联合评论家;每个 Agent 的策略只用局部观测。 |
| IPPO | "独立 PPO" | 每个 Agent 分别跑 PPO。简单基线;常被低估。 |
| MAPPO | "多 Agent PPO" | 带以全局状态为条件的集中价值函数的 PPO。 |
| QMIX | "单调价值分解" | Q_{\text{tot}} = f_{\text{monotone}}(Q_1, \ldots, Q_n) 允许分散 argmax。 |
| COMA | "反事实多 Agent" | 优势 = 我的 Q 减去对我的动作边缘化后的期望 Q。 |
| Self-play | "Agent 对抗过去的自己" | 单个 Agent,两个角色;零和游戏的标准做法。 |
| League play | "种群训练" | 缓存过去策略,从池中采样对手;处理策略循环。 |
延伸阅读
- Lowe et al. (2017). Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (MADDPG) — 带集中评论家的 CTDE。
- Foerster et al. (2017). Counterfactual Multi-Agent Policy Gradients (COMA) — 用于信用分配的反事实基线。
- Rashid et al. (2018). QMIX: Monotonic Value Function Factorisation — 带单调性的价值分解。
- Yu et al. (2022). The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games (MAPPO) — PPO 在 MARL 上强得令人意外。
- Vinyals et al. (2019). Grandmaster level in StarCraft II using multi-agent reinforcement learning (AlphaStar) — 大规模联赛训练。
- Silver et al. (2017). Mastering the game of Go without human knowledge (AlphaGo Zero) — 零和游戏中的纯自博弈。
- Sutton & Barto (2018). Ch. 15 — Neuroscience & Ch. 17 — Frontiers — 包含教科书对多 Agent 设定以及 CTDE 旨在解决的非平稳问题的简短处理。
- Zhang, Yang & Başar (2021). Multi-Agent Reinforcement Learning: A Selective Overview — 覆盖合作、竞争和混合 MARL 及其收敛结果的综述。
示意图共 1 张