问题
蒙特卡洛能工作,但有两个昂贵的需求。它需要会终止的回合,而且只在最终回报到手后才更新。如果你的回合有 1,000 步,MC 要等 1,000 步才能更新任何东西。它高方差、低偏差,实践中很慢。
动态规划正好相反——零方差的自举备份——但需要已知模型。
时序差分(TD)学习取二者折中。从单个转移 (s, a, r, s') 构造一步目标 r + \gamma V(s'),把 V(s) 朝它轻推。不需要模型,不需要完整回合。右边用近似 V 会带来偏差,但方差远低于 MC,而且从第一步就能在线更新。
这是所有现代 RL——DQN、A2C、PPO、SAC——转动的枢轴。第 9 阶段余下的内容,都是在本课要写的一步 TD 更新之上叠加函数逼近与技巧。
概念
V 的 TD(0) 更新:
括号里的量是 TD 误差 \delta = r + \gamma V(s') - V(s)。它是 MC 中 G_t - V(s_t) 的在线类比。收敛要求 \alpha 满足 Robbins-Monro(\sum \alpha = \infty,\sum \alpha^2 < \infty),且所有状态被访问无穷多次。
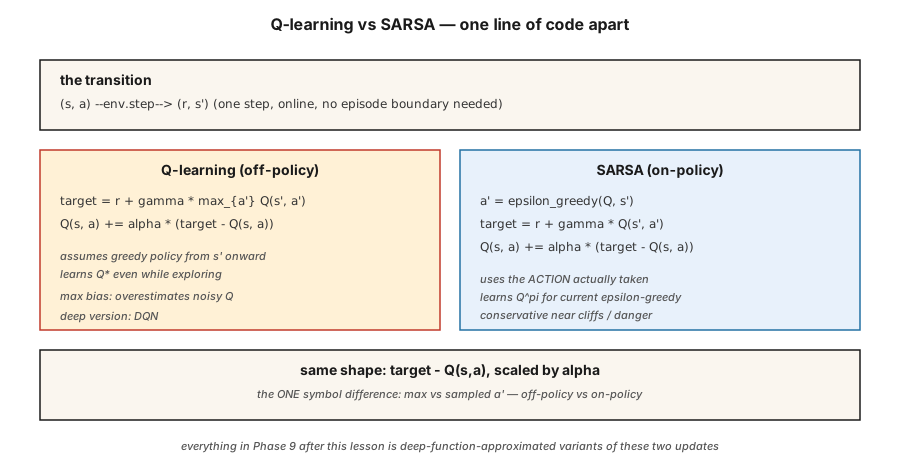
Q-learning。 一种用于控制的离策略 TD 方法:
max 假定从 s' 开始会遵循贪心策略,而不管 Agent 实际采取什么动作。这种解耦让 Q-learning 能在 Agent 通过 ε-greedy 探索的同时学到 Q^{\ast}。Mnih 等人(2015)把它改造成 Atari 上的深度 Q-learning(第 05 课)。
SARSA。 一种同策略 TD 方法:
名字就是元组 (s, a, r, s', a')。SARSA 使用 Agent实际下一步采取的动作 a',而不是贪心的 argmax。它收敛到正在运行的 ε-greedy \pi 对应的 Q^\pi;在 \epsilon \to 0 的极限下变成 Q^{\ast}。
悬崖行走的差异。 在经典的悬崖行走任务上(掉下悬崖 = 奖励 -100),Q-learning 学到沿悬崖边缘的最优路径,但探索时偶尔会吃到惩罚。SARSA 学到离悬崖一步远的更安全路径,因为它把探索噪声计入 Q 值。训练下去,两者在 \epsilon \to 0 时都达到最优。实践中这一点很重要:部署时如果探索仍在发生,SARSA 的行为更保守。
Expected SARSA。 把 Q(s', a') 换成它在 \pi 下的期望值:
方差比 SARSA 低(不对 a' 采样),同策略目标相同。常是现代教材的默认选择。
n 步 TD 与 TD(λ)。 通过等待 n 步再自举,在 TD(0) 与 MC 之间插值。n=1 是 TD,n=\infty 是 MC。TD(λ) 用几何权重 (1-\lambda)\lambda^{n-1} 对所有 n 取平均。多数深度 RL 使用 3 到 20 之间的 n。
构建它
第 1 步:ε-greedy 策略上的 SARSA
pythondef sarsa(env, episodes, alpha=0.1, gamma=0.99, epsilon=0.1):
Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})
def choose(s):
if random() < epsilon:
return choice(ACTIONS)
return max(Q[s], key=Q[s].get)
for _ in range(episodes):
s = env.reset()
a = choose(s)
while True:
s_next, r, done = env.step(s, a)
a_next = choose(s_next) if not done else None
target = r + (gamma * Q[s_next][a_next] if not done else 0.0)
Q[s][a] += alpha * (target - Q[s][a])
if done:
break
s, a = s_next, a_next
return Q八行。与 Q-learning 的唯一区别是目标那一行。
第 2 步:Q-learning
pythondef q_learning(env, episodes, alpha=0.1, gamma=0.99, epsilon=0.1):
Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})
for _ in range(episodes):
s = env.reset()
while True:
a = choose(s, Q, epsilon)
s_next, r, done = env.step(s, a)
target = r + (gamma * max(Q[s_next].values()) if not done else 0.0)
Q[s][a] += alpha * (target - Q[s][a])
if done:
break
s = s_next
return Qmax 把目标与行为解耦。就是这一个符号,区分了同策略与离策略。
第 3 步:学习曲线
每 100 个回合跟踪一次平均回报。在简单的确定性 GridWorld 上 Q-learning 收敛更快;在悬崖行走上 SARSA 更保守。在 code/main.py 的 4×4 GridWorld 上,\alpha=0.1, \epsilon=0.1 时两者约 2,000 个回合后都接近最优。
第 4 步:与 DP 真值对比
运行价值迭代(第 02 课)得到 Q^{\ast}。检查 \max_{s,a} \lvert Q_{\text{learned}}(s,a) - Q^{\ast}(s,a) \rvert。一个健康的表格型 TD Agent 在 10,000 个回合后,在 4×4 GridWorld 上的误差落在 ~0.5 以内。
常见陷阱
- Q 初始值有影响。 乐观初始化(负奖励任务中 Q = 0)鼓励探索。悲观初始化可能把贪心策略永久困住。
- α 调度。 常数 \alpha 对非平稳问题没问题。衰减 \alpha_n = 1/n 理论上收敛,但实践中太慢——把 \alpha 固定在
[0.05, 0.3],并监控学习曲线。 - ε 调度。 从高开始(\epsilon=1.0),衰减到 \epsilon=0.05。「GLIE」(极限贪心且无限探索)是收敛条件。
- Q-learning 的 max 偏差。 当 Q 有噪声时,
max算子向上偏置,导致高估。Hasselt 的 Double Q-learning(第 05 课的 DDQN 使用)用两张 Q 表修复这一点。 - 不终止的回合。 TD 可以没有终态也能学习,但你需要设置步数上限,或在上限处正确处理自举。标准做法:把触顶当作非终态,继续自举。
- 状态哈希。 如果状态是元组/张量,使用可哈希的键(元组而非列表;浮点元组要先取整,而不是用原始值)。
使用它
2026 年的 TD 版图:
| 任务 | 方法 | 理由 |
|---|---|---|
| 小型表格环境 | Q-learning | 直接学到最优策略。 |
| 同策略、安全关键 | SARSA / Expected SARSA | 探索期间更保守。 |
| 高维状态 | DQN(第 9 阶段 · 05) | 带 replay 与目标网络的神经网络 Q 函数。 |
| 连续动作 | SAC / TD3(第 9 阶段 · 07) | 在 Q 网络上做 TD 更新;策略网络输出动作。 |
| LLM RL(基于奖励模型) | PPO / GRPO(第 9 阶段 · 08、12) | 用 GAE 构造 TD 式优势的 actor-critic。 |
| 离线 RL | CQL / IQL(第 9 阶段 · 08) | 带保守正则化的 Q-learning。 |
2026 年论文里读到的「RL」,九成都是 Q-learning 或 SARSA 的某种细化。把表格更新练到手指记住,再去读更深的内容。
交付它
保存为 outputs/skill-td-agent.md:
markdown---
name: td-agent
description: Pick between Q-learning, SARSA, Expected SARSA for a tabular or small-feature RL task.
version: 1.0.0
phase: 9
lesson: 4
tags: [rl, td-learning, q-learning, sarsa]
---
Given a tabular or small-feature environment, output:
1. Algorithm. Q-learning / SARSA / Expected SARSA / n-step variant. One-sentence reason tied to on-policy vs off-policy and variance.
2. Hyperparameters. α, γ, ε, decay schedule.
3. Initialization. Q_0 value (optimistic vs zero) and justification.
4. Convergence diagnostic. Target learning curve, `|Q - Q*|` check if DP is possible.
5. Deployment caveat. How will exploration behave at inference? Is SARSA's conservatism needed?
Refuse to apply tabular TD to state spaces > 10⁶. Refuse to ship a Q-learning agent without a max-bias caveat. Flag any agent trained with ε held at 1.0 throughout (no exploitation phase).练习
- 简单。 在 4×4 GridWorld 上实现 Q-learning 与 SARSA。为 2,000 个回合画出学习曲线(每 100 回合的平均回报)。谁收敛更快?
- 中等。 构建悬崖行走环境(4×12,最后一行是悬崖,奖励 -100 并重置到起点)。比较 Q-learning 与 SARSA 的最终策略。截图各自走的路径。哪条离悬崖更近?
- 困难。 实现 Double Q-learning。在噪声奖励 GridWorld(每步奖励加高斯噪声 \sigma=5)上,展示 Q-learning 会明显高估 V^{\ast}(0,0),而 Double Q-learning 不会。
关键术语
| 术语 | 常被怎么说 | 实际含义 |
|---|---|---|
| TD error | 「更新信号」 | \delta = r + \gamma V(s') - V(s),自举后的残差。 |
| TD(0) | 「一步 TD」 | 每个转移后只用下一状态的估计更新一次。 |
| Q-learning | 「离策略 RL 入门」 | 对下一状态动作取 max 的 TD 更新;不管行为策略如何都学到 Q^{\ast}。 |
| SARSA | 「同策略 Q-learning」 | 用实际下一动作的 TD 更新;学当前 ε-greedy π 对应的 Q^\pi。 |
| Expected SARSA | 「低方差的 SARSA」 | 用 π 下的期望替代采样得到的 a'。 |
| GLIE | 「正确的探索调度」 | Greedy in the Limit with Infinite Exploration;Q-learning 收敛所需。 |
| Bootstrapping | 「目标里用当前估计」 | TD 与 MC 的分水岭。偏差的来源,但能大幅降方差。 |
| Maximization bias | 「Q-learning 会高估」 | 对噪声估计取 max 会向上偏置;由 Double Q-learning 修复。 |
延伸阅读
- Watkins & Dayan (1992). Q-learning —— 原始论文与收敛性证明。
- Sutton & Barto (2018). Ch. 6 — Temporal-Difference Learning —— TD(0)、SARSA、Q-learning、Expected SARSA。
- Hasselt (2010). Double Q-learning —— 最大化偏差的修复。
- Seijen, Hasselt, Whiteson, Wiering (2009). A Theoretical and Empirical Analysis of Expected SARSA —— Expected SARSA 的动机。
- Rummery & Niranjan (1994). On-line Q-learning using connectionist systems —— 提出 SARSA 的论文(当时叫「modified connectionist Q-learning」)。
- Sutton & Barto (2018). Ch. 7 — n-step Bootstrapping —— 把 TD(0) 推广到 TD(n),即从 Q-learning 走向资格迹、再走向 PPO 中 GAE 的路径。
示意图共 1 张