问题
你在写一个国际象棋机器人,或者一个库存规划器,或者一个交易 Agent,又或者训练推理模型的 PPO 循环。四个不同的领域,却有一个令人意外的事实:它们全都坍缩成同一个数学对象。
监督学习给你 (x, y) 对,让你拟合一个函数。强化学习不给你标签——只给你一串状态、你做过的动作,以及一个标量奖励。这步棋赢了吗?这次补货决策省钱了吗?这笔交易赚钱了吗?LLM 刚生成的那个 token,是否让评判器给出了更高的奖励?
在把这条数据流形式化之前,你无法从中学习。「我看到了什么」「我做了什么」「接下来发生了什么」「这有多好」——每一项都必须变成可以推理的对象。这种形式化就是马尔可夫决策过程(Markov Decision Process,MDP)。本阶段每一个 RL 算法,包括最后的 RLHF 与 GRPO 循环,都在这套结构上做优化。
概念
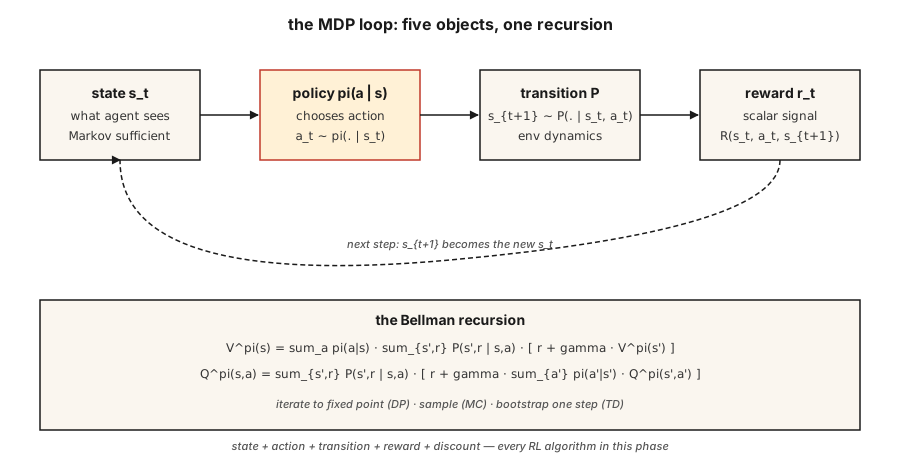
五个对象。
- 状态 S。Agent 做决策所需的全部信息。在 GridWorld 中是格子,在国际象棋中是棋盘,在 LLM 中是上下文窗口加上任何记忆。
- 动作 A。可选的行动。上下左右移动。落子。生成一个 token。
- 转移 P(s' \mid s, a)。给定状态 s 和动作 a,下一状态上的分布。国际象棋中是确定性的,库存问题中是随机的,LLM 解码中几乎是确定性的。
- 奖励 R(s, a, s')。标量信号。赢 = +1,输 = -1。收入减去成本。GRPO 中的对数似然比项。
- 折扣 \gamma \in [0, 1)。未来奖励相对于当前奖励的权重。\gamma = 0.99 对应约 100 步的视野;\gamma = 0.9 对应约 10 步。
马尔可夫性质 P(s_{t+1} \mid s_t, a_t) = P(s_{t+1} \mid s_0, a_0, \ldots, s_t, a_t)。未来只依赖当前状态。如果不满足,说明状态表示不完整——这不是方法的失败,而是状态的失败。
策略与回报。 策略 \pi(a \mid s) 把状态映射到动作分布。回报 G_t = r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \ldots 是未来奖励的折扣和。价值 V^\pi(s) = \mathbb{E}[G_t \mid s_t = s] 是在策略 \pi 下从 s 出发的期望回报。Q 值 Q^\pi(s, a) = \mathbb{E}[G_t \mid s_t = s, a_t = a] 是以某个指定动作作为第一步的期望回报。每个 RL 算法都在估计这两者之一,再据此改进 \pi。
贝尔曼方程。 本阶段所有内容都会用到的定点方程:
这些方程把期望回报拆成「这一步的奖励」加上「落地位置的折扣价值」。递归。第 9 阶段的每个算法,要么迭代这个方程直到收敛(动态规划),要么从中采样(蒙特卡洛),要么做一步自举(时序差分)。
构建它
第 1 步:一个极小的确定性 MDP
一个 4×4 的 GridWorld。Agent 从左上角出发,终点在右下角,每走一步奖励 -1,动作集合为 {up, down, left, right}。见 code/main.py。
pythonGRID = 4
TERMINAL = (3, 3)
ACTIONS = {"up": (-1, 0), "down": (1, 0), "left": (0, -1), "right": (0, 1)}
def step(state, action):
if state == TERMINAL:
return state, 0.0, True
dr, dc = ACTIONS[action]
r, c = state
nr = min(max(r + dr, 0), GRID - 1)
nc = min(max(c + dc, 0), GRID - 1)
return (nr, nc), -1.0, (nr, nc) == TERMINAL五行。这就是整个环境。确定性转移、恒定步数惩罚、吸收终态。
第 2 步:跑一条策略的轨迹
策略是从状态到动作分布的函数。最简单的:均匀随机。
pythondef uniform_policy(state):
return {a: 0.25 for a in ACTIONS}
def rollout(policy, max_steps=200):
s, total, steps = (0, 0), 0.0, 0
for _ in range(max_steps):
a = sample(policy(s))
s, r, done = step(s, a)
total += r
steps += 1
if done:
break
return total, steps对随机策略跑 1000 次。在这个 4×4 棋盘上,平均回报大约在 -60 到 -80 之间。最优回报是 -6(沿直线向右下走)。弥合这个差距,就是第 9 阶段的全部主题。
第 3 步:用贝尔曼方程精确计算 V^π
对小型 MDP,贝尔曼方程是一个线性系统。枚举状态,套用期望,反复迭代直到数值不再变化。
pythondef policy_evaluation(policy, gamma=0.99, tol=1e-6):
V = {s: 0.0 for s in all_states()}
while True:
delta = 0.0
for s in all_states():
if s == TERMINAL:
continue
v = 0.0
for a, pi_a in policy(s).items():
s_next, r, _ = step(s, a)
v += pi_a * (r + gamma * V[s_next])
delta = max(delta, abs(v - V[s]))
V[s] = v
if delta < tol:
return V这就是迭代策略评估。它是 Sutton & Barto 书中的第一个算法,也是后续所有 RL 方法的理论基础。
第 4 步:γ 是有物理含义的超参数
有效视野大约是 1 / (1 - \gamma)。\gamma = 0.9 → 10 步。\gamma = 0.99 → 100 步。\gamma = 0.999 → 1000 步。
太低,Agent 会变得短视。太高,信用分配会变嘈杂,因为早期的许多步都要为遥远的未来奖励分担责任。LLM RLHF 通常取 \gamma = 1,因为回合短且有界。控制任务用 0.95–0.99。长视野策略游戏用 0.999。
常见陷阱
- 非马尔可夫状态。 如果你需要最近三次观测才能决策,那么「状态」就不只是当前观测。修复:堆叠帧(Atari 上的 DQN 堆 4 帧),或使用循环状态(在观测上跑 LSTM/GRU)。
- 稀疏奖励。 只有胜负的奖励,会让大状态空间中的学习几乎不可能。对奖励做塑形(加入中间信号),或用模仿学习做引导(第 9 阶段 · 09)。
- 奖励劫持。 优化代理奖励往往会产生病态行为。OpenAI 的赛艇 Agent 原地转圈、无限收集道具,而不是完成比赛。永远根据目标结果来定义奖励,而不是代理指标。
- 折扣设错。 在无限视野任务上取 \gamma = 1,会令所有价值变为无穷。要么设定有限视野,要么取 \gamma < 1。
- 奖励尺度。 {+100, -100} 与 {+1, -1} 的奖励给出相同的最优策略,但梯度幅度差异巨大。接入 PPO/DQN 之前,先归一化到
[-1, 1]附近。
使用它
2026 年的技术栈,会在碰代码之前把每个 RL 流程都归约为一个 MDP:
| 场景 | 状态 | 动作 | 奖励 | γ |
|---|---|---|---|---|
| 控制(运动、操作) | 关节角度 + 速度 | 连续力矩 | 任务特定的塑形奖励 | 0.99 |
| 博弈(国际象棋、围棋、扑克) | 棋盘 + 历史 | 合法着法 | 胜=+1 / 负=-1 | 1.0(有限时域) |
| 库存 / 定价 | 库存 + 需求 | 订货量 | 收入 - 成本 | 0.95 |
| LLM 的 RLHF | 上下文 token | 下一个 token | 结束时奖励模型打分 | 1.0(回合约 200 token) |
| 推理任务的 GRPO | Prompt + 部分回复 | 下一个 token | 结束时验证器 0/1 | 1.0 |
写任何训练循环之前,先把这五元组写清楚。大多数「RL 不 work」的 bug 报告,都能追溯到在纸面上就已经建错的 MDP。
交付它
保存为 outputs/skill-mdp-modeler.md:
markdown---
name: mdp-modeler
description: Given a task description, produce a Markov Decision Process spec and flag formulation risks before training.
version: 1.0.0
phase: 9
lesson: 1
tags: [rl, mdp, modeling]
---
Given a task (control / game / recommendation / LLM fine-tuning), output:
1. State. Exact feature vector or tensor spec. Justify Markov property.
2. Action. Discrete set or continuous range. Dimensionality.
3. Transition. Deterministic, stochastic-with-known-model, or sample-only.
4. Reward. Function and source. Sparse vs shaped. Terminal vs per-step.
5. Discount. Value and horizon justification.
Refuse to ship any MDP where the state is non-Markovian without explicit mention of frame-stacking or recurrent state. Refuse any reward that was not defined in terms of the target outcome. Flag any `γ ≥ 1.0` on an infinite-horizon task. Flag any reward range >100x the typical step reward as a likely gradient-explosion source.练习
- 简单。 在
code/main.py中实现 4×4 GridWorld 和随机策略的轨迹采样。跑 10,000 个回合。报告回报的均值和标准差,并与最优回报(-6)对比。 - 中等。 对均匀随机策略,用 \gamma \in \lbrace 0.5, 0.9, 0.99 \rbrace 运行
policy_evaluation。把每种情况下的V打印成 4×4 网格。解释为什么 \gamma 越大,靠近终点的状态价值增长得越快。 - 困难。 把 GridWorld 改成随机环境:每个动作以概率 p = 0.1 滑向相邻的垂直方向。重新评估均匀策略。
V[start]变好还是变差?为什么?
关键术语
| 术语 | 常被怎么说 | 实际含义 |
|---|---|---|
| MDP | 「强化学习的设定」 | 满足马尔可夫性质的元组 (S, A, P, R, \gamma)。 |
| State | 「Agent 看到的东西」 | 在所选策略类下,足以概括未来动态的统计量。 |
| Policy | 「Agent 的行为」 | 条件分布 \pi(a \mid s) 或确定性映射 s \to a。 |
| Return | 「总奖励」 | 从当前步开始的折扣和 \sum \gamma^t r_t。 |
| Value | 「一个状态有多好」 | 在 \pi 下从 s 出发的期望回报。 |
| Q-value | 「一个动作有多好」 | 在 \pi 下从 s 出发、先执行 a 的期望回报。 |
| Bellman equation | 「动态规划递推」 | 把价值 / Q 值分解为「一步奖励 + 折扣后的后继价值」的定点分解。 |
| Discount \gamma | 「未来与当下」 | 对远期奖励的几何权重;有效视野 \approx 1/(1-\gamma)。 |
延伸阅读
- Sutton & Barto (2018). Reinforcement Learning: An Introduction, 2nd ed. —— 教科书。第 3 章讲 MDP 与贝尔曼方程;第 1 章阐述奖励假设,后续每一课都建立在它之上。
- Bellman (1957). Dynamic Programming —— 贝尔曼方程的源头。
- OpenAI Spinning Up — Part 1: Key Concepts —— 从深度强化学习角度写的简明 MDP 入门。
- Puterman (2005). Markov Decision Processes —— 运筹学领域关于 MDP 与精确解法的参考书。
- Littman (1996). Algorithms for Sequential Decision Making (PhD thesis) —— 把 MDP 视为动态规划特化的最清晰推导。
示意图共 1 张