问题
动态规划很优雅,但它假设你能对每个状态和动作查询 P(s' \mid s, a)。现实世界几乎没有什么东西是这样运作的。机器人无法解析地计算施加关节力矩后相机像素上的分布。定价算法无法对每位顾客可能的反应做积分。LLM 无法枚举一个 token 之后所有可能的续写。
你需要一种只依赖采样能力的方法。运行策略,得到一条轨迹 s_0, a_0, r_1, s_1, a_1, r_2, …, s_T,用它估计价值。这就是蒙特卡洛。
从 DP 到 MC 的转变在哲学上很重要:我们从已知模型 + 精确备份转向采样轨迹 + 平均回报。方差跳升,但适用范围爆炸式扩大。本课之后的每个 RL 算法——TD、Q-learning、REINFORCE、PPO、GRPO——本质上都是蒙特卡洛估计器,有时在上面叠加自举。
概念
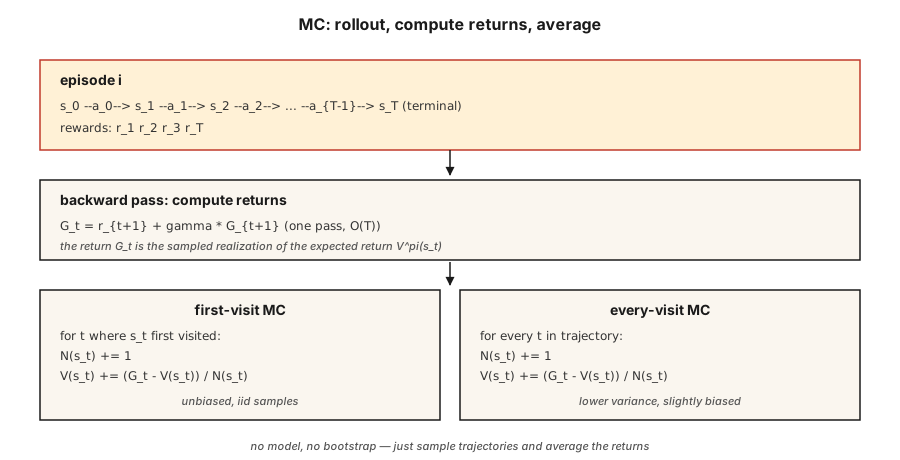
核心思想,一行: V^\pi(s) = \mathbb E_\pi[G_t \mid s_t = s] \approx (1/N) \sum_i G^{(i)}(s),其中 G^{(i)}(s) 是在策略 \pi 下访问 s 之后观测到的回报。
首次访问 MC 与每次访问 MC。 给定一个多次访问状态 s 的回合,首次访问 MC 只计入第一次访问的回报;每次访问 MC 计入所有访问。两者在极限下都是无偏的。首次访问更容易分析(iid 样本)。每次访问每个回合使用更多数据,实践中通常收敛更快。
增量均值。 不必存储所有回报,而是更新滑动平均:
整理得:V_{\text{new}} = V_{\text{old}} + \alpha \cdot (\text{target} - V_{\text{old}}),其中 \alpha = 1/n。把 1/n 换成常数步长 \alpha \in (0, 1),你就得到一个能跟踪 \pi 变化的非平稳 MC 估计器。这一步就是从 MC 跳到 TD、再跳到所有现代 RL 算法的全部内容。
探索现在成了问题。 DP 通过枚举触及每个状态。MC 只能看到策略访问过的状态。如果 \pi 是确定性的,状态空间的整片区域永远不会被采样,其价值估计将永远停留在零。三种修复,按历史顺序:
- 探索性起点。 每个回合从随机的 (s, a) 对开始。保证覆盖;实践中不现实(你无法把机器人「重置」到任意状态)。
- ε-greedy。 关于当前 Q 贪心行动,但以概率 \epsilon 随机选动作。所有状态-动作对都会渐近地被采样到。
- 离策略 MC。 在行为策略 \mu 下收集数据,通过重要性采样学习目标策略 \pi。方差高,但它是通向 DQN 这类 replay buffer 方法的桥梁。
蒙特卡洛控制。 评估 → 改进 → 评估,和策略迭代一样,但评估基于采样:
- 运行 \pi,得到一个回合。
- 用观测到的回报更新 Q(s, a)。
- 让 \pi 关于 Q 变成 ε-greedy。
- 重复。
在温和条件下(每对都被访问无穷多次,\alpha 满足 Robbins-Monro),以概率 1 收敛到 Q^{\ast} 和 \pi^{\ast}。
构建它
第 1 步:轨迹 → (s, a, r) 列表
pythondef rollout(env, policy, max_steps=200):
trajectory = []
s = env.reset()
for _ in range(max_steps):
a = policy(s)
s_next, r, done = env.step(s, a)
trajectory.append((s, a, r))
s = s_next
if done:
break
return trajectory没有模型,只有 env.reset() 和 env.step(s, a)。接口和 gym 环境一样,但做了简化。
第 2 步:计算回报(反向扫描)
pythondef returns_from(trajectory, gamma):
returns = []
G = 0.0
for _, _, r in reversed(trajectory):
G = r + gamma * G
returns.append(G)
return list(reversed(returns))一次遍历,O(T)。反向递推 G_t = r_{t+1} + \gamma G_{t+1} 避免了重复求和。
第 3 步:首次访问 MC 评估
pythondef mc_policy_evaluation(env, policy, episodes, gamma=0.99):
V = defaultdict(float)
counts = defaultdict(int)
for _ in range(episodes):
trajectory = rollout(env, policy)
returns = returns_from(trajectory, gamma)
seen = set()
for t, ((s, _, _), G) in enumerate(zip(trajectory, returns)):
if s in seen:
continue
seen.add(s)
counts[s] += 1
V[s] += (G - V[s]) / counts[s]
return V三行完成工作:首次访问时标记状态已见、计数加一、更新滑动平均。
第 4 步:ε-greedy MC 控制(同策略)
pythondef mc_control(env, episodes, gamma=0.99, epsilon=0.1):
Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})
counts = defaultdict(lambda: {a: 0 for a in ACTIONS})
def policy(s):
if random() < epsilon:
return choice(ACTIONS)
return max(Q[s], key=Q[s].get)
for _ in range(episodes):
trajectory = rollout(env, policy)
returns = returns_from(trajectory, gamma)
seen = set()
for (s, a, _), G in zip(trajectory, returns):
if (s, a) in seen:
continue
seen.add((s, a))
counts[s][a] += 1
Q[s][a] += (G - Q[s][a]) / counts[s][a]
return Q, policy第 5 步:与 DP 金标准对比
你对 V^\pi 的 MC 估计应当随着回合数 → ∞ 与第 02 课的 DP 结果一致。实践中:在 4×4 GridWorld 上跑 50,000 个回合,与 DP 答案的差距在 ~0.1 以内。
常见陷阱
- 无限回合。 MC 要求回合终止。如果你的策略可能永远循环,就设置
max_steps上限,并将触顶视为隐式失败。随机策略下的 GridWorld 经常超时——这很正常,只要正确计数就行。 - 方差。 MC 使用完整回报。长回合中方差极大——末尾一个不幸的奖励会把 V(s_0) 整体平移同样的量。TD 方法(第 04 课)通过自举削减这一点。
- 状态覆盖。 在全新的 Q 上,带平局的贪心 MC 只会尝试一个动作。你必须探索(ε-greedy、探索性起点、UCB)。
- 非平稳策略。 如果 \pi 在变化(如 MC 控制中),旧回报来自不同的策略。常数 α MC 能处理;样本平均 MC 不能。
- 离策略重要性采样。 权重 \pi(a \mid s)/\mu(a \mid s) 会沿轨迹连乘。方差随视野爆炸。用逐决策加权 IS 设上限,或改用 TD。
使用它
2026 年蒙特卡洛方法的角色:
| 用例 | 为什么用 MC |
|---|---|
| 短视野游戏(21 点、扑克) | 回合自然终止;回报干净。 |
| 对日志策略做离线评估 | 对存储的轨迹求折扣回报平均。 |
| 蒙特卡洛树搜索(AlphaZero) | 从树叶做 MC 轨迹采样来指导选择。 |
| LLM RL 评估 | 对给定策略的采样完成结果计算平均奖励。 |
| PPO 中的基线估计 | 优势目标 A_t = G_t - V(s_t) 使用 MC 的 G_t。 |
| 教学 RL | 真正能工作的最简单算法——去掉自举就能看到核心。 |
现代深度 RL 算法(PPO、SAC)通过 n 步回报或 GAE 在纯 MC(完整回报)与纯 TD(一步自举)之间插值。两个端点都是同一估计器的实例。
交付它
保存为 outputs/skill-mc-evaluator.md:
markdown---
name: mc-evaluator
description: Evaluate a policy via Monte Carlo rollouts and produce a convergence report with DP-comparison if available.
version: 1.0.0
phase: 9
lesson: 3
tags: [rl, monte-carlo, evaluation]
---
Given an environment (episodic, with reset+step API) and a policy, output:
1. Method. First-visit vs every-visit MC. Reason.
2. Episode budget. Target number, variance diagnostic, expected standard error.
3. Exploration plan. ε schedule (if needed) or exploring starts.
4. Gold-standard comparison. DP-optimal V* if tabular; otherwise a bound from a Q-learning / PPO baseline.
5. Termination check. Max-step cap, timeouts, handling of non-terminating trajectories.
Refuse to run MC on non-episodic tasks without a finite horizon cap. Refuse to report V^π estimates from fewer than 100 episodes per state for tabular tasks. Flag any policy with zero-variance actions as an exploration risk.练习
- 简单。 在 4×4 GridWorld 上实现均匀随机策略的首次访问 MC 评估。跑 10,000 个回合。画出 V(0,0) 随回合数变化、并与 DP 答案对比的曲线。
- 中等。 实现 ε-greedy MC 控制,\epsilon \in \lbrace 0.01, 0.1, 0.3 \rbrace。比较 20,000 个回合后的平均回报。曲线长什么样?偏差-方差权衡在哪里?
- 困难。 实现带重要性采样的离策略 MC:在均匀随机策略 \mu 下收集数据,估计确定性最优策略 \pi 的 V^\pi。比较普通 IS、逐决策 IS 与加权 IS。哪个方差最低?
关键术语
| 术语 | 常被怎么说 | 实际含义 |
|---|---|---|
| Monte Carlo | 「随机采样」 | 通过对分布中 iid 样本取平均来估计期望。 |
| Return G_t | 「未来奖励」 | 从第 t 步到回合结束的折扣奖励之和:\sum_{k\ge 0} \gamma^k r_{t+k+1}。 |
| First-visit MC | 「每个状态只计一次」 | 一个回合中只有第一次访问计入价值估计。 |
| Every-visit MC | 「用上所有访问」 | 每次访问都计入;略有偏差,但样本效率更高。 |
| ε-greedy | 「探索噪声」 | 以概率 1-\epsilon 选贪心动作;以概率 \epsilon 随机选动作。 |
| Importance sampling | 「纠正从错误分布采样」 | 用 \pi(a \mid s)/\mu(a \mid s) 的连乘对回报重新加权,从 \mu 的数据估计 V^\pi。 |
| On-policy | 「用自己的数据学习」 | 目标策略 = 行为策略。原始 MC、PPO、SARSA。 |
| Off-policy | 「用别人的数据学习」 | 目标策略 ≠ 行为策略。重要性采样 MC、Q-learning、DQN。 |
延伸阅读
- Sutton & Barto (2018). Ch. 5 — Monte Carlo Methods —— 经典论述。
- Singh & Sutton (1996). Reinforcement Learning with Replacing Eligibility Traces —— 首次访问与每次访问的分析。
- Precup, Sutton, Singh (2000). Eligibility Traces for Off-Policy Policy Evaluation —— 离策略 MC 与方差控制。
- Mahmood et al. (2014). Weighted Importance Sampling for Off-Policy Learning —— 现代低方差 IS 估计器。
- Tesauro (1995). TD-Gammon, A Self-Teaching Backgammon Program —— 首次大规模实证展示 MC/TD 自博弈收敛到超人水平;本阶段后半部分每一课的概念先驱。
示意图共 1 张