问题
你在下一 token 预测目标上训练了一个语言模型。它能写出语法正确的英语。它也会撒谎、胡扯,该拒绝时却不拒绝。你没法靠更多预训练修好它——网络文本是问题本身,不是解药。
你想要一个标量奖励,能表达「回复 A 比回复 B 更适合指令 X」。手动写这个奖励函数是不可能的。「有帮助性」不是一个关于 token 的闭式表达式。但人类可以比较两个输出并标出偏好。这种数据在大规模下收集起来很便宜。
RLHF(Christiano 等人 2017;Ouyang 等人 2022)把偏好转换成奖励模型,再用 PPO 对着这个奖励优化 LM。分三步:SFT → RM → PPO。这就是让 ChatGPT、Claude、Gemini,以及 2023–2025 年所有其他对齐 LLM 上线的配方。
2026 年,PPO 那一步大多被 DPO(Phase 10 · 08)取代,因为后者更便宜,对对齐调优的效果也几乎一样好。但奖励模型这一块仍然支撑着每一个 Best-of-N 采样器、每一条从可验证奖励做 RL 的 pipeline,以及每一个使用过程奖励模型的推理模型。理解了 RLHF,你就理解了整个对齐栈。
概念
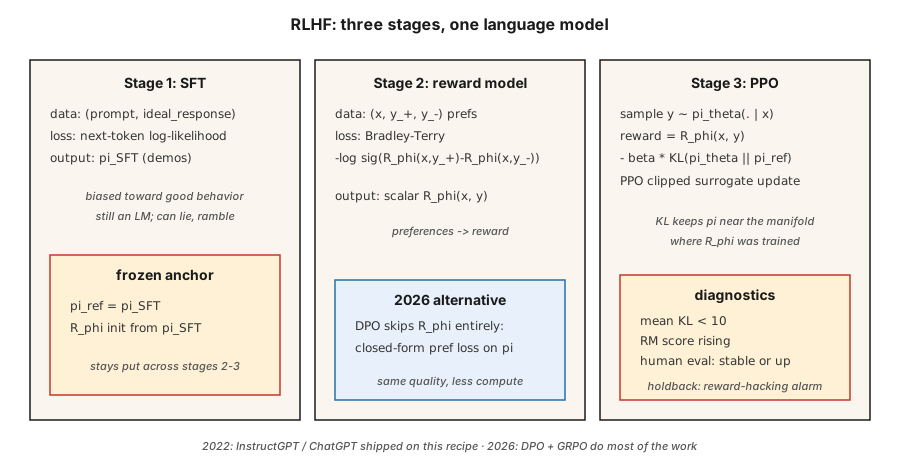
阶段 1:监督微调(SFT)。 从预训练基础模型开始。在目标行为的人类示范上微调(指令跟随回复、有帮助的回答等)。结果:一个 \pi_{\text{SFT}} 模型,它偏向良好行为,但动作空间仍然无界。
阶段 2:奖励模型训练。
- 收集针对提示 x 的成对回复 (y_+, y_-),由人类标注为「y_+ 优于 y_-」。
- 训练奖励模型 R_\phi(x, y),给 y_+ 打出更高的分。
- 损失:Bradley-Terry 成对逻辑损失:
L(\phi) = -\mathbb{E}[ \log \sigma(R_\phi(x, y_+) - R_\phi(x, y_-)) ]
\sigma 是 sigmoid。奖励之差意味着偏好的对数几率。BT 自 1952 年以来就是标准(Bradley-Terry),也是现代 RLHF 的主导选择。
- R_\phi 通常从 SFT 模型初始化,在上面加一个标量头。同一个 Transformer 主干;一个线性层输出奖励。
阶段 3:带 KL 惩罚的 PPO 对抗 RM。
- 从 \pi_{\text{SFT}} 初始化可训练策略 \pi_\theta。保留一个冻结的参考 \pi_{\text{ref}} = \pi_{\text{SFT}}。
- 回复 y 末尾的奖励:
r_{\text{total}}(x, y) = R_\phi(x, y) - \beta \cdot \mathrm{KL}(\pi_\theta(\cdot \mid x) \Vert \pi_{\text{ref}}(\cdot \mid x))
KL 惩罚防止 \pi_\theta 任意偏离 \pi_{\text{SFT}}——它是正则项,不是硬信赖域。\beta 通常取 0.01-0.05。
- 用这个奖励跑 PPO(第 08 课)。优势在 token 级轨迹上计算,但 RM 只给完整回复打分。
为什么需要 KL? 没有它,PPO 会愉快地找到奖励作弊策略——RM 只在分布内的补全上训练过。一个分布外的回复可能比任何人类写的都得分更高。KL 把 \pi_\theta 保持在 RM 训练过的那片流形附近。它是 RLHF 里最重要的那个旋钮。
2026 年现状:
- DPO(Rafailov 2023):闭式代数把阶段 2+3 坍缩成偏好数据上的单个监督损失。没有 RM,没有 PPO。在对齐基准上质量相同,算力只占一小部分。见 Phase 10 · 08。
- GRPO(DeepSeek 2024–2025):用组相对基线代替评论家的 PPO,奖励来自验证器(代码能跑 / 数学答案匹配),而不是人类训练的 RM。推理模型的主流做法。见 Phase 9 · 12。
- 过程奖励模型(PRM): 给部分解(每个推理步骤)打分,用于 RLHF 和推理方向的 GRPO 变体。
- Constitutional AI / RLAIF: 用对齐的 LLM 生成偏好代替人类。扩展了偏好预算。
构建它
本课使用极小的合成「提示」和「回复」,都用字符串表示。RM 是基于词袋表示的线性打分器。没有真正的 LLM——重要的是 pipeline 的形状,不是规模。见 code/main.py。
第 1 步:合成偏好数据
pythonPROMPTS = ["help me", "answer me", "explain this"]
GOOD_WORDS = {"clear", "specific", "kind", "thorough"}
BAD_WORDS = {"vague", "rude", "wrong", "short"}
def make_pair(rng):
x = rng.choice(PROMPTS)
y_good = rng.choice(list(GOOD_WORDS)) + " " + rng.choice(list(GOOD_WORDS))
y_bad = rng.choice(list(BAD_WORDS)) + " " + rng.choice(list(BAD_WORDS))
return (x, y_good, y_bad)真实 RLHF 里这一步换成人类标注员。形状——(prompt, preferred_response, rejected_response)——完全相同。
第 2 步:Bradley-Terry 奖励模型
线性打分:R(x, y) = w · bag(y)。训练以最小化 BT 成对对数损失:
pythondef rm_train_step(w, x, y_pos, y_neg, lr):
r_pos = dot(w, bag(y_pos))
r_neg = dot(w, bag(y_neg))
p = sigmoid(r_pos - r_neg)
for tok, cnt in bag(y_pos).items():
w[tok] += lr * (1 - p) * cnt
for tok, cnt in bag(y_neg).items():
w[tok] -= lr * (1 - p) * cnt几百次更新之后,w 会给好词 token 正的权重,给坏词负的权重。
第 3 步:在 RM 之上加类 PPO 策略
我们的玩具策略从词表里产生单个 token。我们在 RM 下给这个 token 打分,计算 \log \pi_\theta(\text{token} \mid \text{prompt}),加上对参考的 KL 惩罚,再应用裁剪的 PPO 替代目标。
pythondef rlhf_step(theta, ref, w, prompt, rng, eps=0.2, beta=0.1, lr=0.05):
logits_theta = policy_logits(theta, prompt)
probs = softmax(logits_theta)
token = sample(probs, rng)
logits_ref = policy_logits(ref, prompt)
probs_ref = softmax(logits_ref)
reward = dot(w, bag([token])) - beta * kl(probs, probs_ref)
# ppo-style update on theta, treating reward as the return
...第 4 步:监控 KL
每次更新都跟踪平均 \mathrm{KL}(\pi_\theta \Vert \pi_{\text{ref}})。如果它悄悄爬过 ~5-10,说明策略已经远离 \pi_{\text{SFT}}——要么 \beta 在上升,要么奖励作弊开始了。这是真实 RLHF 里的头号诊断指标。
第 5 步:用 TRL 的生产配方
一旦理解了玩具 pipeline,下面是真实库用户写出的同一个循环。Hugging Face 的 TRL 是参考实现——阶段 2 用 RewardTrainer,阶段 3 用 PPOTrainer(内置对参考的 KL)。
python# Stage 2: reward model from pairwise preferences
from trl import RewardTrainer, RewardConfig
from transformers import AutoModelForSequenceClassification, AutoTokenizer
tok = AutoTokenizer.from_pretrained("meta-llama/Llama-3.1-8B-Instruct")
rm = AutoModelForSequenceClassification.from_pretrained(
"meta-llama/Llama-3.1-8B-Instruct", num_labels=1
)
# dataset rows: {"prompt", "chosen", "rejected"} — Bradley-Terry format
trainer = RewardTrainer(
model=rm,
tokenizer=tok,
train_dataset=preference_data,
args=RewardConfig(output_dir="./rm", num_train_epochs=1, learning_rate=1e-5),
)
trainer.train()python# Stage 3: PPO against the RM with KL penalty to the SFT reference
from trl import PPOTrainer, PPOConfig, AutoModelForCausalLMWithValueHead
policy = AutoModelForCausalLMWithValueHead.from_pretrained("./sft-checkpoint")
ref = AutoModelForCausalLMWithValueHead.from_pretrained("./sft-checkpoint") # frozen
ppo = PPOTrainer(
config=PPOConfig(learning_rate=1.41e-5, batch_size=64, init_kl_coef=0.05,
target_kl=6.0, adap_kl_ctrl=True),
model=policy, ref_model=ref, tokenizer=tok,
)
for batch in dataloader:
responses = ppo.generate(batch["query_ids"], max_new_tokens=128)
rewards = rm(torch.cat([batch["query_ids"], responses], dim=-1)).logits[:, 0]
stats = ppo.step(batch["query_ids"], responses, rewards)
# stats includes: mean_kl, clip_frac, value_loss — the three PPO diagnostics库替你做了三件事。adap_kl_ctrl=True 实现自适应 β 调度:观测到的 KL 超过 target_kl 就翻倍 β;低于一半就减半。参考模型按约定是冻结的——你绝不能不小心和 policy 共享参数。价值头与策略在同一个主干上(AutoModelForCausalLMWithValueHead 会附加一个标量 MLP 头),这就是为什么 TRL 分别报告 policy/kl 和 value/loss。
常见陷阱
- 过度优化 / 奖励作弊。 RM 并不完美;\pi_\theta 会找到得分高但很糟糕的对抗性补全。症状:奖励无限攀升,而人类评估分数持平或下降。修复:早停、调高 \beta、扩大 RM 训练数据。
- 长度作弊。 在有帮助的回复上训练的 RM,常常隐含地奖励长度。策略学会给回复灌水。补救:长度归一化奖励,或用长度感知 RM 的 RLAIF。
- RM 太小。 RM 至少要跟策略一样大。太小的 RM 无法忠实地给策略的输出打分。
- KL 调参。 β 太低 → 漂移和奖励作弊。β 太高 → 策略几乎不变。标准技巧是用自适应 β,把每步 KL 目标固定住。
- 偏好数据噪声。 约 30% 的人类标签有噪声或模棱两可。用一致性过滤后的数据训练 RM,或在 BT 上加温度来校准。
- 异策略问题。 PPO 数据在第一个 epoch 之后略微异策略。像第 08 课那样监控裁剪比例。
使用它
2026 年的 RLHF 是分层的:
| 层 | 目标 | 方法 |
|---|---|---|
| 指令跟随、有帮助性、无害性 | 对齐 | 优先用 DPO(Phase 10 · 08)而非 RLHF-PPO。 |
| 推理正确性(数学、代码) | 能力 | 带验证器奖励的 GRPO(Phase 9 · 12)。 |
| 长时程多步任务 | Agent | 在步骤上用过程奖励模型的 PPO / GRPO。 |
| 安全 / 拒绝行为 | 安全 | 用独立安全 RM 的 RLHF-PPO,或 Constitutional AI。 |
| 推理时 Best-of-N | 快速对齐 | 在解码时使用 RM;无需训练策略。 |
| 奖励蒸馏 | 推理算力 | 在冻结 LM 之上训练一个小「奖励头」。 |
RLHF 是 2022–2024 年那个方法。到了 2026 年,生产对齐 pipeline 以 DPO 优先,只有 RM 密集或安全关键的步骤才用 PPO。
交付它
保存为 outputs/skill-rlhf-architect.md:
markdown---
name: rlhf-architect
description: Design an RLHF / DPO / GRPO alignment pipeline for a language model, including RM, KL, and data strategy.
version: 1.0.0
phase: 9
lesson: 9
tags: [rl, rlhf, alignment, llm]
---
Given a base LM, a target behavior (alignment / reasoning / refusal / agent), and a preference or verifier budget, output:
1. Stage. SFT? RM? DPO? GRPO? With justification.
2. Preference or verifier source. Humans, AI feedback, rule-based, unit-test-pass, or reward distillation.
3. KL strategy. Fixed β, adaptive β, or DPO (implicit KL).
4. Diagnostics. Mean KL, reward stability, over-optimization guard (holdout human eval).
5. Safety gate. Red-team set, refusal rate, safety RM separate from helpfulness RM.
Refuse to ship RLHF-PPO without a KL monitor. Refuse to use an RM smaller than the target policy. Refuse length-only rewards. Flag any pipeline that does not hold back a blind human-eval set as lacking over-optimization protection.练习
- 简单。 在
code/main.py里用 500 组合成偏好对训练 Bradley-Terry 奖励模型。在留出的 100 对上测量成对准确率。应该超过 90%。 - 中等。 用 \beta \in \lbrace 0.0, 0.1, 1.0 \rbrace 跑玩具 PPO-RLHF 循环。对每个值,画出 RM 分数与对参考 KL 随更新次数的变化。哪些运行发生了奖励作弊?
- 困难。 在同一份偏好数据上实现 DPO(闭式偏好似然损失),与 RLHF-PPO pipeline 对比所用算力和最终达到的 RM 分数。
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| RLHF | "对齐 RL" | 三阶段 SFT + RM + PPO pipeline(Christiano 2017,Ouyang 2022)。 |
| Reward Model (RM) | "打分网络" | 通过 Bradley-Terry 拟合到成对偏好的学习标量函数。 |
| Bradley-Terry | "成对逻辑损失" | P(y_+ \succ y_-) = \sigma(R(y_+) - R(y_-));标准的 RM 目标。 |
| KL penalty | "待在参考附近" | 奖励里的 \beta \cdot \mathrm{KL}(\pi_\theta \Vert \pi_{\text{ref}});反奖励作弊的正则项。 |
| Reward hacking | "古德哈特定律" | 策略利用 RM 的缺陷;症状:奖励上升,人类评估持平。 |
| RLAIF | "AI 标注的偏好" | 标签来自另一个 LM 而不是人类的 RLHF。 |
| PRM | "Process Reward Model" | 给部分推理步骤打分;用于推理 pipeline。 |
| Constitutional AI | "Anthropic 的方法" | 由显式规则引导的 AI 生成偏好。 |
延伸阅读
- Christiano et al. (2017). Deep Reinforcement Learning from Human Preferences — 开启 RLHF 的论文。
- Ouyang et al. (2022). InstructGPT — Training language models to follow instructions with human feedback — ChatGPT 背后的配方。
- Stiennon et al. (2020). Learning to summarize with human feedback — 更早的摘要 RLHF。
- Rafailov et al. (2023). Direct Preference Optimization — DPO;2026 年 RLHF 之后的默认选择。
- Bai et al. (2022). Constitutional AI: Harmlessness from AI Feedback — RLAIF 与自我批评循环。
- Anthropic RLHF paper (Bai et al. 2022). Training a Helpful and Harmless Assistant — HH 论文。
- Hugging Face TRL library — 生产级的
RewardTrainer和PPOTrainer。阅读 trainer 源码了解自适应 KL 和价值头的细节。 - Hugging Face — Illustrating Reinforcement Learning from Human Feedback,作者 Lambert、Castricato、von Werra、Havrilla — 配图讲解三阶段 pipeline 的经典文章。
- von Werra et al. (2020). TRL: Transformer Reinforcement Learning — 这个库;
examples/里有 Llama、Mistral 和 Qwen 的端到端 RLHF 脚本。 - Sutton & Barto (2018). Ch. 17.4 — Designing Reward Signals — 奖励假设的视角;思考奖励作弊的必备前提。
示意图共 1 张