问题
你有一个模型已知的 MDP:对任意状态-动作对,你都能查询 P(s' \mid s, a) 和 R(s, a, s')。库存管理者知道需求分布。棋盘游戏具有确定性转移。gridworld 就是四行 Python。你拥有一个模型。
无模型 RL(Q-learning、PPO、REINFORCE)是为没有模型的情形发明的——你只能从环境中采样。但当你确实有模型时,有更快、更好的方法:动态规划。贝尔曼在 1957 年设计了它们。它们至今仍定义着「正确性」:当人们说「这个 MDP 的最优策略」时,指的就是 DP 会返回的策略。
在 2026 年你仍然需要它们,理由有三。第一,RL 研究中的每个表格型环境(GridWorld、FrozenLake、CliffWalking)都用 DP 求解,以产出金标准策略。第二,精确价值让你能调试采样方法:如果 Q-learning 对 V^{\ast}(s_0) 的估计与 DP 答案相差 30%,说明你的 Q-learning 有 bug。第三,现代离线 RL 与规划方法(MCTS、AlphaZero 的搜索、第 9 阶段 · 10 的基于模型的 RL)都在学到的或给定的模型上迭代贝尔曼备份。
概念
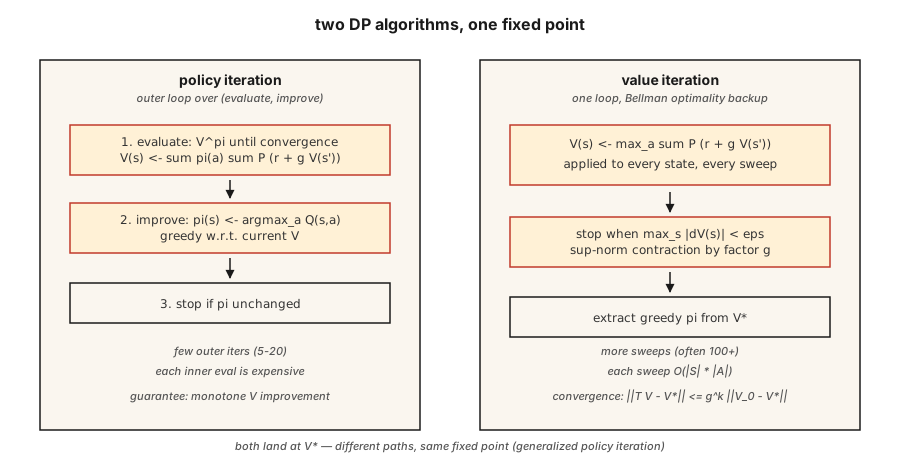
两个算法,都是贝尔曼方程上的定点迭代。
策略迭代。 交替执行两步,直到策略不再变化。
- 评估: 给定策略 \pi,反复应用 V(s) \leftarrow \sum_a \pi(a \mid s) \sum_{s',r} P(s',r \mid s,a) [r + \gamma V(s')] 直到收敛,算出 V^\pi。
- 改进: 给定 V^\pi,让 \pi 关于 V^\pi 贪心:\pi(s) \leftarrow \arg\max_a \sum_{s',r} P(s',r \mid s,a) [r + \gamma V(s')]。
收敛有保证,因为 (a) 每次改进要么保持 \pi 不变,要么在某些状态上严格提高 V^\pi;(b) 确定性策略空间有限。即使状态空间很大,通常也只需约 5–20 次外层迭代。
价值迭代。 把评估与改进合并成一次扫描。应用贝尔曼最优性方程:
重复直到 \max_s \lvert V_{\text{new}}(s) - V(s) \rvert < \epsilon。结束时取贪心动作得到策略。每次迭代严格更快——没有内层评估循环——但通常需要更多迭代才能收敛。
广义策略迭代(GPI)。 统一的框架。价值函数与策略锁在一个双向改进循环中;任何把两者推向相互一致的方法(异步价值迭代、修正策略迭代、Q-learning、actor-critic、PPO)都是 GPI 的实例。
为什么 \gamma < 1 很重要。 贝尔曼算子在 sup 范数下是 \gamma-压缩:\lVert T V - T V' \rVert_\infty \le \gamma \lVert V - V' \rVert_\infty。压缩意味着唯一不动点与几何收敛。丢掉 \gamma < 1,保证就没了——你需要有限视野或吸收终态。
构建它
第 1 步:构建 GridWorld 的 MDP 模型
沿用第 01 课的 4×4 GridWorld。我们加入一个随机变体:以概率 0.1,Agent 会滑向随机的垂直方向。
pythonSLIP = 0.1
def transitions(state, action):
if state == TERMINAL:
return [(state, 0.0, 1.0)]
outcomes = []
for direction, prob in action_probs(action):
outcomes.append((apply_move(state, direction), -1.0, prob))
return outcomestransitions(s, a) 返回 (s', r, p) 的列表。这就是整个模型。
第 2 步:策略评估
给定策略 π(s) = {action: prob},迭代贝尔曼方程直到 V 不再变化:
pythondef policy_evaluation(policy, gamma=0.99, tol=1e-6):
V = {s: 0.0 for s in states()}
while True:
delta = 0.0
for s in states():
v = sum(pi_a * sum(p * (r + gamma * V[s_prime])
for s_prime, r, p in transitions(s, a))
for a, pi_a in policy(s).items())
delta = max(delta, abs(v - V[s]))
V[s] = v
if delta < tol:
return V第 3 步:策略改进
把 \pi 替换为关于 V 的贪心策略。如果 \pi 没有变化,就返回——我们已到最优。
pythondef policy_improvement(V, gamma=0.99):
new_policy = {}
for s in states():
best_a = max(
ACTIONS,
key=lambda a: sum(p * (r + gamma * V[s_prime])
for s_prime, r, p in transitions(s, a)),
)
new_policy[s] = best_a
return new_policy第 4 步:把它们串起来
pythondef policy_iteration(gamma=0.99):
policy = {s: "up" for s in states()} # arbitrary start
for _ in range(100):
V = policy_evaluation(lambda s: {policy[s]: 1.0}, gamma)
new_policy = policy_improvement(V, gamma)
if new_policy == policy:
return V, policy
policy = new_policy4×4 上的典型收敛:4–6 次外层迭代。输出 V^{\ast}(0,0) \approx -6,以及一个严格减少步数的策略。
第 5 步:价值迭代(单循环版本)
pythondef value_iteration(gamma=0.99, tol=1e-6):
V = {s: 0.0 for s in states()}
while True:
delta = 0.0
for s in states():
v = max(sum(p * (r + gamma * V[s_prime])
for s_prime, r, p in transitions(s, a))
for a in ACTIONS)
delta = max(delta, abs(v - V[s]))
V[s] = v
if delta < tol:
break
policy = policy_improvement(V, gamma)
return V, policy同一个不动点,更少的代码行。
常见陷阱
- 忘记处理终态。 如果对吸收态也套用贝尔曼方程,它仍会选出一个「最佳动作」,而该动作什么都不改变。用
if s == terminal: V[s] = 0保护。 - Sup 范数 vs L2 收敛。 用
max |V_new - V|,而不是平均值。理论保证建立在 sup 范数上。 - 原地更新 vs 同步更新。 原地更新
V[s](Gauss-Seidel)比使用单独的V_new字典(Jacobi)收敛更快。生产代码用原地更新。 - 策略平局。 如果两个动作的 Q 值相等,
argmax可能在每次迭代中打破平局的方式不同,导致「策略稳定」检查来回振荡。使用稳定的平局规则(固定顺序中的第一个动作)。 - 状态空间爆炸。 DP 每次扫描是 O(\lvert S \rvert \cdot \lvert A \rvert)。可处理到约 10⁷ 个状态。再大就需要函数逼近(从第 9 阶段 · 05 开始)。
使用它
2026 年,DP 是正确性基线,也是规划器的内层循环:
| 用例 | 方法 |
|---|---|
| 精确求解小型表格 MDP | 价值迭代(更简单)或策略迭代(外层步数更少) |
| 验证 Q-learning / PPO 实现 | 在玩具环境上与 DP 最优的 V^{\ast} 对比 |
| 基于模型的 RL(第 9 阶段 · 10) | 在学到的转移模型上做贝尔曼备份 |
| AlphaZero / MuZero 中的规划 | 蒙特卡洛树搜索 = 异步贝尔曼备份 |
| 离线 RL(CQL、IQL) | 保守 Q 迭代——对 OOD 动作加惩罚的 DP |
每当有人说「最优价值函数」,他们指的就是「DP 的不动点」。论文里看到 V^{\ast} 或 Q^{\ast} 时,脑海里就浮现这个循环。
交付它
保存为 outputs/skill-dp-solver.md:
markdown---
name: dp-solver
description: Solve a small tabular MDP exactly via policy iteration or value iteration. Report convergence behavior.
version: 1.0.0
phase: 9
lesson: 2
tags: [rl, dynamic-programming, bellman]
---
Given an MDP with a known model, output:
1. Choice. Policy iteration vs value iteration. Reason tied to |S|, |A|, γ.
2. Initialization. V_0, starting policy. Convergence sensitivity.
3. Stopping. Sup-norm tolerance ε. Expected number of sweeps.
4. Verification. V*(s_0) computed exactly. Greedy policy extracted.
5. Use. How this baseline will be used to debug/evaluate sampling-based methods.
Refuse to run DP on state spaces > 10⁷. Refuse to claim convergence without a sup-norm check. Flag any γ ≥ 1 on an infinite-horizon task as a guarantee violation.练习
- 简单。 在 4×4 GridWorld 上用 \gamma \in \lbrace 0.9, 0.99 \rbrace 运行价值迭代。直到 \max \lvert \Delta V \rvert < 10^{-6} 需要多少次扫描?把 V^{\ast} 打印成 4×4 网格。
- 中等。 在随机 GridWorld(滑动概率
0.1)上比较策略迭代与价值迭代。统计:扫描次数、实际耗时、最终 V^{\ast}(0,0)。谁在迭代次数上收敛更快?在实际耗时上呢? - 困难。 实现修正策略迭代:评估步骤只运行 k 次扫描,而不是跑到收敛。对 k \in \lbrace 1, 2, 5, 10, 50 \rbrace 画出 V^{\ast}(0,0) 误差随 k 变化的曲线。这条曲线说明了评估与改进之间的什么权衡?
关键术语
| 术语 | 常被怎么说 | 实际含义 |
|---|---|---|
| Policy iteration | 「DP 算法」 | 交替执行评估(V^\pi)与改进(关于 V^\pi 的贪心 \pi),直到策略不再变化。 |
| Value iteration | 「更快的 DP」 | 一次扫描中应用贝尔曼最优性备份;几何收敛到 V^{\ast}。 |
| Bellman operator | 「那个递推」 | (T V)(s) = \max_a \sum P (r + \gamma V(s'));在 sup 范数下是 \gamma-压缩。 |
| Contraction | 「DP 为什么收敛」 | 任何算子 T,只要满足 \lVert T x - T y \rVert \le \gamma \lVert x - y \rVert,都有唯一不动点。 |
| GPI | 「一切都是 DP」 | 广义策略迭代:任何把 V 与 \pi 推向相互一致的方法。 |
| Synchronous update | 「Jacobi 式」 | 一次扫描中始终使用旧的 V;便于分析但更慢。 |
| In-place update | 「Gauss-Seidel 式」 | 边更新边使用 V;实践中收敛更快。 |
延伸阅读
- Sutton & Barto (2018). Ch. 4 — Dynamic Programming —— 策略迭代与价值迭代的经典讲述。
- Bertsekas (2019). Reinforcement Learning and Optimal Control —— 对压缩映射论证的严谨处理。
- Puterman (2005). Markov Decision Processes —— 修正策略迭代及其收敛分析。
- Howard (1960). Dynamic Programming and Markov Processes —— 策略迭代的原始论文。
- Bertsekas & Tsitsiklis (1996). Neuro-Dynamic Programming —— 从 DP 到近似 DP / 深度 RL 的桥梁,后续每一课都会用到。
示意图共 1 张