问题
VAE 的样本模糊,因为它的 MSE 解码损失对均值图像是贝叶斯最优的——而许多可能数字的均值就是一个模糊的数字。你想要一个奖励合理性的损失,而不是奖励与某个目标逐像素接近。合理性没有闭式表达。你必须把它学出来。
Goodfellow 的想法:训练一个分类器 D(x) 区分真实图像和假图像。训练一个生成器 G(z) 去骗过 D。给 G 的损失信号,就是 D 当前认为「什么让东西看起来像真的」。这个信号随 G 的改进而更新,追着一个移动的目标跑。如果两个网络都收敛,G 就在从未写出 log p(x) 的情况下学会了数据分布。
这就是对抗训练。数学上是一个极小极大博弈:
2026 年,GAN 已不再是 SOTA 生成器(扩散和流匹配抢走了那顶王冠)。但 StyleGAN 2/3 仍是有史以来交付的最锐利人脸模型,GAN 判别器被用作扩散训练中的感知损失,对抗训练还驱动着快速的单步蒸馏(SDXL-Turbo、SD3-Turbo、LCM),让你能上线实时扩散。
概念
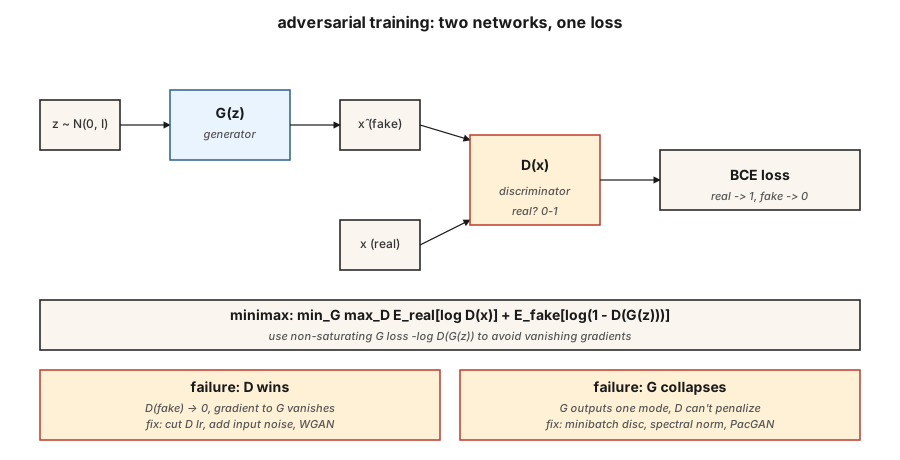
生成器 G(z)。 把噪声向量 z \sim \mathcal{N}(0, I) 映射成样本 \hat{x}。一个解码器形状的网络(全连接或转置卷积)。
判别器 D(x)。 把样本映射成一个标量概率(或分数)。真 → 1,假 → 0。
损失。 两次交替更新:
- 训练 D: \text{loss}_D = -[ \log D(x) + \log(1 - D(G(z))) ]。真实=1、虚假=0 的二元交叉熵。
- 训练 G: \text{loss}_G = -\log D(G(z))。这是 Goodfellow 使用的非饱和形式(原始的 \log(1 - D(G(z))) 在 D 自信时会饱和,把梯度杀掉)。
训练循环。 一步 D,一步 G。重复。
为什么有效。 如果 G 完美匹配 p_{\text{data}},那么 D 无法做得比随机猜更好,处处输出 0.5;G 再也拿不到梯度。达到均衡。
为什么会崩。 模式崩溃(G 找到一个 D 分不出来的模式,然后永远只造它)、梯度消失(D 学得太快,\log D 饱和)、训练不稳定(学习率、batch size,什么都可能)。
让 GAN 真正可用的变体
| 年份 | 创新 | 修复了什么 |
|---|---|---|
| 2015 | DCGAN | 卷积/反卷积、batch norm、LeakyReLU——首个稳定的架构。 |
| 2017 | WGAN、WGAN-GP | 用 Wasserstein 距离 + 梯度惩罚替代 BCE。修复梯度消失。 |
| 2017 | 谱归一化 | 对判别器做 Lipschitz 约束。2026 年的判别器仍在用。 |
| 2018 | Progressive GAN | 先训低分辨率,再逐层添加。首批百万像素结果。 |
| 2019 | StyleGAN / StyleGAN2 | 映射网络 + 自适应实例归一化。固定领域逼真度的 SOTA。 |
| 2021 | StyleGAN3 | 无混叠、平移等变——2026 年仍是人脸的黄金标准。 |
| 2022 | StyleGAN-XL | 条件式、类别感知、更大规模。 |
| 2024 | R3GAN | 以更强的正则化重新出发;在 1024² 上无需额外技巧即可工作。 |
构建它
code/main.py 在一维数据上训练一个迷你 GAN:两个高斯组成的混合。生成器和判别器都是单隐藏层 MLP。我们手写前向、反向和极小极大循环。目标是亲眼看到两种关键失效模式(模式崩溃 + 梯度消失)发生。
第 1 步:非饱和损失
原始的 Goodfellow 损失 \log(1 - D(G(z))) 在 D 以高置信度把 G 的假样本判为假时趋近 0。此时 G 的梯度基本为零——G 无法改进。非饱和形式 -\log D(G(z)) 的渐近行为相反:当 D 自信时它会爆炸,给 G 一个强信号。
pythondef g_loss(d_fake):
# maximize log D(G(z)) <=> minimize -log D(G(z))
return -sum(math.log(max(p, 1e-8)) for p in d_fake) / len(d_fake)第 2 步:每个生成器步配一个判别器步
pythonfor step in range(steps):
# train D
real_batch = sample_real(batch_size)
fake_batch = [G(z) for z in sample_noise(batch_size)]
update_D(real_batch, fake_batch)
# train G
fake_batch = [G(z) for z in sample_noise(batch_size)] # fresh fakes
update_G(fake_batch)给 G 用新鲜的假样本,否则梯度会陈旧。
第 3 步:留意模式崩溃
pythonif step % 200 == 0:
samples = [G(z) for z in sample_noise(500)]
mode_a = sum(1 for s in samples if s < 0)
mode_b = 500 - mode_a
if min(mode_a, mode_b) < 50:
print(" [!] mode collapse: one mode is starved")典型症状:两个真实模式中的一个不再被生成。判别器不再纠正它,因为它从未作为假样本出现过。
常见陷阱
- 判别器太强。 把 D 的学习率降到 1/2 到 1/5,或者加实例噪声/层噪声。如果 D 的准确率超过 95%,G 就死了。
- 生成器记住了一个模式。 给 D 的输入加噪声,使用 minibatch discrimination 层,或改用 WGAN-GP。
- Batch norm 泄露统计量。 真实 batch 和假 batch 流过同一个 BN 层会混合它们的统计量。改用 instance norm 或谱归一化。
- 刷 Inception score。 FID 和 IS 在样本数少时噪声很大。评估时至少用 1 万个样本。
- 对条件任务来说,单次采样是个谎言。 你仍然需要 CFG 尺度、截断技巧和重采样,才能得到可用的输出。
使用它
2026 年的 GAN 技术栈:
| 场景 | 选择 |
|---|---|
| 逼真的人脸,固定姿态 | StyleGAN3(最锐利、最小) |
| 动漫 / 风格化人脸 | StyleGAN-XL 或 Stable Diffusion LoRA |
| 图生图翻译 | Pix2Pix / CycleGAN(第 8 阶段 · 04)或 ControlNet(第 8 阶段 · 08) |
| 快速单步文生图 | 扩散的对抗蒸馏(SDXL-Turbo、SD3-Turbo) |
| 扩散训练器内部的感知损失 | 在图像裁剪块上的小 GAN 判别器 |
| 任何多模态、开放式任务 | 不要用——改用扩散或流匹配 |
GAN 锋利但狭窄。一旦你的领域变宽——照片、任意文本提示、视频——就换扩散。对抗技巧作为组件(感知损失、蒸馏)继续存在,而不是作为独立的生成器。
交付它
保存 outputs/skill-gan-debugger.md。Skill 接收一次失败的 GAN 训练(损失曲线、样本网格、数据集大小),输出按可能性排序的原因列表、一行修复方案,以及重跑协议。
练习
- 简单。 用默认设置运行
code/main.py。然后把D_LR = 5 * G_LR再跑一次。G 的损失多快坍缩成一个常数? - 中等。 把 Goodfellow BCE 损失换成 WGAN 损失:\text{loss}_D = \mathbb{E}[D(\text{fake})] - \mathbb{E}[D(\text{real})],\text{loss}_G = -\mathbb{E}[D(\text{fake})],并把 D 的权重裁剪到
[-0.01, 0.01]。训练更稳定吗?比较实际耗时下的收敛速度。 - 困难。 把一维例子扩展到二维数据(圆环上的 8 个高斯混合)。追踪生成器在第 1k、5k、10k 步时捕捉到 8 个模式中的几个。实现 minibatch discrimination 并重新测量。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Generator | 「G」 | 从噪声到样本的网络,G: z → x̂。 |
| Discriminator | 「D」 | 分类器 D: x → [0, 1],真 vs 假。 |
| Minimax | 「那个博弈」 | 对一个联合目标做 \min_G \max_D。 |
| Non-saturating loss | 「那个修复」 | G 用 -\log D(G(z)) 代替 \log(1 - D(G(z)))。 |
| Mode collapse | 「G 只记住了一个东西」 | 尽管数据多样,生成器只产出少数几种不同输出。 |
| WGAN | 「Wasserstein」 | 用 Earth-Mover 距离 + 梯度惩罚替代 BCE;梯度更平滑。 |
| Spectral norm | 「Lipschitz 技巧」 | 约束 D 的权重范数以限制其斜率;稳定训练。 |
| StyleGAN | 「那个能用的」 | 映射网络 + AdaIN;人脸领域同类最佳,2026 年仍是。 |
生产说明:单次推理是 GAN 持久的优势
在开放域生成上,GAN 已不再以样本质量取胜,但在推理成本上仍然赢。用生产推理文献的词汇来说,一个 GAN 具有:
- 没有 prefill,没有 decode 阶段。 只有一次 G(z) 前向传播。TTFT ≈ 总延迟。
- 没有 KV-cache 压力。 唯一的状态是权重。batch size 受激活内存约束,而非缓存。
- 极易做 continuous batching。 因为每个请求的 FLOPs 固定,按服务器目标占用率做静态 batch 通常就是最优的。不需要在途调度器。
这就是为什么 GAN 蒸馏(SDXL-Turbo、SD3-Turbo、ADD、LCM)是 2026 年快速文生图的主导技术:它把 20-50 步的扩散 pipeline 压缩成 1-4 次 GAN 式前向传播,同时保持扩散基座的分布。对抗损失作为训练期旋钮活了下来,用来把慢生成器变成快生成器。
延伸阅读
- Goodfellow 等(2014)。Generative Adversarial Nets — GAN 原始论文。
- Radford 等(2015)。Unsupervised Representation Learning with DCGAN — 首个稳定架构。
- Arjovsky, Chintala, Bottou(2017)。Wasserstein GAN — WGAN。
- Miyato 等(2018)。Spectral Normalization for GANs — SN。
- Karras 等(2020)。Analyzing and Improving the Image Quality of StyleGAN — StyleGAN2。
- Karras 等(2021)。Alias-Free Generative Adversarial Networks — StyleGAN3。
- Sauer 等(2023)。Adversarial Diffusion Distillation — SDXL-Turbo。
示意图共 1 张