问题
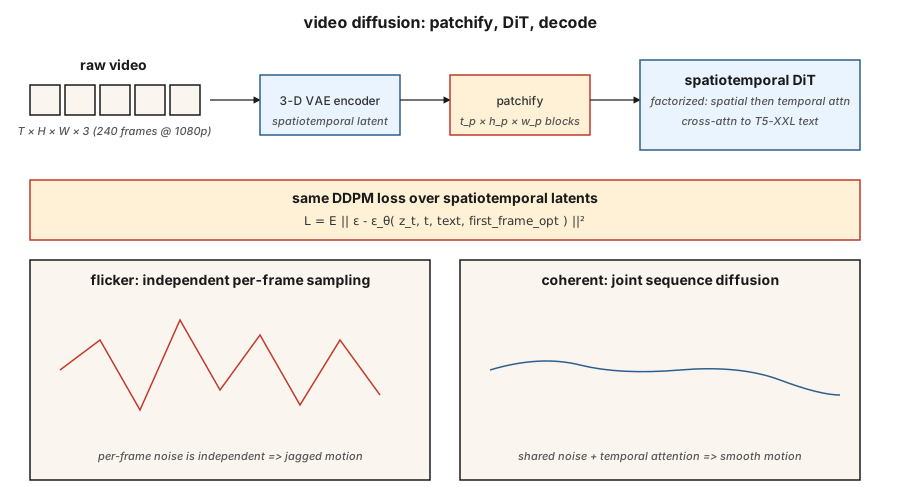
一段 24fps 的 10 秒 1080p 视频是 240 帧、每帧 1920×1080×3 像素。每段视频约 1.5 GB 原始数据。像素空间扩散不可行。你需要:
- 时空压缩。 一个编码整段视频(而非单帧)的 VAE,把视频编码成时空 patch 序列。
- 时间连贯性。 各帧需要在数秒内共享内容、光照和物体身份。网络必须对运动建模。
- 算力预算。 在相同模型规模下,视频训练比图像贵 10-100 倍。
- 条件。 文本、图像(首帧)、音频或另一段视频。大多数生产模型四种都接受。
解决这个问题的架构是应用于时空 patch 的 Diffusion Transformer(DiT),在海量 (prompt, caption, video) 数据集上训练。扩散损失与第六课相同。
概念
Patchify(patch 化)
用 3D VAE(学习到的时空压缩)编码视频。潜变量形状为 [T_latent, H_latent, W_latent, C_latent]。切分成大小为 [t_p, h_p, w_p] 的 patch。对于 Sora 风格的模型,t_p = 1(逐帧 patch)或 t_p = 2(每两帧一个 patch)。一段 10 秒 1080p 视频压缩后约 20,000-100,000 个 patch。
时空 DiT
Transformer 处理展平后的 patch 序列。每个 patch 带一个 3D 位置 embedding(时间 + y + x)。注意力通常被分解:
- 每帧内部 patch 的空间注意力。
- 同一空间位置上跨帧的时间注意力。
- 完整 3D 注意力贵 16-100 倍;只用于低分辨率或研究场景。
文本条件
与大型文本编码器做交叉注意力(Sora 用 T5-XXL,CogVideoX-5B 也用 T5-XXL)。长 prompt 很重要——Sora 的训练集包含 GPT 生成的密集重描述,平均每段 200 个 token。
训练
在时空潜变量上用标准扩散损失(ε 或 v 预测)。数据:网络视频 + 约 1 亿条精选片段 + 合成文本描述。算力:即使小规模研究运行也要 10,000+ GPU 小时;Sora 规模则是 100,000+。
2026 年的生产格局
| 模型 | 时间 | 最长时长 | 最高分辨率 | 开放权重? | 亮点 |
|---|---|---|---|---|---|
| Sora(OpenAI) | 2024-02 | 60s | 1080p | 否 | 首个在大规模上展现世界模拟器特性的模型 |
| Sora Turbo | 2024-12 | 20s | 1080p | 否 | 生产版 Sora,推理快 5 倍 |
| Veo 2(Google) | 2024-12 | 8s | 4K | 否 | 2025 年质量与物理表现最佳 |
| Veo 3 | 2025 Q3 | 15s | 4K | 否 | 原生音频与更强的镜头控制 |
| Kling 1.5 / 2.1(快手) | 2024-2025 | 10s | 1080p | 否 | 2025 Q1 人物运动最佳 |
| Runway Gen-3 Alpha | 2024-06 | 10s | 768p | 否 | 上层有专业视频工具 |
| Pika 2.0 | 2024-10 | 5s | 1080p | 否 | 角色一致性最强 |
| CogVideoX(THUDM) | 2024 | 10s | 720p | 是(2B、5B) | 首个开放 5B 级视频模型 |
| HunyuanVideo(腾讯) | 2024-12 | 5s | 720p | 是(13B) | 2024 年末开放 SOTA |
| Mochi-1(Genmo) | 2024-10 | 5.4s | 480p | 是(10B) | 许可证最宽松 |
| WAN 2.2(阿里巴巴) | 2025-07 | 5s | 720p | 是 | 2025 年中开放模型最强 |
开放权重追赶的速度比图像领域更快:到 2026 年中,HunyuanVideo + WAN 2.2 LoRA 已经支撑起大多数开源工作流。
构建它
code/main.py 模拟时空 DiT 的核心思想:把一段小的合成视频 patch 化,为每个 patch 添加位置 embedding,再用 Transformer 风格的 patch 间注意力对整个序列去噪。不用 numpy,纯 Python。我们展示:即使在 1 维情形下,只要相邻帧的 patch 共享同一个去噪器和位置 embedding,时间连贯性就会自然出现。
第 1 步:把合成的 1 维「视频」patch 化
pythondef make_video(T_frames=8, rng=None):
# a "video" is a sequence of 1-D values following a smooth trajectory
base = rng.gauss(0, 1)
return [base + 0.3 * t + rng.gauss(0, 0.1) for t in range(T_frames)]第 2 步:每帧的位置 embedding
pythondef pos_embed(t, dim):
return sinusoidal(t, dim)第 3 步:去噪器看到整个序列
我们的微型网络不逐帧独立去噪,而是把所有帧的值 + 它们的位置 embedding 拼接起来,联合预测所有帧的噪声。
第 4 步:时间连贯性测试
训练后采样一段视频,测量帧间差值。如果模型学到了时间结构,差值会小于逐帧独立采样的结果。
常见陷阱
- 逐帧独立采样 = 闪烁。 如果对每一帧单独跑图像扩散,输出会闪烁,因为每帧的噪声相互独立。视频扩散通过注意力或共享噪声把帧耦合起来,从而解决这个问题。
- 朴素 3D 注意力 = 显存不足。 在 10 秒 1080p 潜变量上做完整 3D 注意力是数千亿次运算。要分解为空间 + 时间。
- 数据描述比数据量更重要。 Sora 相比先前工作的主要升级,是在详细程度约 10 倍的描述上训练(用 GPT-4 重新标注片段)。OpenAI 的技术报告对此说得很明确。
- 首帧条件。 大多数生产模型也接受一张图像作为首帧。这就是「图生视频」模式;训练包含这个变体。
- 物理漂移。 长片段(>10s)会累积细微的不一致。滑动窗口生成 + 关键帧锚定会有帮助。
使用它
| 用例 | 2026 年的选择 |
|---|---|
| 最高质量文生视频,托管 | Veo 3 或 Sora |
| 镜头可控的电影感 | Runway Gen-3 配 motion brush |
| 跨片段的角色一致性 | Pika 2.0 或 Kling 2.1 |
| 开放权重,快速微调 | WAN 2.2 + LoRA |
| 图生视频 | WAN 2.2-I2V、Kling 2.1 I2V 或 Runway |
| 音频驱动的口型同步 | Veo 3(原生音频)或专用口型同步模型 |
| 视频编辑 | Runway Act-Two、Kling Motion Brush、Flux-Kontext(静帧) |
在同等质量下,每秒视频的成本在 2024 到 2026 年间下降了 20 倍。
交付它
保存 outputs/skill-video-brief.md。这个 skill 接收视频简报(时长、宽高比、风格、镜头计划、主体一致性、音频),输出:模型 + 托管方案、prompt 脚手架(镜头语言、主体描述、运动描述词)、seed + 可复现协议,以及逐帧 QA 清单。
练习
- 简单。 在
code/main.py中,比较(a)逐帧独立采样和(b)整段序列联合采样的帧间差值。报告差值的均值和方差。 - 中等。 加入首帧条件:把第 0 帧固定为给定值,采样其余帧。测量被固定的值如何传播。
- 困难。 用 HuggingFace diffusers 在本地 GPU 上运行 CogVideoX-2B。为 6 秒片段在 720p 下计时 20 个推理步骤。对时空注意力做性能剖析,找出瓶颈。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| 视频 VAE | 「3-D VAE」 | 把 (T, H, W, C) 压缩成时空潜变量的编码器。 |
| Patch | 「token」 | 潜变量中固定大小的 3D 块;DiT 的输入。 |
| 分解注意力 | 「空间 + 时间」 | 先在空间上做注意力,再在时间上做;跳过完整 3D 注意力。 |
| 图生视频(I2V) | 「让这张照片动起来」 | 模型接收图像 + 文本,输出以它为起点的视频。 |
| 关键帧条件 | 「锚定帧」 | 固定特定帧来控制视频的发展轨迹。 |
| Motion brush | 「方向提示」 | 用户在图像上绘制运动矢量的 UI 输入。 |
| 重新描述(Re-captioning) | 「密集描述」 | 用 LLM 为训练片段重新标注详细 prompt。 |
| 闪烁(Flicker) | 「时间伪影」 | 帧与帧之间的不一致;靠耦合去噪解决。 |
生产笔记:视频潜变量是内存带宽问题
一段 24 fps 的 10 秒 1080p 片段是 240 帧 × 1920 × 1080 × 3 ≈ 1.5 GB 原始像素。经过 4× 视频 VAE 压缩(2 × 空间 × 2 × 时间)后,每个请求的潜变量约 100 MB。以 batch 1 在时空 DiT 上跑 30 步,每步要在 HBM 中搬运约 3 GB——瓶颈是内存带宽,而不是 FLOPs。
三个生产调节旋钮,都直接来自生产推理文献的推理章节:
- 在 DiT 上做 TP。 文生视频模型通常 ≥10B 参数。跨 4 张 H100 做 TP=4 是标准做法;405B 级模型用 PP=2 × TP=2。每步延迟随 TP 大致线性下降,直到撞上 all-reduce 瓶颈。
- 帧批处理 = 连续批处理。 生成时,视频在概念上是由注意力连接的帧 batch。连续批处理(在途调度)适用:如果模型架构支持滑动窗口生成,就在返回第
t-1帧的同时开始渲染第t+1帧。 - 片段级 prefill 缓存。 对于图生视频,首帧条件类似于 LLM 的 prompt prefill:只算一次,在时间解码器的多次传递中复用。这实际上就是视频的 KV cache。
延伸阅读
- Brooks et al. (2024). Video generation models as world simulators——Sora 技术报告。
- Yang et al. (2024). CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer——CogVideoX。
- Kong et al. (2024). HunyuanVideo: A Systematic Framework for Large Video Generative Models——HunyuanVideo。
- Genmo (2024). Mochi 1 preview model card——Mochi-1。
- Alibaba (2025). WAN 2.2——2025 年中的开放 SOTA。
- Ho, Salimans, Gritsenko et al. (2022). Video Diffusion Models——视频扩散的开创性论文。
- Blattmann et al. (2023). Align your Latents (Video LDM)——Stable Video Diffusion 的前身。
示意图共 1 张