问题
客户发来一张完美的产品照片,背景里却有个碍眼的招牌。你想抹掉招牌,其余部分保持像素级不变。你不能直接跑文生图——结果会颜色不同、光照不同、产品角度也不同。你只想重新生成被遮罩的区域,并且让生成结果尊重周围的上下文。
这就是图像修复。变体包括:
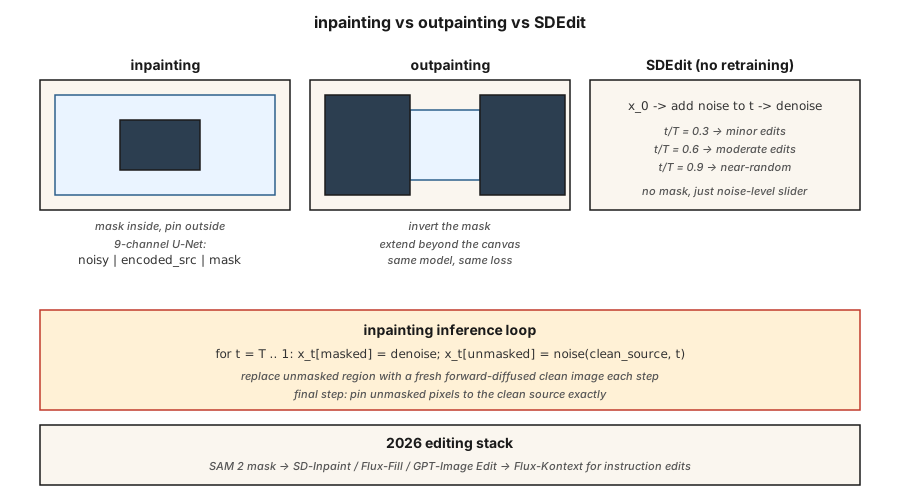
- 图像修复(inpainting)。 在遮罩内部重新生成,保留外部像素。
- 图像外扩(outpainting)。 在遮罩外部(或画布之外)重新生成,保留内部。
- 图像编辑。 重新生成整张图,但保持与原图的语义或结构保真(SDEdit、InstructPix2Pix)。
2026 年每个扩散 pipeline 都带图像修复模式。Flux.1-Fill、Stable Diffusion Inpaint、SDXL-Inpaint、DALL-E 3 Edit。它们的原理相同。
概念
朴素做法(以及它为什么不对)
在带遮罩的情况下跑标准的文生图。在每个采样步骤,把噪声潜变量中未遮罩的区域替换为干净图像正向扩散后的版本。它能跑通……但效果很差。边界伪影会渗进来,因为模型对遮罩区域内的内容一无所知。
正确的图像修复模型
训练一个修改过的 U-Net,输入 9 个通道而不是 4 个:
input = concat([ noisy_latent (4ch), encoded_image (4ch), mask (1ch) ], dim=channel)多出的通道是 VAE 编码后的源图像副本加上一个单通道遮罩。训练时,随机遮罩图像中的区域,训练模型只对遮罩区域去噪,而未遮罩区域作为干净的条件信号给出。推理时,模型能「看到」遮罩区域周围的内容,从而生成连贯的补全。
SD-Inpaint、SDXL-Inpaint、Flux-Fill 都使用这种 9 通道(或类似)输入。diffusers 中对应 StableDiffusionInpaintPipeline、FluxFillPipeline。
SDEdit(Meng 等,2022)——免训练编辑
对源图像加噪到某个中间时刻 t,然后用新的 prompt 从 t 反向跑到 0。无需重新训练。起始 t 的选择是在保真度与创作自由之间做权衡:
t/T = 0.3→ 与源图几乎一致,只有轻微的风格变化t/T = 0.6→ 中等编辑,保留粗粒度结构t/T = 0.9→ 几乎从噪声生成,源图保留极少
InstructPix2Pix(Brooks 等,2023)
在 (input_image, instruction, output_image) 三元组上微调扩散模型。推理时同时以输入图像和文本指令(「变成日落」「加一条龙」)为条件。有两个 CFG 缩放:图像缩放和文本缩放。
RePaint(Lugmayr 等,2022)
保留标准的无条件扩散模型。在每个反向步骤重采样——偶尔跳回更嘈杂的状态重新生成。这样能避免边界伪影。适用于没有训练好的图像修复模型的情况。
构建它
code/main.py 在 5 维数据上实现一个玩具版一维图像修复方案。我们在 5 维混合数据上训练 DDPM,每个样本是来自两个聚类之一的 5 个浮点数。推理时,我们「遮罩」5 个维度中的 2 个,在每一步注入未遮罩的 3 维的正向加噪版本,只重新生成被遮罩的维度。
第 1 步:5 维 DDPM 数据
pythondef sample_data(rng):
cluster = rng.choice([0, 1])
center = [-1.0] * 5 if cluster == 0 else [1.0] * 5
return [c + rng.gauss(0, 0.2) for c in center], cluster第 2 步:在全部 5 维上训练去噪器
标准 DDPM。网络为 5 维噪声输入输出 5 维噪声预测。
第 3 步:推理时的遮罩感知反向过程
pythondef inpaint_step(x_t, mask, clean_image, alpha_bars, t, rng):
# replace unmasked dims with a freshly noised version of the clean source
a_bar = alpha_bars[t]
for i in range(len(x_t)):
if not mask[i]:
x_t[i] = math.sqrt(a_bar) * clean_image[i] + math.sqrt(1 - a_bar) * rng.gauss(0, 1)
# ...then run the normal reverse step on x_t这是朴素做法,在一维玩具数据上能跑通。真实的图像修复使用 9 通道输入,因为纹理连贯性更重要。
第 4 步:图像外扩
图像外扩就是把遮罩反过来做图像修复:遮罩新的(原本不存在的)画布区域,其余部分填入原图。训练目标完全相同。
常见陷阱
- 接缝。 朴素做法会留下可见边界,因为梯度信息无法跨越遮罩流动。修复方法:把遮罩膨胀 8-16 像素,或者使用真正的图像修复模型。
- 遮罩泄漏。 如果条件图像的未遮罩区域质量差或噪声大,会污染遮罩内部的生成。先做轻度去噪或模糊。
- CFG 与遮罩大小相互影响。 小遮罩上使用高 CFG = 过饱和的补丁。小幅编辑要降低 CFG。
- SDEdit 的保真悬崖。 从
t/T = 0.5走到t/T = 0.6可能丢失主体的身份特征。要扫描参数并设 checkpoint。 - Prompt 不匹配。 prompt 应描述整张图像,而不只是新内容。写「一只猫坐在椅子上」,而不是「一只猫」。
使用它
| 任务 | Pipeline |
|---|---|
| 移除物体,小遮罩 | SD-Inpaint 或 Flux-Fill,标准 prompt |
| 替换天空 | SD-Inpaint + 「日落时的蓝天」 |
| 扩展画布 | SDXL 外扩模式(8px 羽化)或带外扩遮罩的 Flux-Fill |
| 重新生成手 / 脸 | SD-Inpaint,prompt 重新描述主体 + ControlNet-Openpose |
| 改变某区域的风格 | 在遮罩区域上用 t/T=0.5 的 SDEdit |
| 「变成日落」 | InstructPix2Pix 或 Flux-Kontext |
| 背景替换 | SAM 遮罩 → SD-Inpaint |
| 超高保真 | 最难的情况用 Flux-Fill 或 GPT-Image(托管) |
SAM(Meta 的 Segment Anything,2023)+ 扩散修复是 2026 年的背景移除 pipeline。SAM 2(2024)支持视频。
交付它
保存 outputs/skill-editing-pipeline.md。这个 skill 接收原图 + 编辑描述 + 可选遮罩(或 SAM prompt),输出:遮罩生成方式、基础模型、CFG 缩放(图像 + 文本)、SDEdit 的 t 值或图像修复模式,以及 QA 清单。
练习
- 简单。 在
code/main.py中,把被遮罩维度的比例从 0.2 变到 0.8。在什么比例下,修复质量(遮罩维度的残差)等同于无条件生成? - 中等。 实现 RePaint:每 10 个反向步骤,回跳 5 步(加噪)再重新去噪。测量它是否降低遮罩边缘的边界残差。
- 困难。 用 Hugging Face diffusers 对比:在 20 个人脸重生成任务上,SD 1.5 Inpaint + ControlNet-Openpose 与 Flux.1-Fill。分别给姿态遵循度和身份保持度打分。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| 图像修复 | 「填洞」 | 在遮罩内部重新生成;保留外部像素。 |
| 图像外扩 | 「扩展画布」 | 在画布之外重新生成;保留内部。 |
| 9 通道 U-Net | 「真正的修复模型」 | 以 noisy | encoded-source | mask 为输入的 U-Net。 |
| SDEdit | 「带噪声水平的图生图」 | 加噪到时刻 t,用新 prompt 去噪。 |
| InstructPix2Pix | 「纯文本编辑」 | 在 (image, instruction, output) 三元组上微调的扩散模型。 |
| RePaint | 「免重训练」 | 反向过程中周期性重新加噪以减少接缝。 |
| SAM | 「Segment Anything」 | 通过点击或框生成遮罩;与修复配合使用。 |
| Flux-Kontext | 「带上下文编辑」 | 接受参考图 + 指令做编辑的 Flux 变体。 |
生产笔记:编辑 pipeline 对延迟敏感
编辑图像的用户期望往返时间低于 5 秒。在 L4 上,1024² 的 30 步 SDXL-Inpaint 需要 3-4 秒,再加上 SAM 遮罩生成(约 200 ms)和 VAE 编解码(合计约 500 ms)。从生产角度看,这是受 TTFT 约束而非吞吐量约束——batch 为 1、低并发、把每个阶段压到最短:
- SAM-H 是慢的那个。 1024² 的 SAM-H 约 200 ms;SAM-ViT-B 约 40 ms,质量损失很小。SAM 2(视频)会引入时序开销;单图编辑不要用它。
- 尽可能跳过编码。
pipe.image_processor.preprocess(img)会编码为潜变量。如果你手上已有上一次生成留下的潜变量(迭代编辑 UI 中很常见),直接通过latents=...传入,省掉一次 VAE 编码。 - 遮罩膨胀也影响吞吐量。 遮罩很小时,U-Net 的大部分前向计算都是浪费的(未遮罩像素反正会被夹住)。
diffusers的StableDiffusionInpaintPipeline无论如何都会跑完整的 U-Net;只有 9 通道的正统修复变体才会利用遮罩计算。 - Flux-Kontext 是 2025 年的答案。 对
(source_image, instruction)做单次前向——不需要单独的遮罩,也不需要 SDEdit 噪声扫描。在 H100 上约 1.5 秒完成一次编辑。架构上的启示是:把各阶段合并起来。
延伸阅读
- Lugmayr et al. (2022). RePaint: Inpainting using Denoising Diffusion Probabilistic Models——免训练图像修复。
- Meng et al. (2022). SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations——SDEdit。
- Brooks, Holynski, Efros (2023). InstructPix2Pix——文本指令编辑。
- Kirillov et al. (2023). Segment Anything——SAM,遮罩的来源。
- Ravi et al. (2024). SAM 2: Segment Anything in Images and Videos——视频 SAM。
- Hertz et al. (2022). Prompt-to-Prompt Image Editing with Cross-Attention Control——注意力层面的编辑。
- Black Forest Labs (2024). Flux.1-Fill and Flux.1-Kontext——2024 年的工具。
示意图共 1 张