问题
生成模型只做一件事:给定从某个未知分布 p_{\text{data}}(x) 中抽取的训练样本,输出看起来像是来自同一分布的新样本。人脸、句子、MIDI 文件、蛋白质结构——眯起眼睛看,都是同一个问题。
难点在于:p_{\text{data}} 所在的空间有数百万维(一张 512x512 的 RGB 图像约 78.6 万维),样本落在这个空间里一层薄薄的流形上,而你大概只有 1000 万个样本。硬算密度毫无希望。每个生成模型都是一种折衷:用一个大难题换一个稍微不那么难的问题。
过去十二年,有五个家族活了下来。知道每个家族做了什么折衷,你就能明白它为什么在某些任务上胜出、在另一些任务上崩溃。
概念
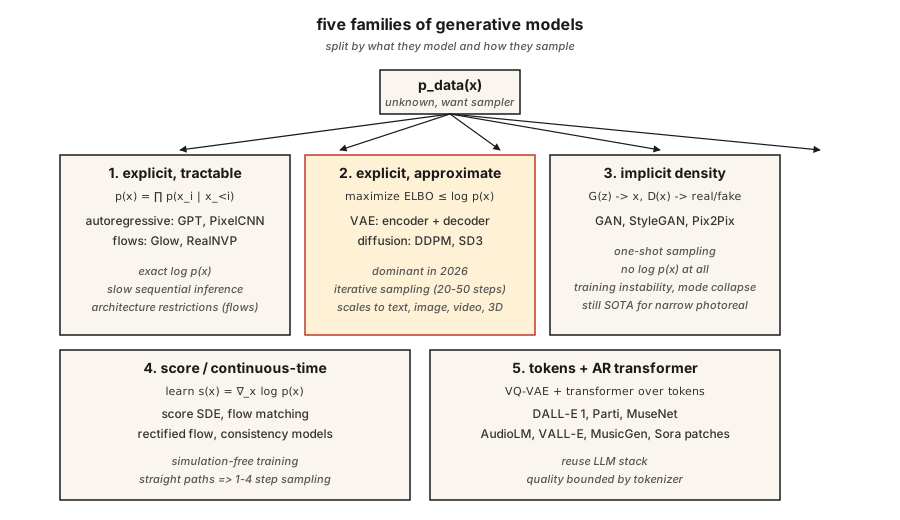
1. 显式密度,可精确计算。 把 \log p(x) 写成一个真的能求和的式子。自回归模型(PixelCNN、WaveNet、GPT)把 p(x) = \prod_i p(x_i \mid x_{<i}) 因子分解。归一化流(RealNVP、Glow)把 p(x) 建成一个简单基分布的可逆变换。优点:精确似然,训练损失干净。缺点:自回归推理是串行的(长序列上很慢),流需要可逆架构(架构限制多)。
2. 显式密度,近似。 从下方界定 \log p(x)(ELBO)并优化这个下界。VAE(Kingma 2013)使用带变分后验的编码器-解码器。扩散模型(DDPM,Ho 2020)训练一个去噪器,它隐式地优化一个加权 ELBO。在 2026 年,扩散是图像、视频和 3D 领域的主导骨干。
3. 隐式密度。 完全跳过密度;学习一个生成样本的生成器 G(z),以及一个分辨真假的判别器 D(x)。这就是 GAN(Goodfellow 2014)。推理快(一次前向传播),但训练出了名地不稳定。即便在 2026 年,StyleGAN 1/2/3 在固定领域(人脸、卧室)的逼真度上仍是 state of the art。
4. 基于分数 / 连续时间。 直接学习对数密度的梯度 \nabla_x \log p(x),即分数。Song 与 Ermon(2019)表明,分数匹配可以把扩散推广到 SDE。流匹配(Lipman 2023)是 2024-2026 年的热门:免模拟训练、路径更直、采样比 DDPM 快 4-10 倍。Stable Diffusion 3、Flux、AudioCraft 2 都使用流匹配。
5. 基于 token 的离散编码自回归。 用 VQ-VAE 或残差量化器把高维数据压缩成一段短的离散 token 序列,再用 Transformer 建模这个 token 序列。Parti、MuseNet、AudioLM、VALL-E 以及 Sora 的 patch tokenizer 都用这条路。这相当于第 1 类加一个学出来的 tokenizer。
简史
| 年份 | 模型 | 为何重要 |
|---|---|---|
| 2013 | VAE (Kingma) | 首个有可用训练损失的深度生成模型。 |
| 2014 | GAN (Goodfellow) | 隐式密度,不依赖似然——样本惊人地锐利。 |
| 2015 | DRAW、PixelCNN | 序列式图像生成。 |
| 2017 | Glow、RealNVP | 可逆流;带深度的精确似然。 |
| 2017 | Progressive GAN | 首批百万像素人脸。 |
| 2019 | StyleGAN / StyleGAN2 | 在单一领域至今难以超越的逼真人脸。 |
| 2020 | DDPM (Ho) | 扩散变得实用。 |
| 2021 | CLIP、DALL-E 1、VQGAN | 文生图进入主流。 |
| 2022 | Imagen、Stable Diffusion 1、DALL-E 2 | 潜在扩散 + 文本条件 = 商品化。 |
| 2022 | ControlNet、LoRA | 对预训练扩散模型的精细控制。 |
| 2023 | SDXL、Midjourney v5、Flow matching | 规模 + 更好的训练动态。 |
| 2024 | Sora、Stable Diffusion 3、Flux.1 | 视频扩散;流匹配胜出。 |
| 2025 | Veo 2、Kling 1.5、Runway Gen-3、Nano Banana | 生产级视频。 |
| 2026 | Consistency + Rectified Flow | 从扩散骨干做一步采样。 |
五问快速判断
当一篇新的生成模型论文出来时,先回答这五个问题,再读方法部分。
- 建模的对象是什么? 像素、latent、离散 token、3D 高斯、mesh,还是波形?
- 密度是显式还是隐式? 他们有没有写出 \log p(x)?
- 采样:一次完成还是迭代? 迭代意味着推理更慢;一次完成通常意味着对抗训练或蒸馏。
- 条件是什么:无条件、类别、文本、图像、姿态? 这决定了损失函数和架构脚手架。
- 评估用什么:FID、CLIP score、IS、人类偏好、任务准确率? 每种都有已知的失效模式(见第 14 课)。
这个阶段的每一课,你都会重新回答这五个问题。到最后,它们会成为你的条件反射。
构建它
这一课的代码是一个轻量可视化:用三种玩具方法(核密度估计、离散直方图,以及一个最近样本的「类 GAN」生成器)从样本中拟合一个一维高斯混合,让你在一个能打印在一屏上的问题里,看清显式密度与隐式密度的区别。
运行 code/main.py。它从双峰高斯混合中抽取 2000 个样本,然后打印:
explicit density (histogram): p(x in [-0.5, 0.5]) ≈ 0.38
approximate density (KDE): p(x in [-0.5, 0.5]) ≈ 0.41
implicit (nearest-sample gen): 20 new samples printed, no p(x)注意:前两种允许你问「这个点有多大概率?」,第三种做不到。这就是显式 vs 隐式的区别,今后每一课都用得上。
使用它
2026 年,什么任务用哪个家族?
| 任务 | 最佳家族 | 理由 |
|---|---|---|
| 逼真人脸,窄领域 | StyleGAN 2/3 | 仍然最锐利,推理最快。 |
| 通用文生图 | 潜在扩散 + 流匹配 | SD3、Flux.1、DALL-E 3。 |
| 快速文生图 | 整流流 + 蒸馏 | SDXL-Turbo、SD3-Turbo、LCM。 |
| 文生视频 | 扩散 Transformer + 流匹配 | Sora、Veo 2、Kling。 |
| 语音 + 音乐 | 基于 token 的自回归(AudioLM、VALL-E、MusicGen)或流匹配(AudioCraft 2) | 离散 token 的扩展成本低。 |
| 3D 场景 | 高斯 Splatting 拟合,扩散先验 | 3D-GS 做重建,扩散做新视角。 |
| 密度估计(不采样) | 流 | 唯一能给出精确 \log p(x) 的家族。 |
| 模拟 / 物理 | 流匹配、分数 SDE | 直线路径,光滑向量场。 |
交付它
保存为 outputs/skill-model-chooser.md。
这个 skill 接收任务描述,输出:(1) 该用哪个家族;(2) 三个开源选项和三个托管选项的排名列表;(3) 你应当留意的可能失效模式;(4) 算力/时间预算。
练习
- 简单。 对以下五个产品,识别其家族和骨干:ChatGPT image、Midjourney v7、Sora、Runway Gen-3、ElevenLabs。证据应来自公开技术报告。
- 中等。 你明天要读的论文声称采样比扩散快 100 倍。写下三个问题,检验这个加速在带条件和高分辨率下是否依然成立。
- 困难。 选一个你关心的领域(如蛋白质结构、CAD、分子、轨迹)。对当前该领域的 SOTA 模型回答五问,并画出更好的模型会改变什么。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Generative model | 「它能造新东西」 | 学习 p_{\text{data}}(x) 的采样器,可选地暴露 \log p(x)。 |
| Explicit density | 「你能算它」 | 模型给出闭式或可计算的 \log p(x)。 |
| Implicit density | 「GAN 那一派」 | 只有采样器——无法评估某个点的 p(x)。 |
| ELBO | 「证据下界」 | \log p(x) 的可计算下界;VAE 和扩散都在优化它。 |
| Score | 「对数密度的梯度」 | \nabla_x \log p(x);扩散和 SDE 模型学习这个场。 |
| Manifold hypothesis | 「数据住在一个曲面上」 | 高维数据集中在一个低维流形上;降维之所以有效的原因。 |
| Autoregressive | 「预测下一块」 | 把联合分布因子化为条件概率的乘积。 |
| Latent | 「压缩后的编码」 | 一种低维表示,解码器能从中重建输入。 |
生产说明:五类模型,五种推理形态
每个家族对应不同的推理服务器成本曲线。生产推理文献把 LLM 推理描述为 prefill + decode;同样的分解在这里也适用:
- 自回归(第 1、5 类)。 串行 decode 主导延迟;KV-cache、continuous batching 和投机解码都可直接套用。
- VAE / 扩散 / 流匹配(第 2、4 类)。 没有 LLM 意义上的 decode。成本 =
num_steps × step_cost,而step_cost是一次在全分辨率 latent 上的 transformer 或 U-Net 前向。生产上的旋钮是步数(DDIM / DPM-Solver / 蒸馏)、batch size 和精度(bf16 / fp8 / int4)。 - GAN(第 3 类)。 一次前向传播。没有调度表,没有 KV-cache。TTFT ≈ 总延迟。这就是为什么 StyleGAN 在窄领域 UX 上仍然胜出。
当你在论文摘要里看到「比扩散更快」,把它翻译成「步数更少 × 同样的步成本」或「同样的步数 × 更低的步成本」。其余都是营销。
延伸阅读
- Goodfellow 等(2014)。Generative Adversarial Nets — GAN 原始论文。
- Kingma & Welling(2013)。Auto-Encoding Variational Bayes — VAE 原始论文。
- Ho, Jain, Abbeel(2020)。Denoising Diffusion Probabilistic Models — DDPM 论文。
- Song 等(2021)。Score-Based Generative Modeling through SDEs — 把扩散看作 SDE。
- Lipman 等(2023)。Flow Matching for Generative Modeling — 流匹配论文。
- Esser 等(2024)。Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — Stable Diffusion 3。
示意图共 1 张